Estadística aplicada con R

Módulo 5: Otros métodos estadísticos

Mauricio Moreno, PhD

Regresión lineal múltiple

Introducción

  • Es una extensión de la regresión lineal (simple) con la que concluimos el módulo anterior.

  • Es usada para predecir una sola variable continua (y) en función de múltiples predictores continuos (un set de variables X).

  • Tiene prácticamente los mismos supuestos que la regresión lineal simple:

    • Linearidad de los predictores

    • Homogeneidad de la varianza (homocedasticidad)

    • Independencia de los errores (residuos)

    • Normalidad de los residuos

    • Independencia de los predictores

  • Un ejemplo de una regresión múltiple podría expresarse mediante la siguiente ecuación

\[\begin{align} y &= \beta_0 + \beta_1\,X_1 + \beta_2\,X_2 \dots \beta_n\,X_n \end{align}\]

Pasos para una regresión múltiple

  • A diferencia de la regresión lineal simple, no existe un proceso estructurado de pasos a seguir en el caso de su extensión a dos o más variables continuas como predictores.

  • El llegar a un modelo apropiado se convierte en lo que algunos estadísticos llaman el “arte de modelar”.

  • En las siguientes diapositivas voy a presentar la manera en que usualmente hago este tipo de modelos y que resumiré en:

    1. Empezar por lo que se le conoce como un modelo completo (incluyendo todas las variables continuas disponibles).

    2. Realizar una selección automática de variables sobre el modelo del paso 1.

    3. Checar manualmente por colinearidad entre las variables del modelo resultante del paso 2.

    4. Revisar si las variables incluidas tienen sentido (biológico),

    5. Checar los supuestos de normalidad y homocedasticidad.

    6. Realizar transformaciones de ser necesario.

    7. Interpretar resultados.

  • Estos pasos no representan una sucesión. Dependiendo del problema, quizá ni siquiera sirvan y sus análisis estarán de la mano de más de su buen entendimiento de los datos y los fenómenos que deseen explicar.

Datos que usaremos

  • Usaremos los datos de rotavirus en Berlin del archivo de Excel “rotXLS.xlsx” que contiene información sobre el conteo de casos de rotavirus en Berlín desde el año 2001 hasta el 2020.

  • Supongámos que queremos modelar la variable cases en función de todas las variables metereológicas a nuestra disposición. Para esto, recordemos la descripción de esta tabla de datos

  • date: fecha de cierre de la toma de datos

  • cases: número de casos de rotavirus en la semana

  • week: semana epidemiológica

  • incidence: número de casos/100000 habitantes

  • FM: media diaria de velocidad del viento (m/s)

  • RSK: media diaria de lluvia (mm)

  • SHK_TAG: media diaria de nieve (cm)

  • PM: media diaria de presión atmosférica (hPa)

  • TMK: media diaria de temperatura (°C)

  • TXK: media diaria de temperatura máxima (°C)

  • TNK: media diaria de temperatura mínima (°C)

  • UPM: media diaria de humedad relativa (%)

  • Sin embargo, antes de continuar, debemos hacer un preprocesamiento de datos ya que en la estructura original de estos se considera un efecto temporal dado por los años. Para simplificarlo, agruparemos los datos por meses y semanas epidemiológicas.

Preprocesamiento de datos

  • Asegúrate de tener instaladas las librerías dplyr y lubridate antes de correr este código
library(dplyr)
library(readxl)
library(lubridate)
rot_berlin <- read_excel("rotXLS.xlsx")
rot_berlin$month <- month(rot_berlin$date)
rot_berlin <- rot_berlin %>%
  group_by(month, week) %>%
  summarise(incidence = mean(incidence),
            cases = round(mean(cases),0),
            FM = mean(FM),
            RSK = mean(RSK),
            SHK_TAG = mean(SHK_TAG),
            PM = mean(PM),
            TMK = mean(TMK),
            TXK = mean(TXK),
            TNK = mean(TNK),
            UPM = mean(UPM))
rot_berlin$month <- as.factor(rot_berlin$month)
rot_berlin$week <- as.factor(rot_berlin$week)

Modelo completo

  • Empezaremos formulando un modelo completo para estos datos de la siguiente manera:
lm1 <- lm(cases ~ FM + RSK + SHK_TAG + PM + TMK + TXK + TNK + UPM, data = rot_berlin)
  • En la función lm se pueden incluir términos de órdenes superiores (interacciones, cuadrados, cubos, etc) con variables continuas.

  • Por simplicidad, únicamente consideraremos predictores de primer orden.

  • Además que para modelos no lineales es mejor usar funciones adecuadas (lm estima los parámetros usando el algoritmo de máxima probabilidad y puede simplemente no servir).

Selección de variables

  • La selección automática de variables funciona con un algoritmo relativamente sencillo:

    • Retira una variable a la vez del modelo, calcula un criterio de comparación y repite el proceso

    • Usa ese criterio de comparación con respecto a un modelo nulo (sin ningún predictor) y devuelve el modelo que haya obtenido la mejor valoración.

  • El criterio de evaluación más usado para comparar modelos es el denominado criterio de información de Akaike (AIC), y es un estimador del error de predicción. Mientras menos sea el valor de AIC, mejores las predicciones que un modelo teoricamente será capaz de realizar.

  • Realizamos la selección de variables antes de cualquier diagnóstico o transformación ya que a veces estas últimas “exageran” la importancia de las variables en el caso de hacer la selección después.

  • La manera más sencilla de hacer una selección de variables es usando la función base de R step

step(lm1)

Selección de variables

step(lm1)
Start:  AIC=372.26
cases ~ FM + RSK + SHK_TAG + PM + TMK + TXK + TNK + UPM

          Df Sum of Sq   RSS    AIC
- TNK      1       2.8 15135 370.27
- RSK      1      18.7 15151 370.34
- SHK_TAG  1      42.4 15175 370.44
<none>                 15132 372.26
- FM       1     658.0 15790 373.03
- TMK      1     830.7 15963 373.74
- PM       1     887.1 16019 373.97
- TXK      1    1259.3 16392 375.46
- UPM      1    3660.8 18793 384.35

Step:  AIC=370.27
cases ~ FM + RSK + SHK_TAG + PM + TMK + TXK + UPM

          Df Sum of Sq   RSS    AIC
- RSK      1      17.7 15153 368.35
- SHK_TAG  1      60.8 15196 368.53
<none>                 15135 370.27
- FM       1     697.7 15833 371.20
- PM       1     889.7 16025 371.99
- TXK      1    1888.5 17024 375.92
- TMK      1    4107.8 19243 383.88
- UPM      1    5612.2 20747 388.78

Step:  AIC=368.35
cases ~ FM + SHK_TAG + PM + TMK + TXK + UPM

          Df Sum of Sq   RSS    AIC
- SHK_TAG  1      57.9 15211 366.60
<none>                 15153 368.35
- FM       1     683.9 15837 369.22
- PM       1     926.0 16079 370.21
- TXK      1    2063.6 17216 374.65
- TMK      1    4347.8 19501 382.75
- UPM      1    5962.0 21115 387.92

Step:  AIC=366.6
cases ~ FM + PM + TMK + TXK + UPM

       Df Sum of Sq   RSS    AIC
<none>              15211 366.60
- FM    1     698.0 15909 367.51
- PM    1    1160.5 16371 369.38
- TXK   1    2076.5 17287 372.92
- TMK   1    4423.5 19634 381.19
- UPM   1    5958.9 21169 386.09

Call:
lm(formula = cases ~ FM + PM + TMK + TXK + UPM, data = rot_berlin)

Coefficients:
(Intercept)           FM           PM          TMK          TXK          UPM  
   2503.898       -7.526       -2.219      -19.360       12.304       -2.425  

Multicolinearidad

  • De acuerdo a la selección automática, nuestro modelo sería hasta el momento:
cases ~ FM + PM + TMK + TXK + UPM
  • Ningún método de selección de variables automático es perfecto.

  • En este caso, aunque obvio, sabemos que las variables TMK y TXK deben estar correlacionadas al ser medidas de temperatura correspondientes al mismo día.

  • Bien podríamos deshechar una de las dos, pero cuando no sabemos la naturaleza de las variables, es mejor llevar a cabo un análisis de correlación antes de checar el modelo por sus supuestos.

  • En el módulo de AED ya hicimos una primera aproximación con las matrices de dispersión. Sin embargo, en ellas solo vimos el coeficiente de correlación junto al código de significancia.

  • Para estar seguros de que eliminaremos variables correctamente, es mejor dar un vistazo a las matrices de correlación directamente.

Matrices de correlación

  • Para calcular la matriz de correlación de un conjunto de datos usaremos la librería Hmisc
library(Hmisc)
matriz <- rcorr(as.matrix(rot_berlin[,c(5, 8, 9, 10, 12)]))
matriz
       FM    PM   TMK   TXK   UPM
FM   1.00 -0.38 -0.67 -0.66  0.22
PM  -0.38  1.00  0.14  0.14 -0.02
TMK -0.67  0.14  1.00  1.00 -0.65
TXK -0.66  0.14  1.00  1.00 -0.70
UPM  0.22 -0.02 -0.65 -0.70  1.00

n= 65 


P
    FM     PM     TMK    TXK    UPM   
FM         0.0019 0.0000 0.0000 0.0824
PM  0.0019        0.2768 0.2771 0.8562
TMK 0.0000 0.2768        0.0000 0.0000
TXK 0.0000 0.2771 0.0000        0.0000
UPM 0.0824 0.8562 0.0000 0.0000       
  • En este paso, recomiendo el mirar por fuera de la diagonal y eliminar del análisis una variable de cualquier par que tenga un coeficiente de correlación exactamente igual a 1. En este caso, eliminaré TMK

¿Tiene todo esto sentido?

  • Hasta aquí, nuestro modelo candidato sería el siguiente
cases ~ FM + PM + TXK + UPM
  • Los algoritmos usados aplican criterios estadísticos, no biológicos (o generalizando, del problema en cuestión)

  • Considerando que el rotavirus se contagia principalmente por contacto directo o indirecto con heces fecales de alguien infectado ¿tiene sentido mantener las variables FM (velocidad media diaria del viento) y PM (presión atmosférica media diaria) como parte del modelo?

  • Personalmente, pienso que no. Para mí, el modelo candidato sería el siguiente

lm2 <- lm(cases ~ TXK + UPM, data = rot_berlin)

Diagnósticos de la regresión múltiple
  • Una vez que tengo definido mi modelo candidato lo pondré a prueba de los supuestos:
lm2 <- lm(cases ~ TXK + UPM, data = rot_berlin)
  • Vamos a introducir otra librería muy útil cuando nos encontramos ante modelos de múltiples variables: performance.

  • performance nos ofrece la posibilidad de chequear dos diagnósticos adicionales:

    • La predicción del modelo (basándose en una aproximación Bayesiana)

    • La colinearidad

  • También se lo puede utilizar para modelos univariables (como la regresión lineal).

library(performance)
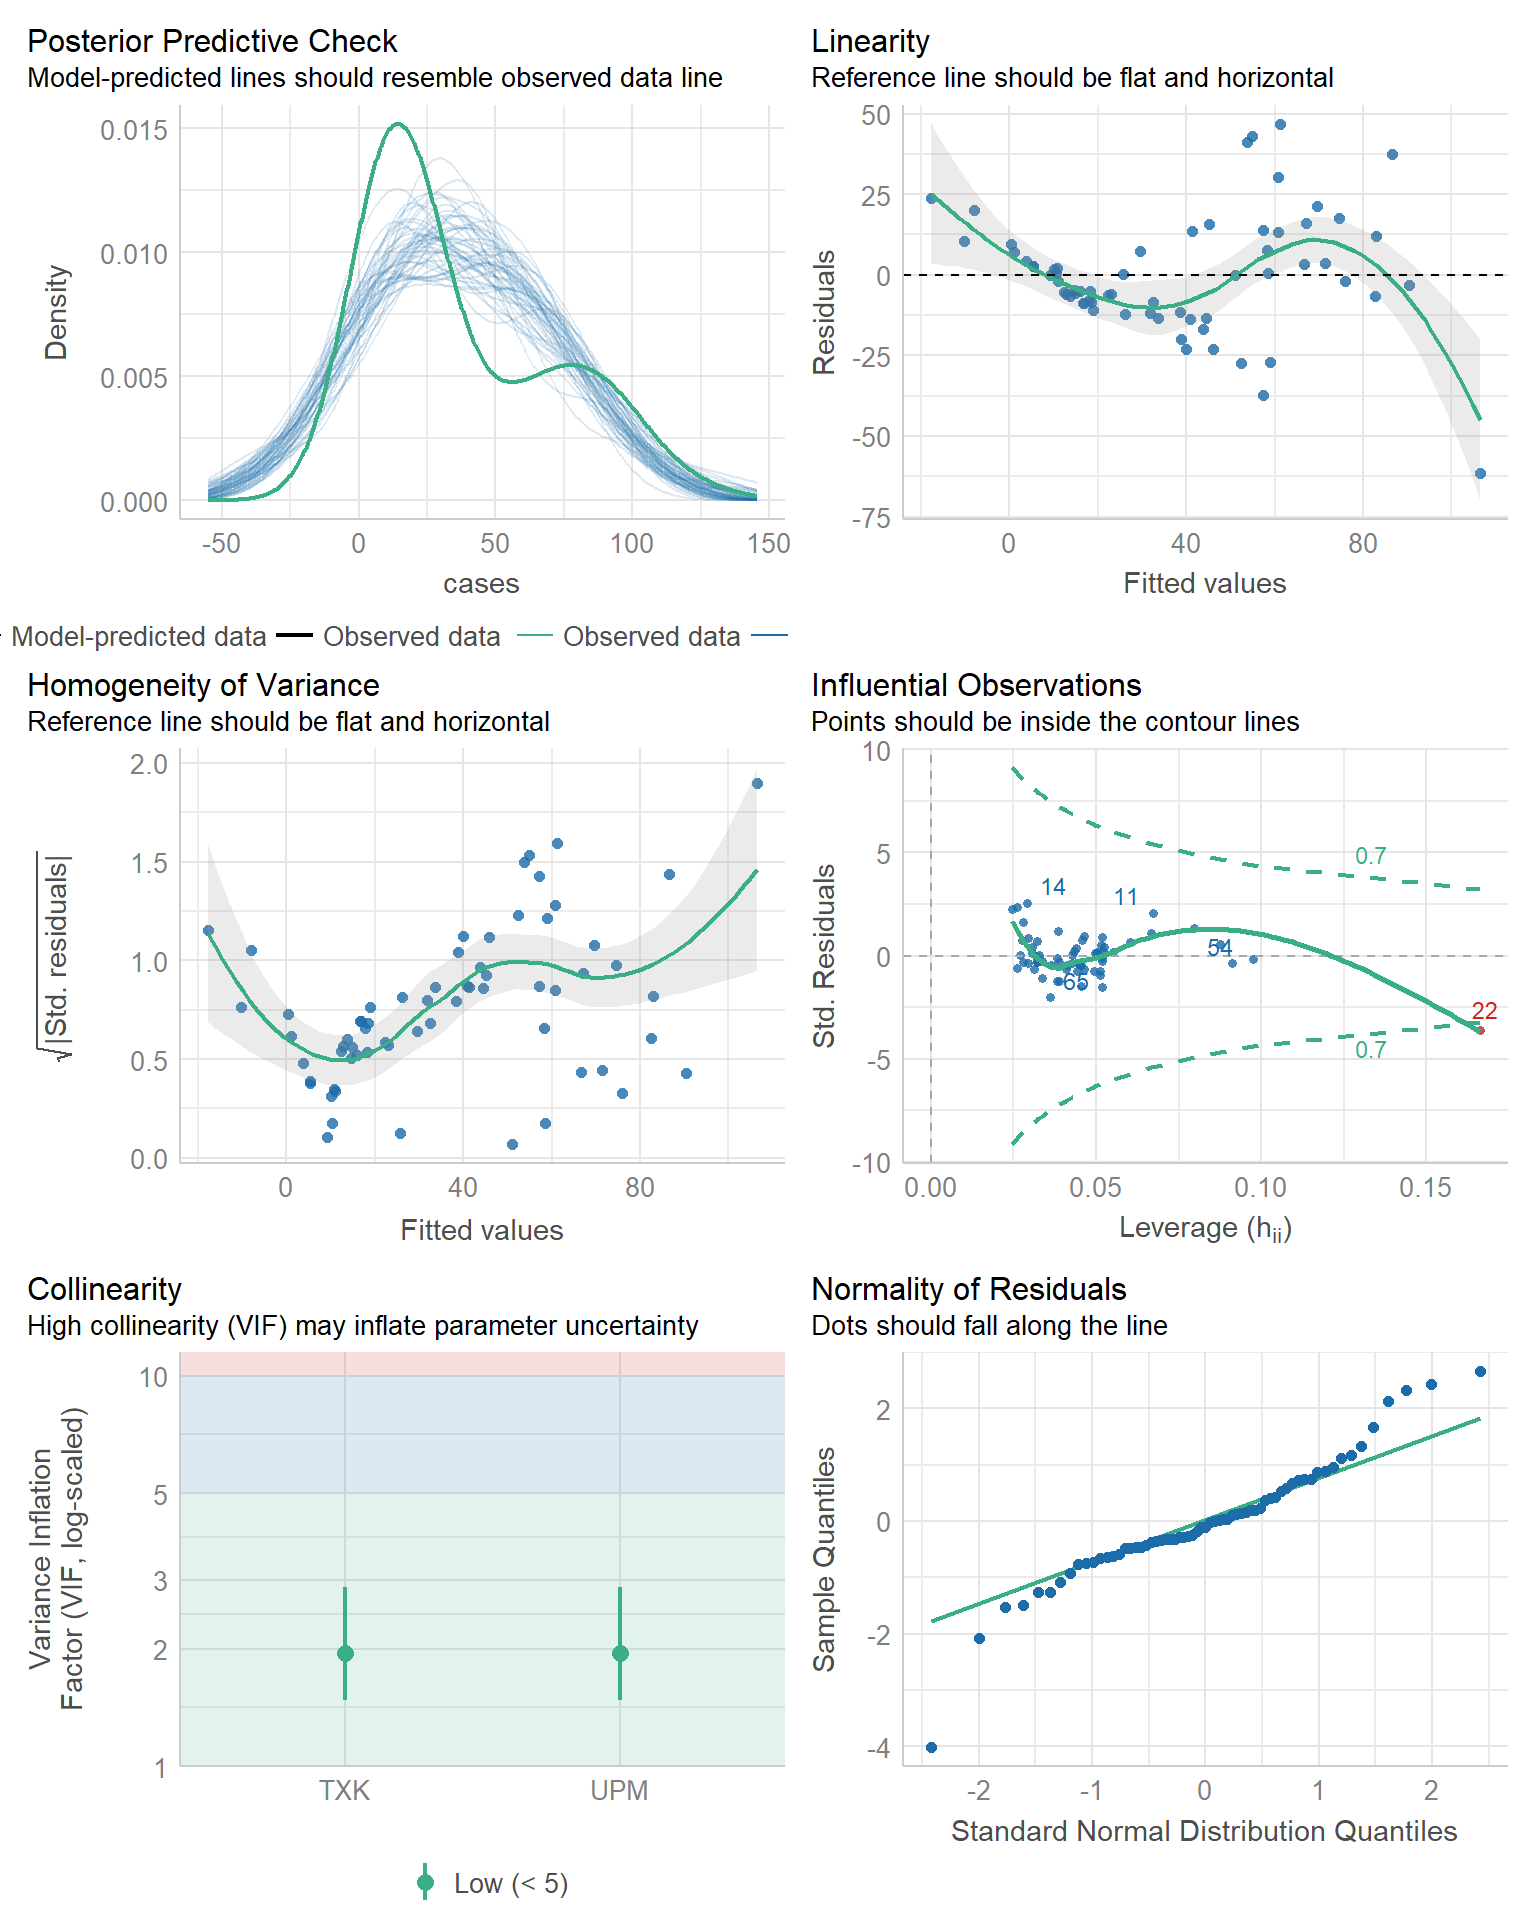
check_model(lm2)

Diagnósticos de la regresión múltiple

Diagnósticos de la regresión múltiple

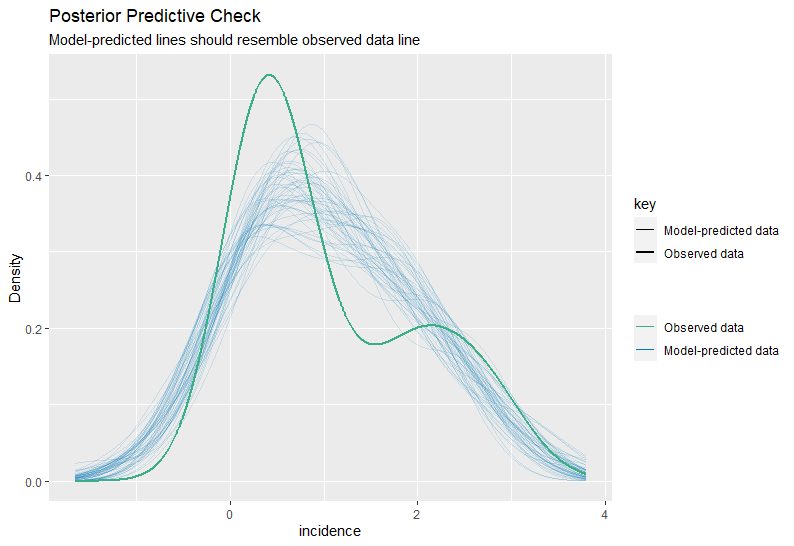
Chequeo de la predicción posterior

Este gráfico contrapone la densidad de la distribución de la variable de respuesta con las densidades de las predicciones obtenidas del modelo mediante un proceso de sampleo Bayesiano (por eso apreciamos varias líneas azules). Nos da una idea de qué tan adecuado es nuestro modelo para predecir los valores observados. Idealmente estas dos deberían superponerse.

Diagnósticos de la regresión múltiple
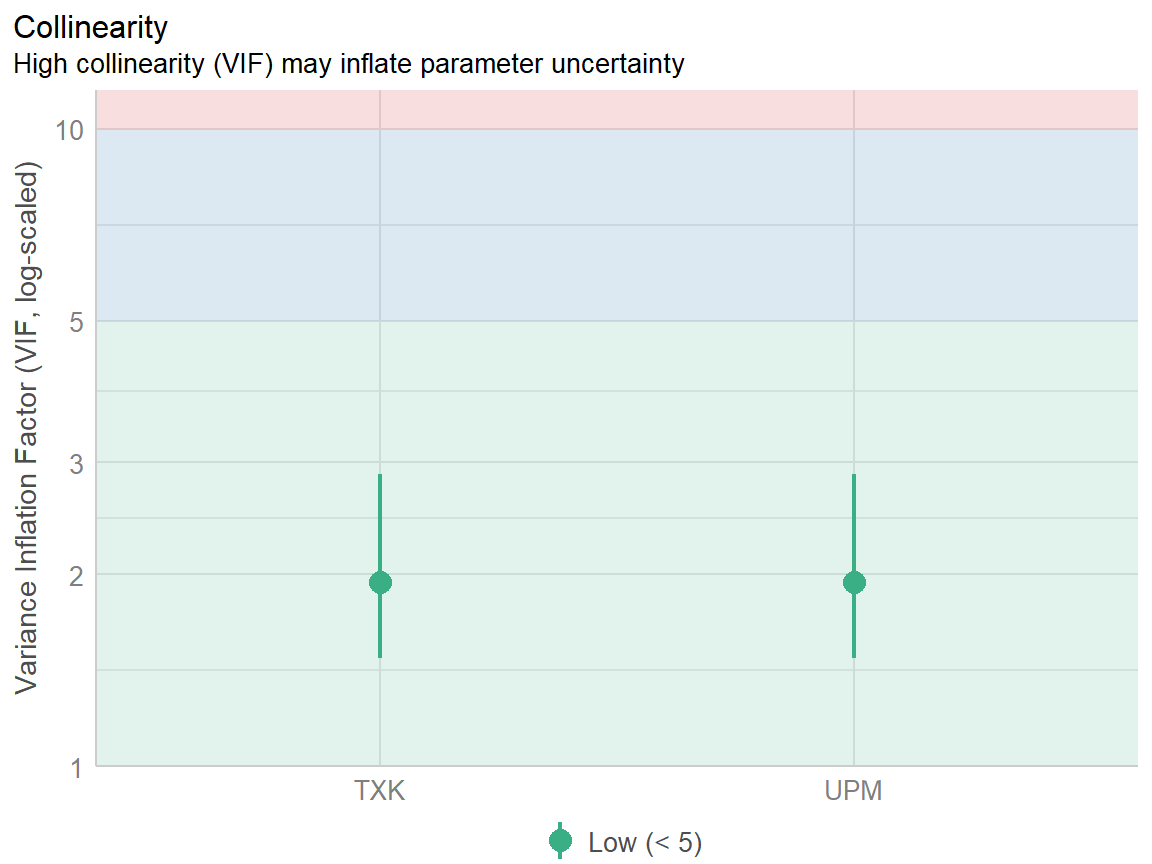
Chequeo de la colinearidad

Aquí vemos distribuidas en el eje X cada una de las variables que estamos usando como predictores mientras que en el eje Y tenemos el factor de inflación de la varianza (VIF) que cada una de estas contribuye al modelo. Nos da una idea de que variables podríamos eliminar basados en mantener únicamente variables independientes entre sí como predictores.

Transformaciones
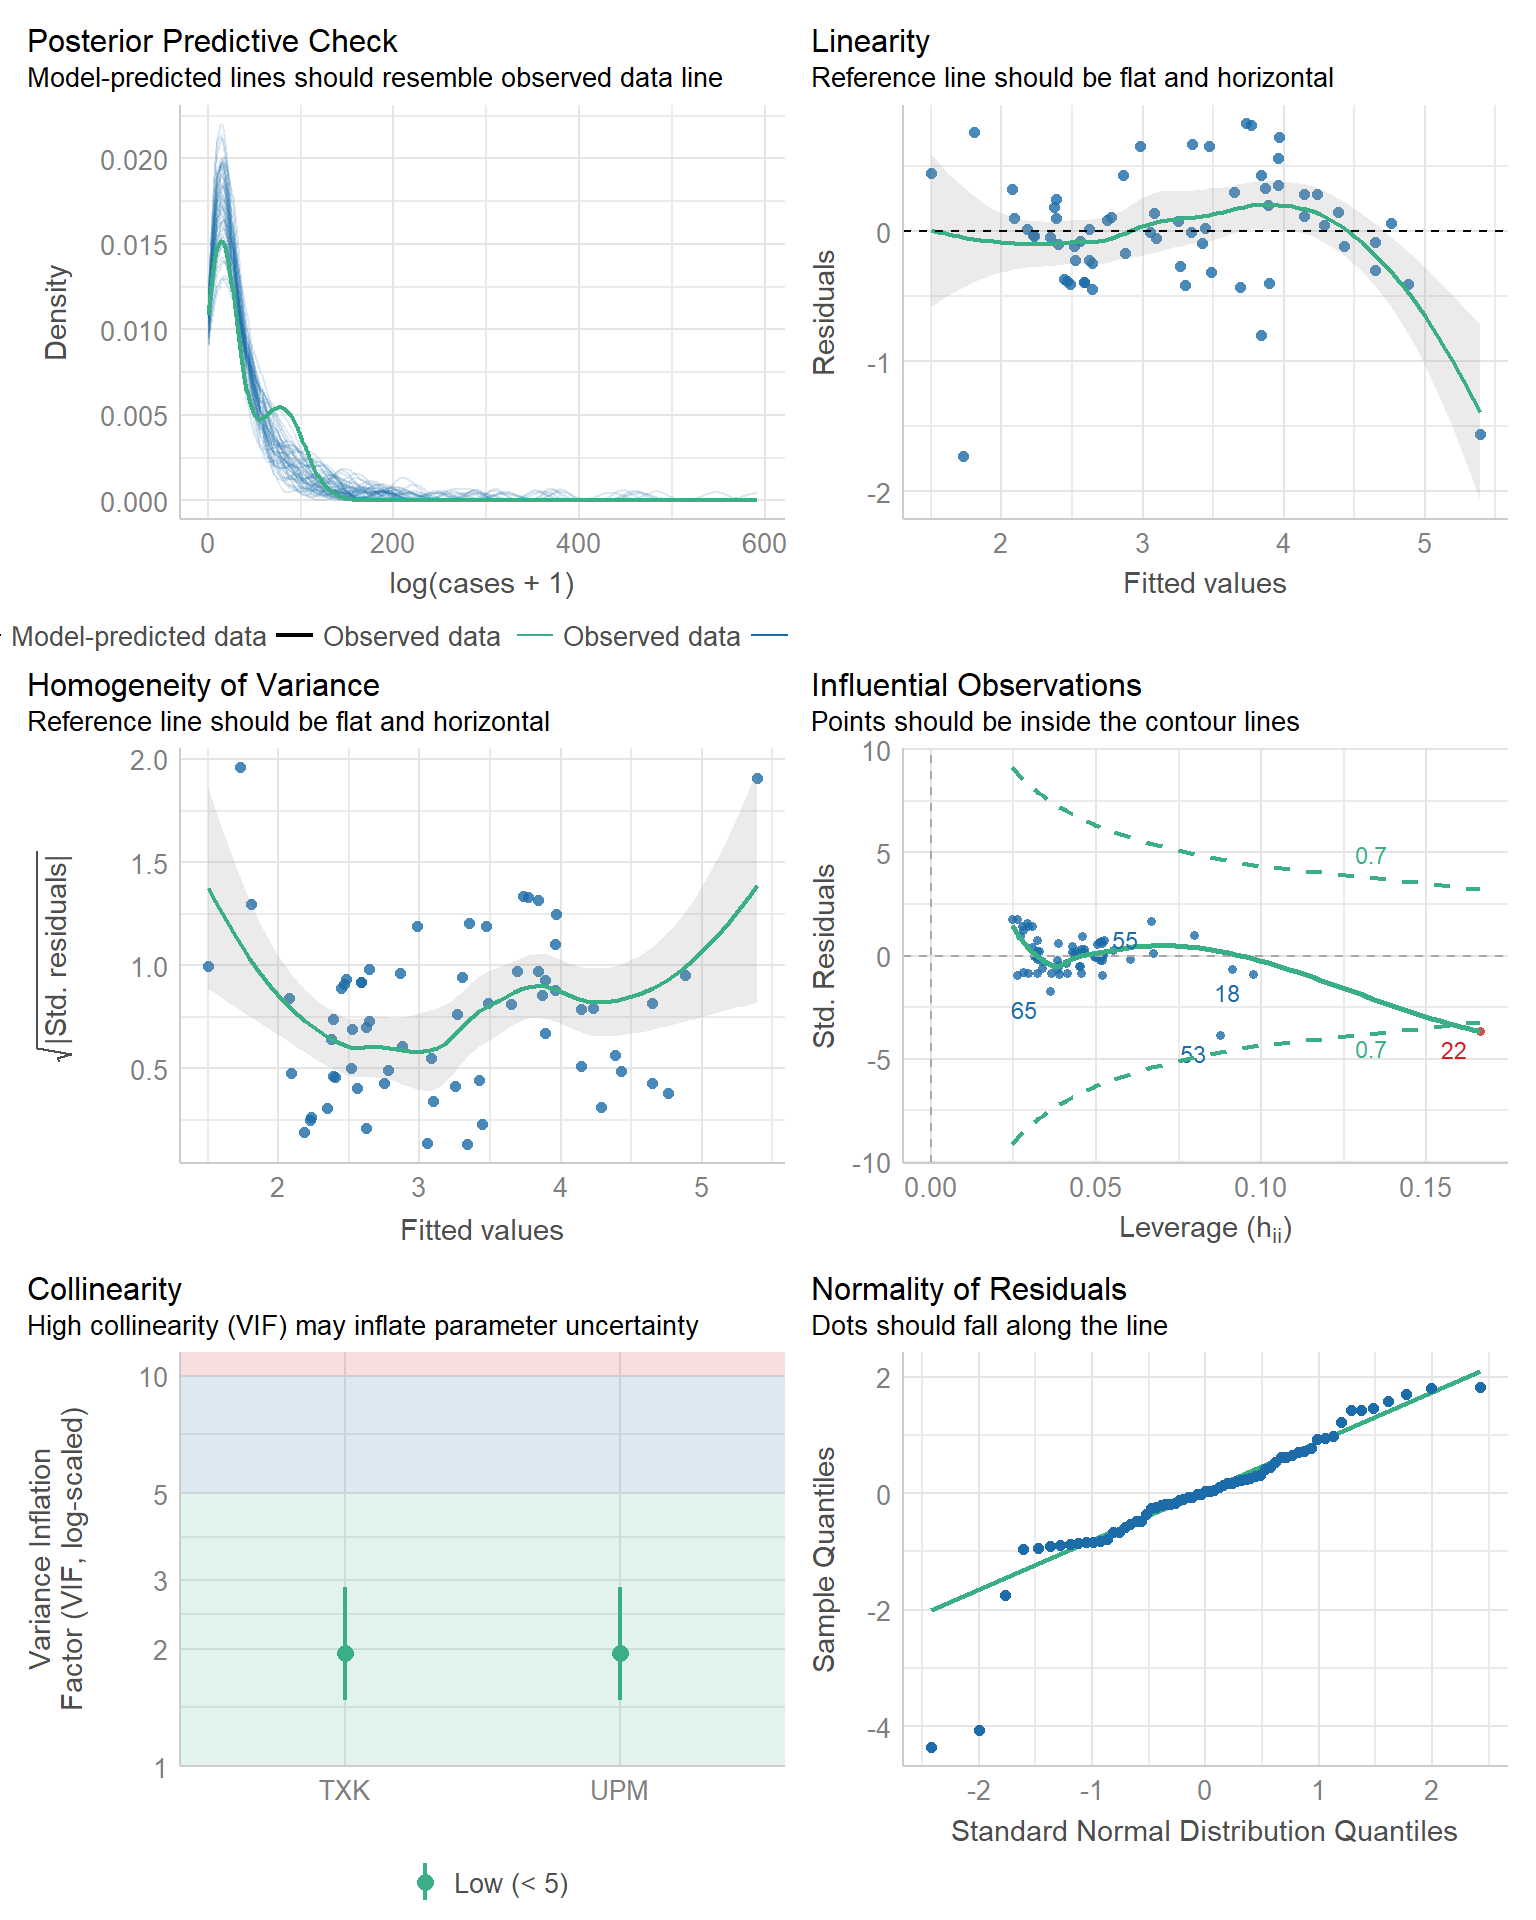
  • Del gráfico de la predicción posterior evidenciamos que los datos observados de incidencia de rotavirus son asimétricos hacia la izquierda (o asimetría positiva).

  • Usualmente la transformación que mejor funciona en este caso es el logaritmo natural (de hecho el resto de datos que hemos usado en el curso coincidentalmente han presentado el mismo tipo de asimetría).

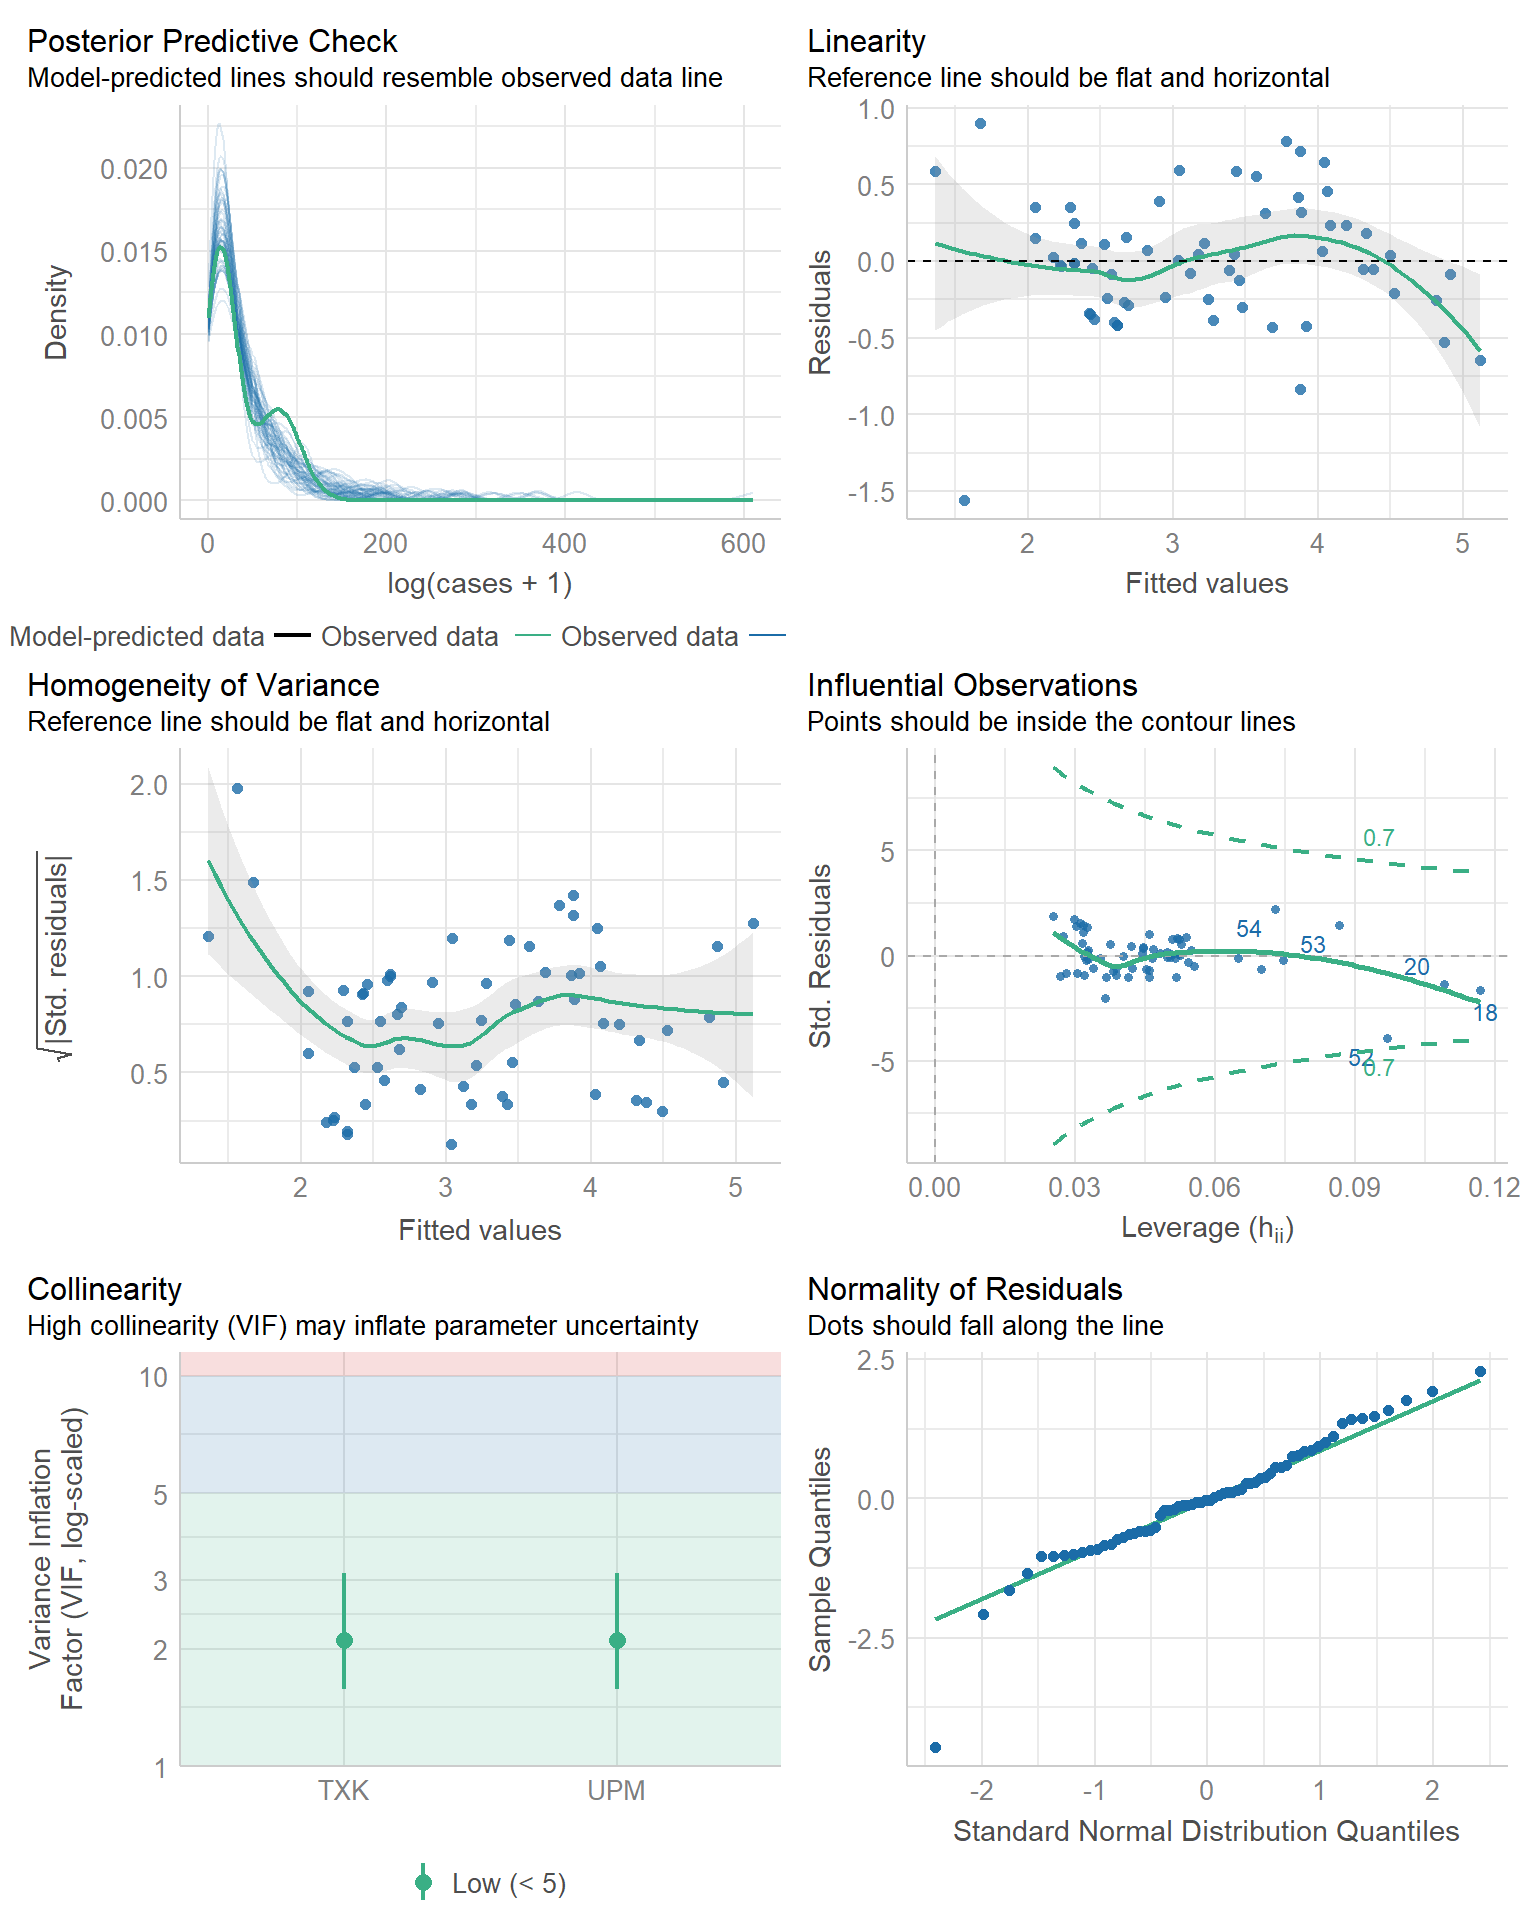
lm3 <- lm(log(cases + 1) ~ TXK + UPM, data = rot_berlin)
check_model(lm3)

Transformaciones

Removiendo outliers

  • La distancia de Cook nos ha ayudado a identificar una observación claramente influyente.

  • Para continuar, removeremos esa observación para ver que tanto ayuda a nuestro análisis.

rot_berlin_out <- rot_berlin[-22, ]
lm4 <- lm(log(cases + 1) ~ TXK + UPM, data = rot_berlin_out)
check_model(lm4)

Removiendo outliers

Modelo final

  • Una vez que hemos llegado a nuestro modelo, revisamos los resultads (este paso lo pudimos hacer en cada paso)
summary(lm4)

Call:
lm(formula = log(cases + 1) ~ TXK + UPM, data = rot_berlin_out)

Residuals:
     Min       1Q   Median       3Q      Max 
-1.56135 -0.25645 -0.01463  0.23747  0.89716 

Coefficients:
             Estimate Std. Error t value Pr(>|t|)    
(Intercept) 15.115325   0.785118   19.25   <2e-16 ***
TXK         -0.156583   0.009426  -16.61   <2e-16 ***
UPM         -0.126306   0.008891  -14.21   <2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 0.4208 on 61 degrees of freedom
Multiple R-squared:  0.8241,    Adjusted R-squared:  0.8184 
F-statistic: 142.9 on 2 and 61 DF,  p-value: < 2.2e-16

Interpretación


Call:
lm(formula = log(cases + 1) ~ TXK + UPM, data = rot_berlin_out)

Residuals:
     Min       1Q   Median       3Q      Max 
-1.56135 -0.25645 -0.01463  0.23747  0.89716 

Coefficients:
             Estimate Std. Error t value Pr(>|t|)    
(Intercept) 15.115325   0.785118   19.25   <2e-16 ***
TXK         -0.156583   0.009426  -16.61   <2e-16 ***
UPM         -0.126306   0.008891  -14.21   <2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 0.4208 on 61 degrees of freedom
Multiple R-squared:  0.8241,    Adjusted R-squared:  0.8184 
F-statistic: 142.9 on 2 and 61 DF,  p-value: < 2.2e-16
  • Haremos uso nuevamente de la librería ggeffects para lidiar con la retransformación y ggplot2 junto a patchwork para graficar las predicciones.
library(ggeffects)
library(ggplot2)
library(patchwork)
predicciones <- ggpredict(lm4)
predicciones[[1]]
# Predicted values of cases

TXK | Predicted |           95% CI
----------------------------------
  0 |    243.15 | [180.49, 327.44]
  5 |    110.59 | [ 89.35, 136.83]
 10 |     50.01 | [ 43.45,  57.53]
 15 |     22.31 | [ 19.98,  24.90]
 20 |      9.66 | [  8.22,  11.32]
 25 |      3.87 | [  2.91,   5.07]
 30 |      1.23 | [  0.64,   2.03]

Adjusted for:
* UPM = 76.14
predicciones[[2]]
# Predicted values of cases

UPM | Predicted |           95% CI
----------------------------------
 60 |    186.40 | [137.04, 253.40]
 65 |     98.65 | [ 78.63, 123.71]
 70 |     51.99 | [ 44.54,  60.67]
 75 |     27.18 | [ 24.32,  30.37]
 80 |     13.99 | [ 12.22,  15.99]
 85 |      6.97 | [  5.59,   8.63]
 90 |      3.24 | [  2.24,   4.54]
 95 |      1.25 | [  0.59,   2.20]

Adjusted for:
* TXK = 14.71
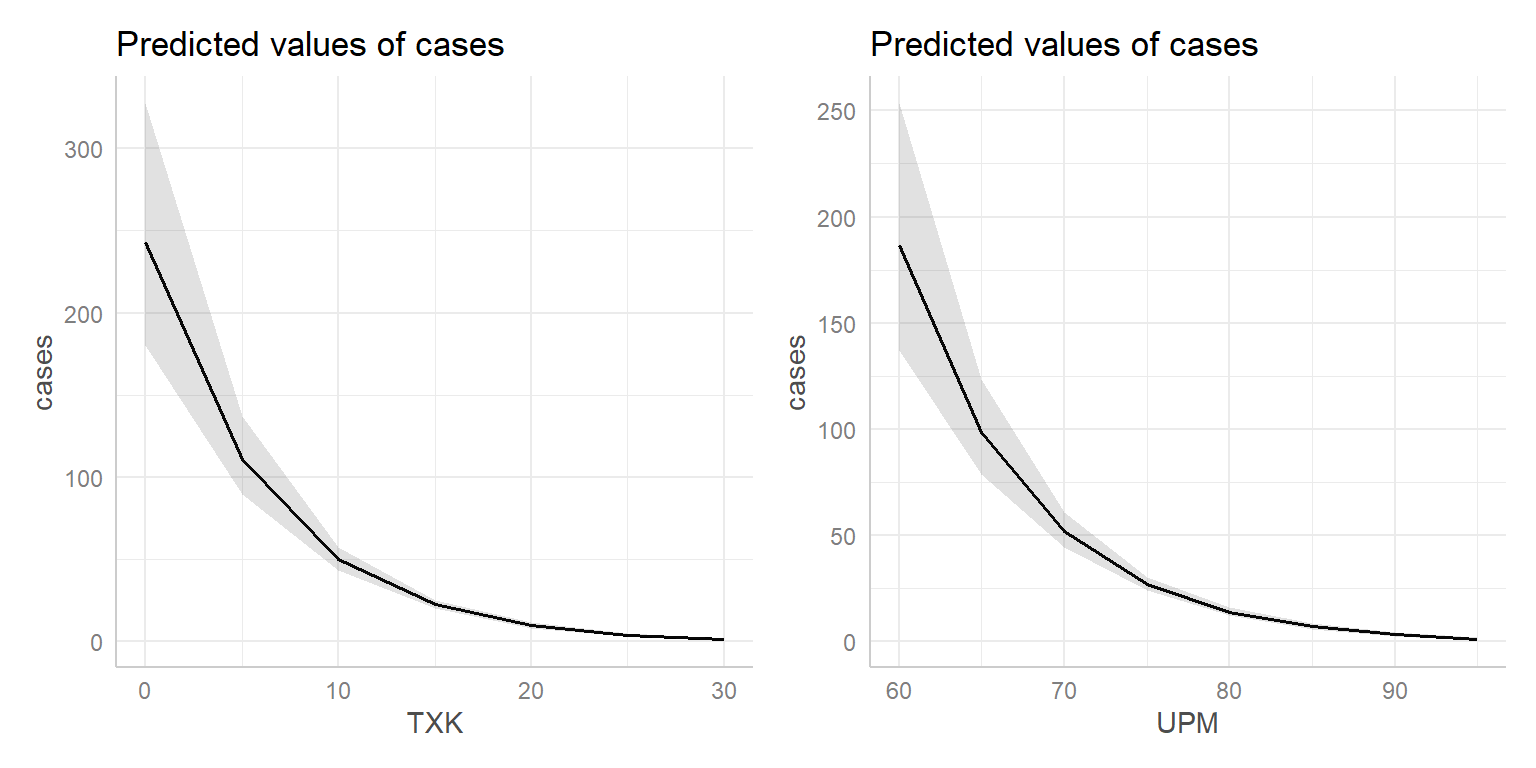
p1 <- predicciones[[1]]
p2 <- predicciones[[2]]
plot(p1) + plot(p2)

Ejercicio 5.1

  • Realiza un modelo de regresión lineal múltiple para los mismos datos que acabas de ver siguiendo tu propia iniciativa:

    • Puedes cambiar el orden de los pasos que sugerí

    • Realizar chequeos de la significancia de los coeficientes de los modelos candidatos entre paso y paso (cosa que yo no hice)

    • Puedes llevar a cabo una selección de variables manual, o cambiar el argumento direction de la función step por “forward” o “backward”

Antes de continuar

Sobre el \(R^2\) de nuevo

  • Como mencioné al final del anterior módulo, el coeficiente de determinación es una métrica mal usada.

  • Mediante la función compare_performance de la librería performance, se puede obtener un gráfico de telarañas que permite ver como el \(R^2\) no sirve de nada ante modelos mejor formulados.

  • Ahora recordemos que al final eliminamos un outlier con el modelo que mejores diagnósticos terminamos. Para poner a todos los modelos candidatos en igualdad de condiciones, los corremos de nuevo sin ese outlier (además de utilizar una variable previamente transformada para los modelos 3 y 4, ya que performance no es capaz de retransformar por si solo)

rot_berlin$cases_comp <- rot_berlin$cases + 1
rot_berlin_out$cases_comp <- rot_berlin_out$cases + 1
lm1.1 <- lm(cases ~ FM + RSK + SHK_TAG + PM + TMK + TXK + TNK + UPM, data = rot_berlin_out)
lm2.1 <- lm(cases ~ TXK + UPM, data = rot_berlin_out)
lm3.1 <- lm(log(cases_comp) ~ TXK + UPM, data = rot_berlin_out)
lm4.1 <- lm(log(cases_comp) ~ TXK + UPM, data = rot_berlin_out)

compare_performance(lm1.1, lm2.1, lm3.1, lm4.1, rank = T)
# Comparison of Model Performance Indices

Name  | Model |    R2 | R2 (adj.) |   RMSE |  Sigma | AIC weights | AICc weights | BIC weights | Performance-Score
------------------------------------------------------------------------------------------------------------------
lm3.1 |    lm | 0.824 |     0.818 |  0.411 |  0.421 |       0.500 |        0.500 |       0.500 |            94.93%
lm4.1 |    lm | 0.824 |     0.818 |  0.411 |  0.421 |       0.500 |        0.500 |       0.500 |            94.93%
lm1.1 |    lm | 0.847 |     0.825 | 12.989 | 14.011 |    7.53e-11 |     1.33e-11 |    1.16e-13 |            33.96%
lm2.1 |    lm | 0.759 |     0.751 | 16.341 | 16.738 |    1.26e-14 |     1.26e-14 |    1.26e-14 |             0.00%
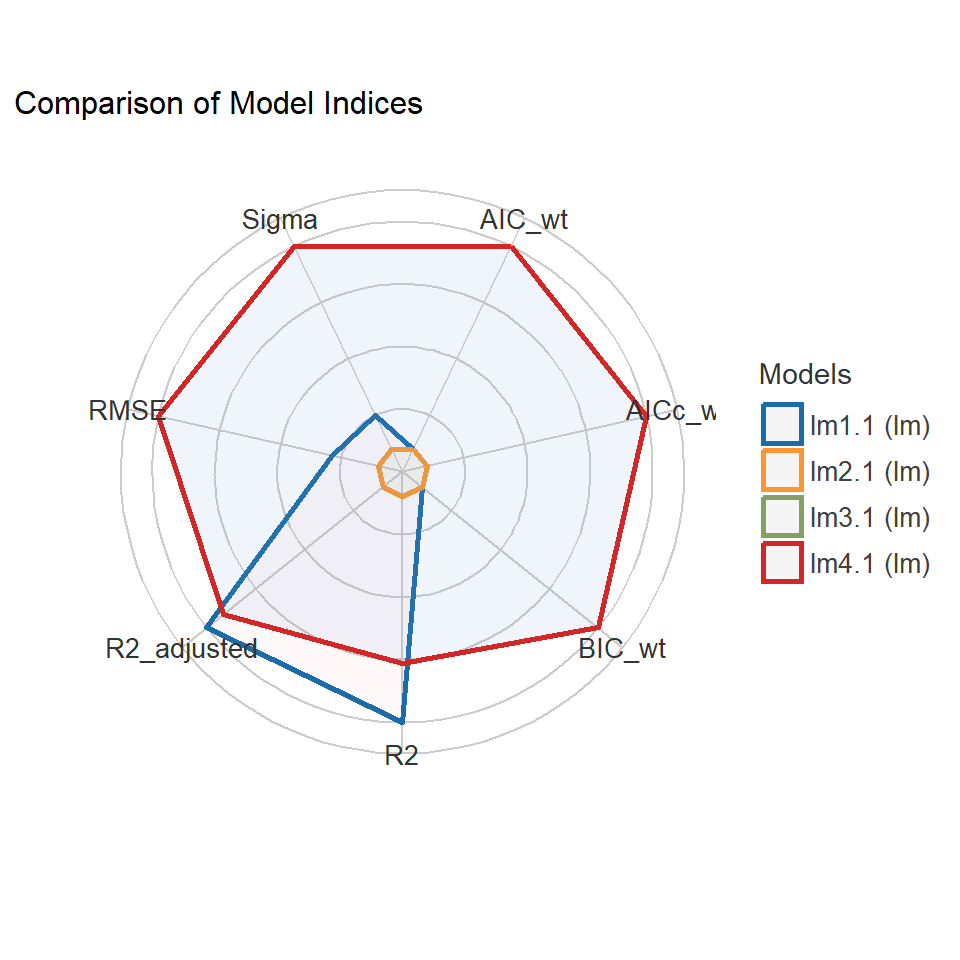
plot(compare_performance(lm1.1, lm2.1, lm3.1, lm4.1))

Sobre el \(R^2\) de nuevo

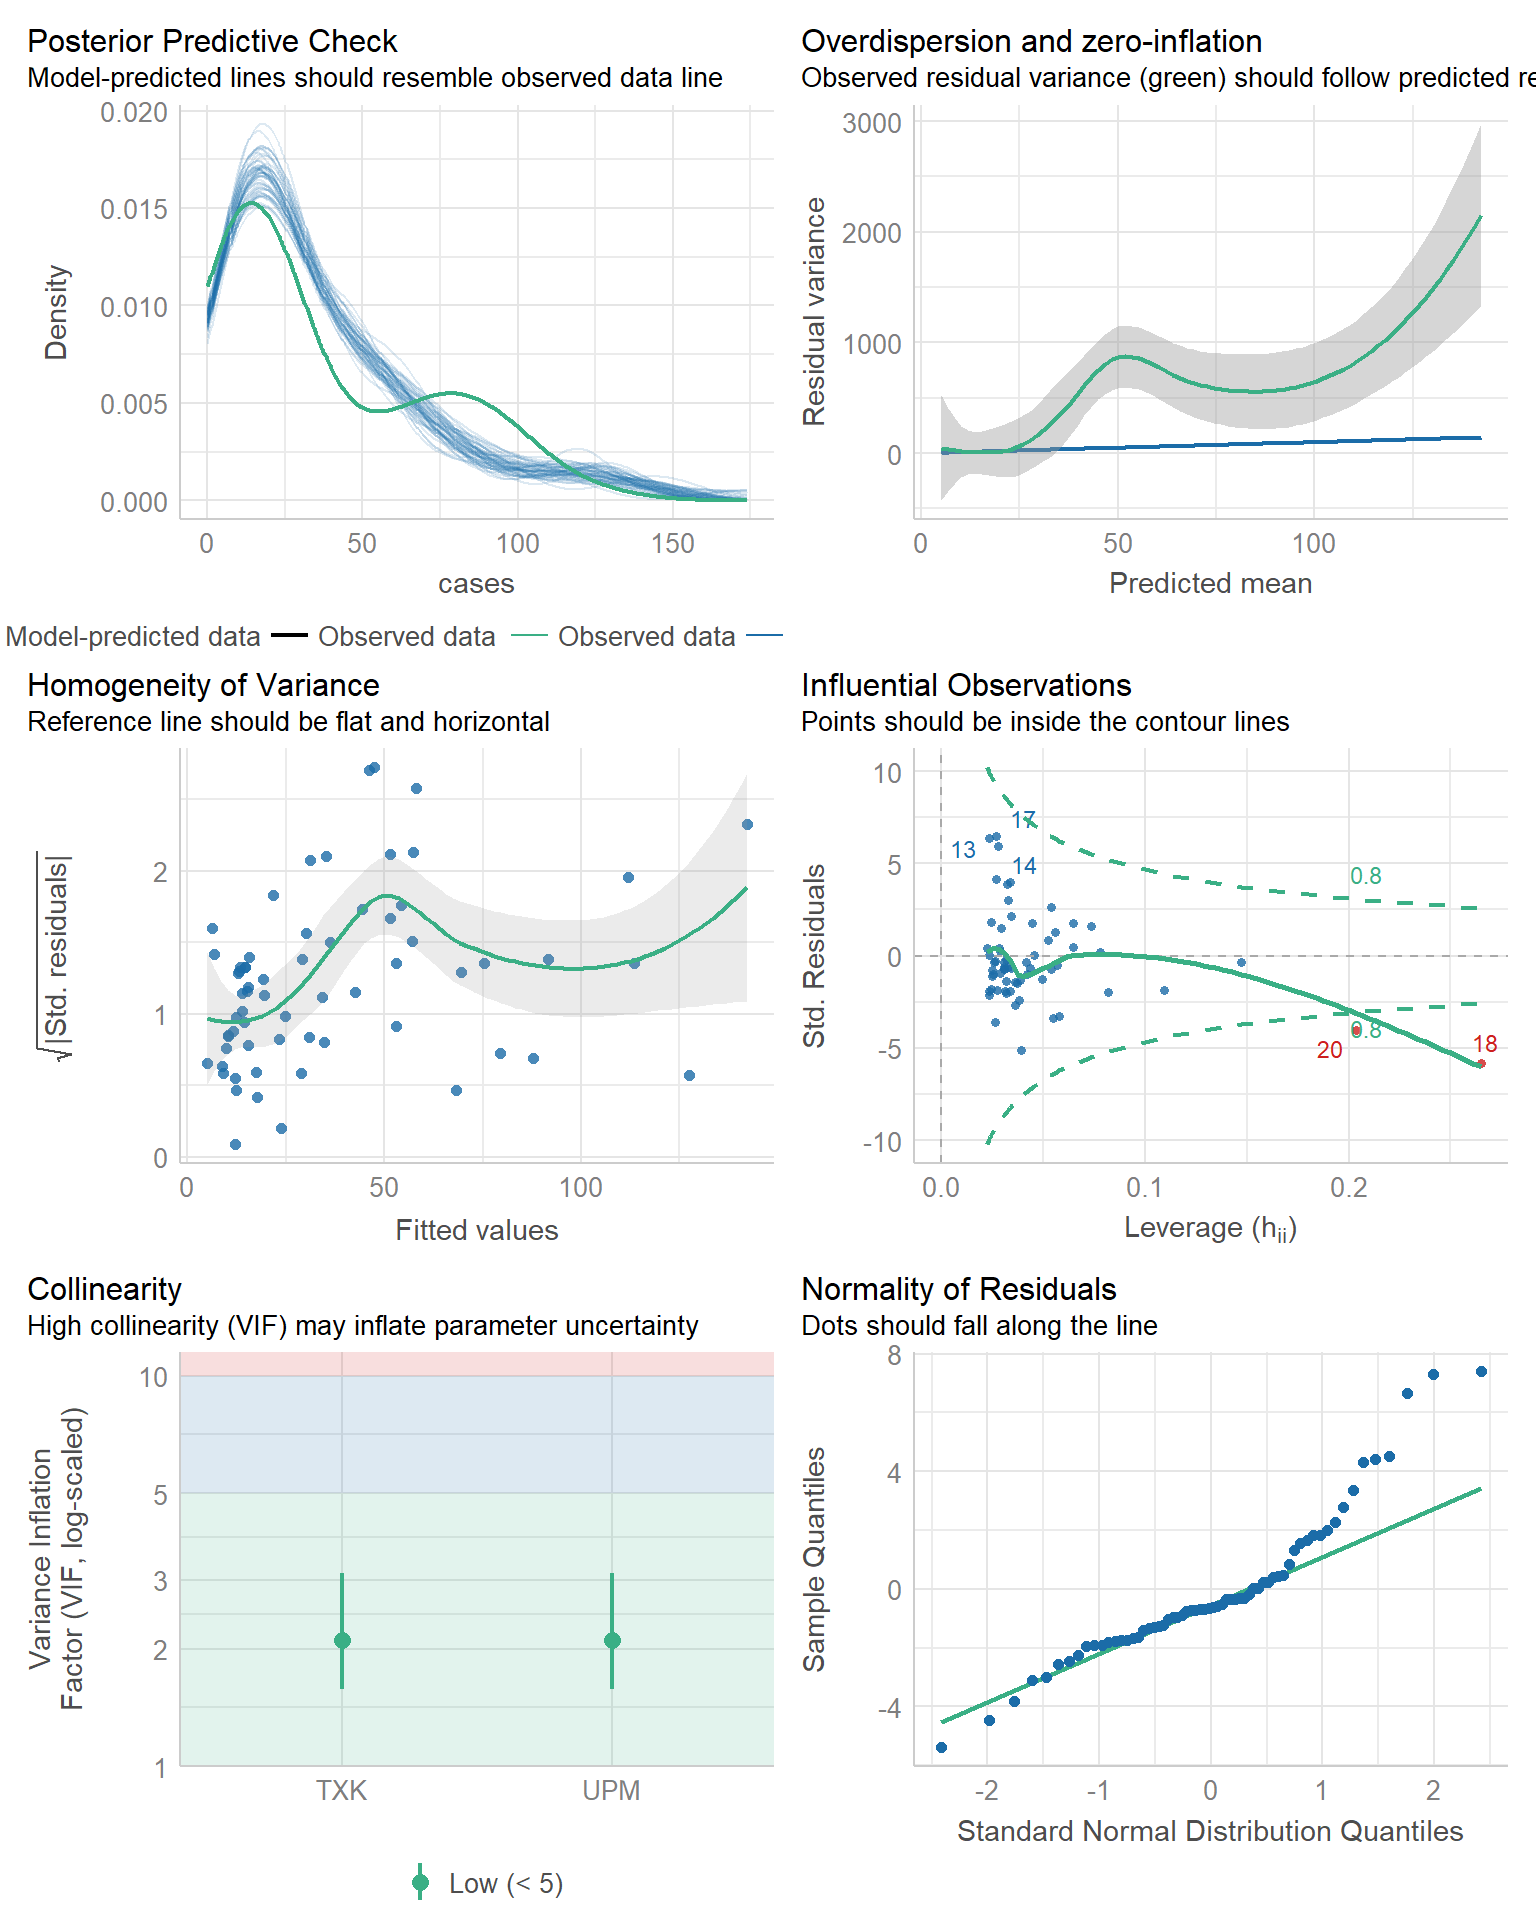
  • Solo para tener una idea, ya que no vimos los diagnósticos del modelo que según el \(R^2\) sería el mejor, démosles un vistazo ahora
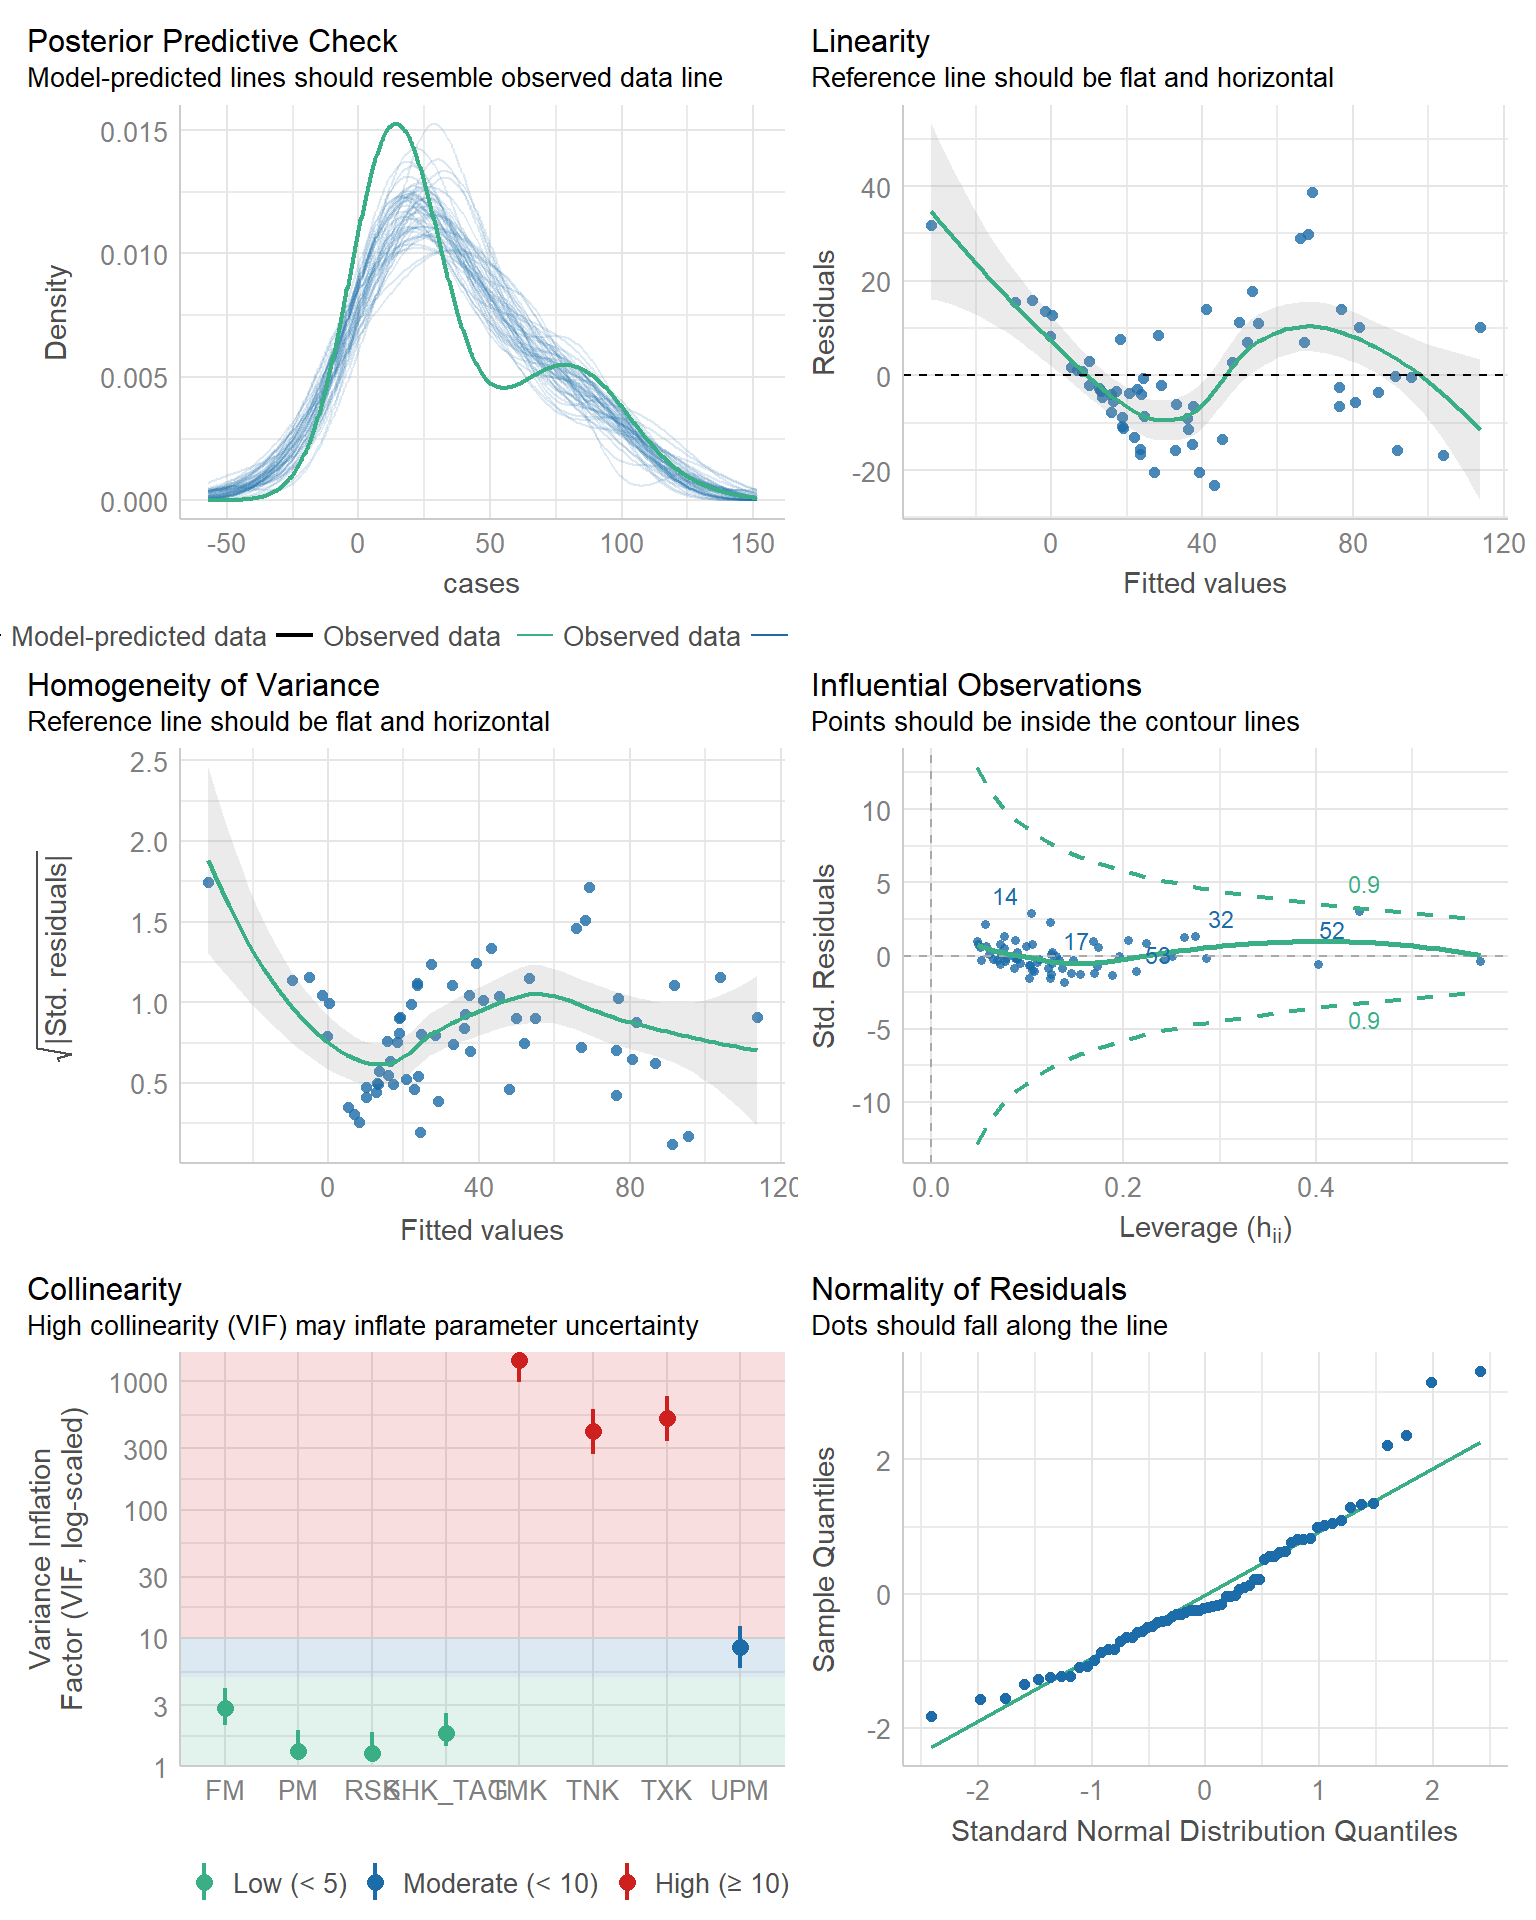
check_model(lm1.1)

Introducción a modelos lineales generalizados

¿Qué son los modelos lineales generalizados?

  • En breve, los modelos lineales generalizados son aquellos que no consideran normalmente distribuida a la variable de interés.

  • Toman este nombre ya que generalizan la regresión lineal al permitirle relacionarse con la variable de respuesta a través de una función de enlace que transforma a esta última a la escala normal.

  • Por tanto, estos modelos también compartirán los supuestos de la homogeneidad de la varianza y normalidad de los residuos. Aunque dependiendo de cada función de enlace a usarse, habrán otros estadísticos de interés.

  • Son especialmente útiles en casos como los que mencioné durante los “pasas para realizar un estudio” donde remarcamos la importancia de tener en mente si la variable de respuesta a medir puede o no ser modelada bajo el paradigma normal.

  • En vista de lo basta que es la metodología dentro de este apartado de la estadística, nos enfocaremos en tan solo dos ejemplos:

    • La regresión de Poisson

    • La regresión binomial negativa

Regresión de Poisson en R

  • En breve, la regresión de Poisson se usa para el modelado de datos discretos que representan el conteo de algún evento.

  • En el ejemplo que consideramos anteriormente, el número de casos de rotavirus es un ejemplo de este tipo de eventos.

  • La razón por la que ese modelo funcionó relativamente bien es porque inadvertidamente impusimos la función de enlace sobre los datos al aplicar la transformación logarítmica.

  • Veamos que sucede al implementarla en R

glm1 <- glm(cases ~ TXK + UPM, data = rot_berlin_out, family = "poisson")
check_model(glm1)

Regresión de Poisson en R

Regresión binomial negativa
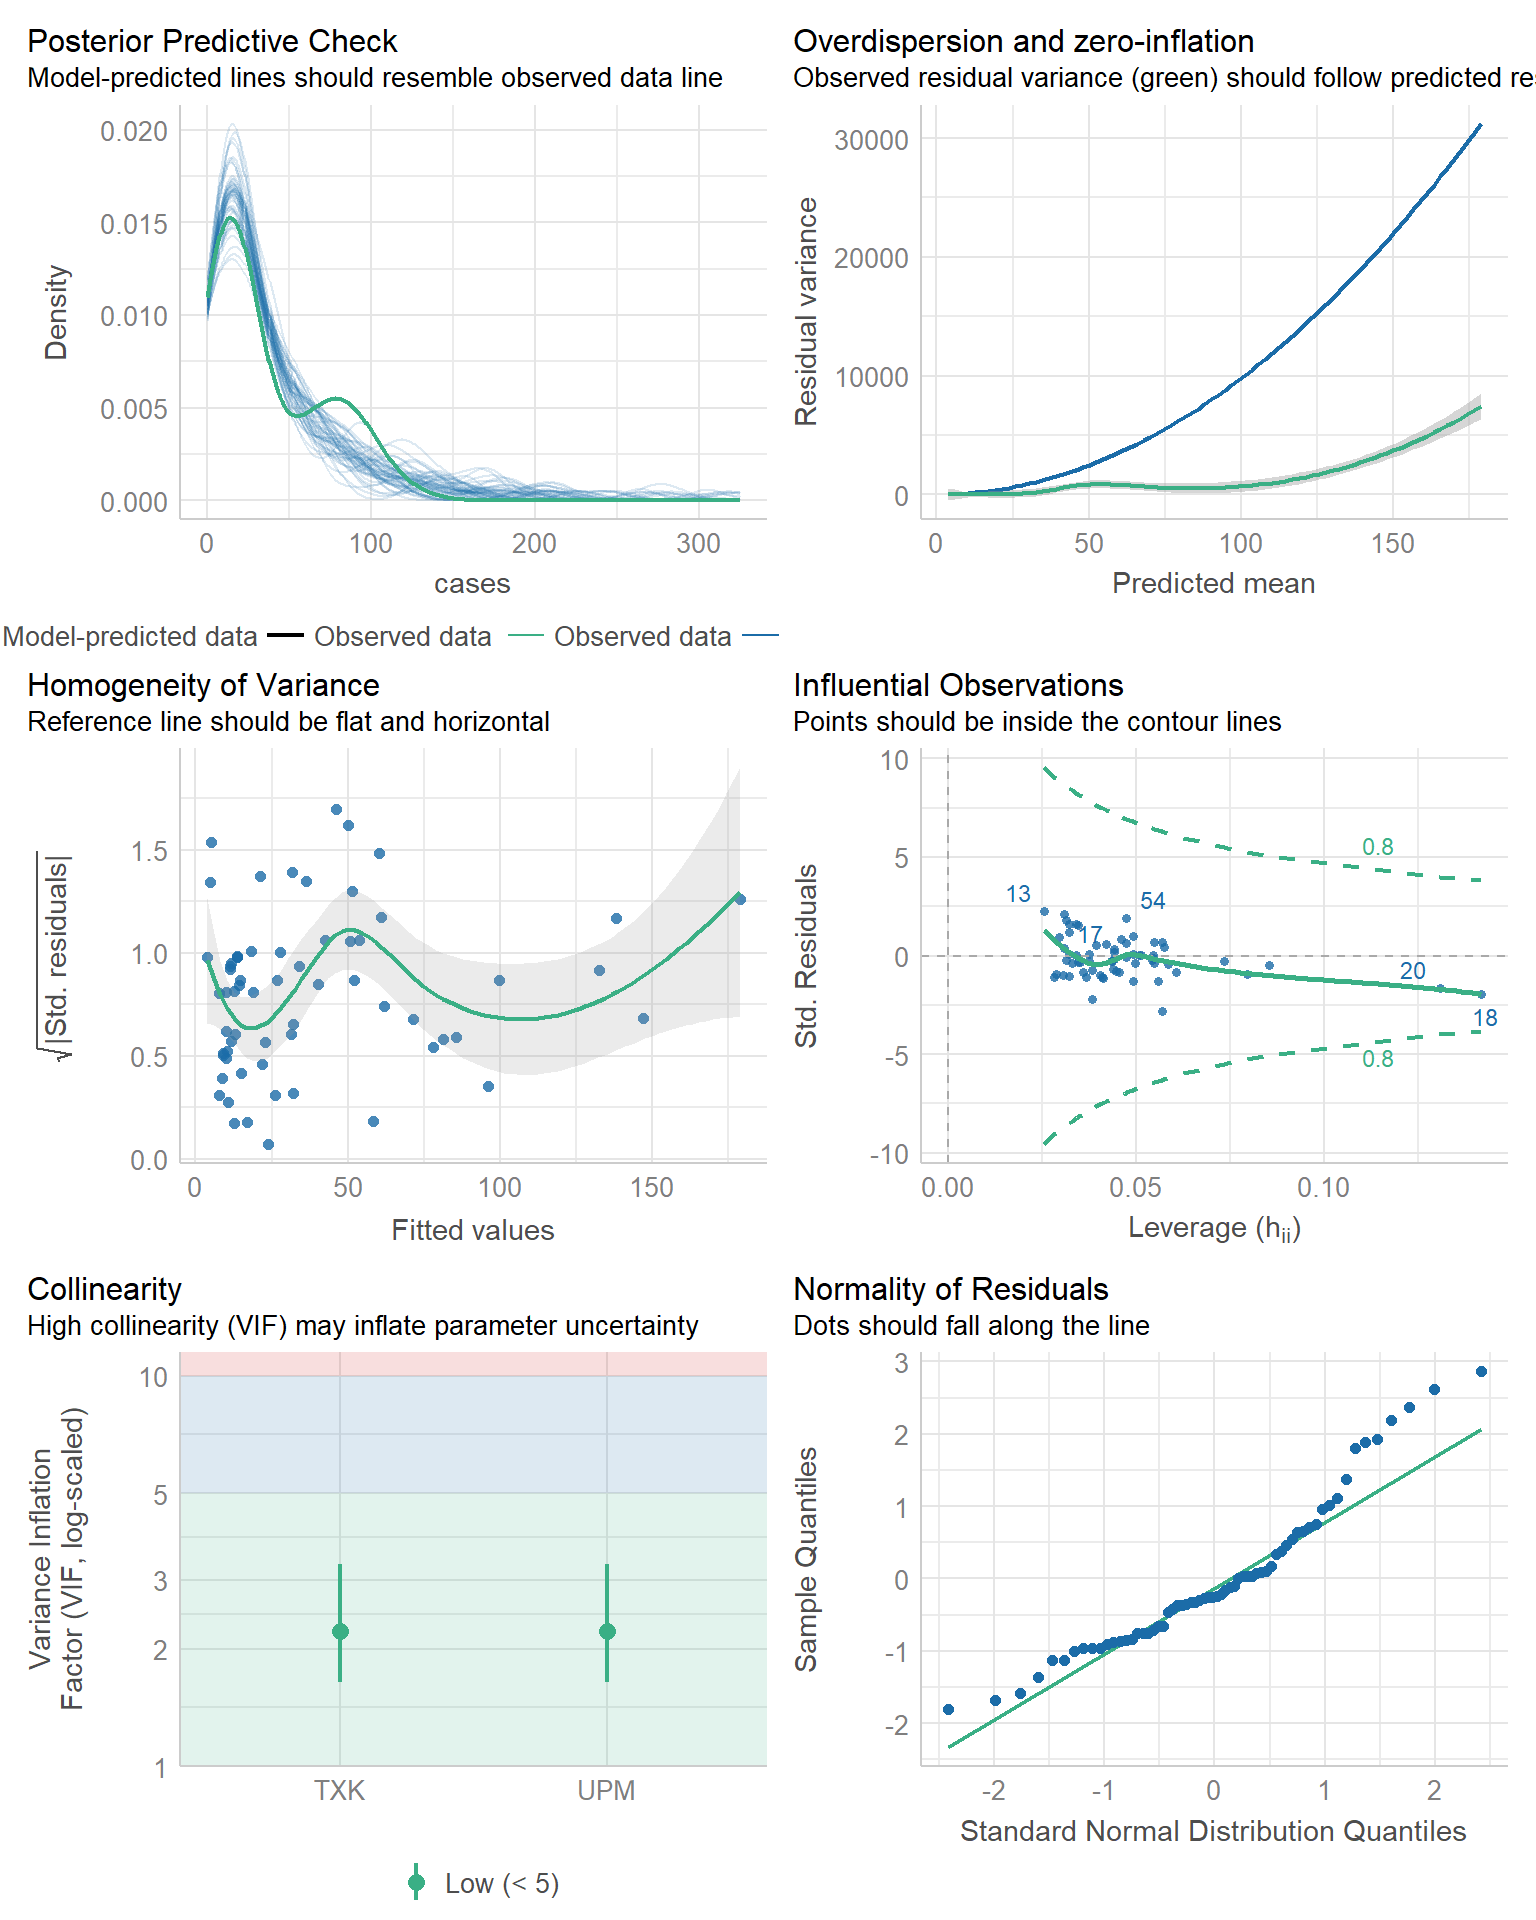
  • Vemos que el modelo usando la regresión de Poisson no mejora mucho en términos de los supuestos.

  • Como mencionamos, el gráfico de sobredispersión ya nos da un indicativo de que el modelo es incorrecto.

  • Una alternativa para lidiar con sobredispersión es usar la regresión binomial negativa

  • Para ello, usaremos la librería MASS que ofrece esta funcionalidad

library(MASS)
glm2 <- glm.nb(cases ~ TXK + UPM, data = rot_berlin_out)
check_model(glm2)

Regresión binomial negativa

Comparación de modelos

  • Comparemos primero todos los modelos que hemos llevado a cabo hasta aquí sin rankearlos
library(flextable)
colformat_double(flextable(compare_performance(lm1.1, lm2.1, lm4.1, glm1, glm2)), digits = 3)

Name

Model

AIC

AIC_wt

AICc

AICc_wt

BIC

BIC_wt

RMSE

Sigma

R2_Nagelkerke

Score_log

Score_spherical

R2

R2_adjusted

lm1.1

lm

529.825

0.000

533.976

0.000

551.414

0.000

12.989

14.011

0.847

0.825

lm2.1

lm

547.212

0.000

547.890

0.000

555.848

0.000

16.341

16.738

0.759

0.751

lm4.1

lm

484.591

0.112

485.269

0.112

493.227

0.112

0.411

0.421

0.824

0.818

glm1

glm

681.463

0.000

681.863

0.000

687.939

0.000

17.426

2.423

1.000

-5.277

0.090

glm2

negbin

480.440

0.888

481.118

0.888

489.076

0.888

20.876

1.029

0.995

-3.845

0.101

Comparación de modelos

  • Ahora rankeados
colformat_double(flextable(compare_performance(lm1.1, lm2.1, lm4.1, glm1, glm2, rank = T)), digits = 3)

Name

Model

RMSE

Sigma

R2_Nagelkerke

Score_log

Score_spherical

R2

R2_adjusted

AIC_wt

AICc_wt

BIC_wt

Performance_Score

glm2

negbin

20.876

1.029

0.995

-3.845

0.101

0.888

0.888

0.888

0.793

lm4.1

lm

0.411

0.421

0.824

0.818

0.112

0.112

0.112

0.475

glm1

glm

17.426

2.423

1.000

-5.277

0.090

0.000

0.000

0.000

0.209

lm1.1

lm

12.989

14.011

0.847

0.825

0.000

0.000

0.000

0.111

lm2.1

lm

16.341

16.738

0.759

0.751

0.000

0.000

0.000

0.044

Consideraciones sobre la comparación de modelos

  • La versatilidad de performance es que nos permite comparar entre modelos provenientes de distintas metodologías estadísticas (hace no más de 5 años eso no era posible).

  • Sin embargo, hay que tener en cuenta que para que las comparaciones sean válidas, los modelos tienen que haber sido ajustados sobre los mismos datos.

  • Por ejemplo, no hubiese sido correcto en este ejemplo comparar todos los modelos que llevamos a cabo sin que estos hubiesen sido ajustados sobre la tabla de datos sin el outlier.

Ejercicio 5.2

Anteriormente mencionamos que los datos del rotavirus tienen una característica temporal. A partir de los modelos que mejor desempeño mostraron, trata de agregar un efecto temporal ya sea con los meses o las semanas epidemiológicas. ¿Qué notas de extraño en los resultados?

Antes de terminar

JASP

JASP

  • JASP es un software estadístico de licencia libre desarrollado por la Universidad de Amsterdam.

  • Tiene un funcionamiento similar a SPSS con la diferencia de que realiza los análisis en tiempo real sin necesidad de un botón de ejecución.

  • Esta basado en R y presenta la alternativa de llevar a cabo también metodologías Bayesianas de una manera simple.

  • Es una buena alternativa para análisis estadísticos sencillos mediante una interface amigable e intuitiva.

  • Desventajas: no tenemos la libertad de realizar muchos más análisis como en R, todavía se encuentra en etapas tempranas de desarrollo y tiende a presentar aún varios bugs y no es aún confiable para análisis muy complejos.

¡Gracias!