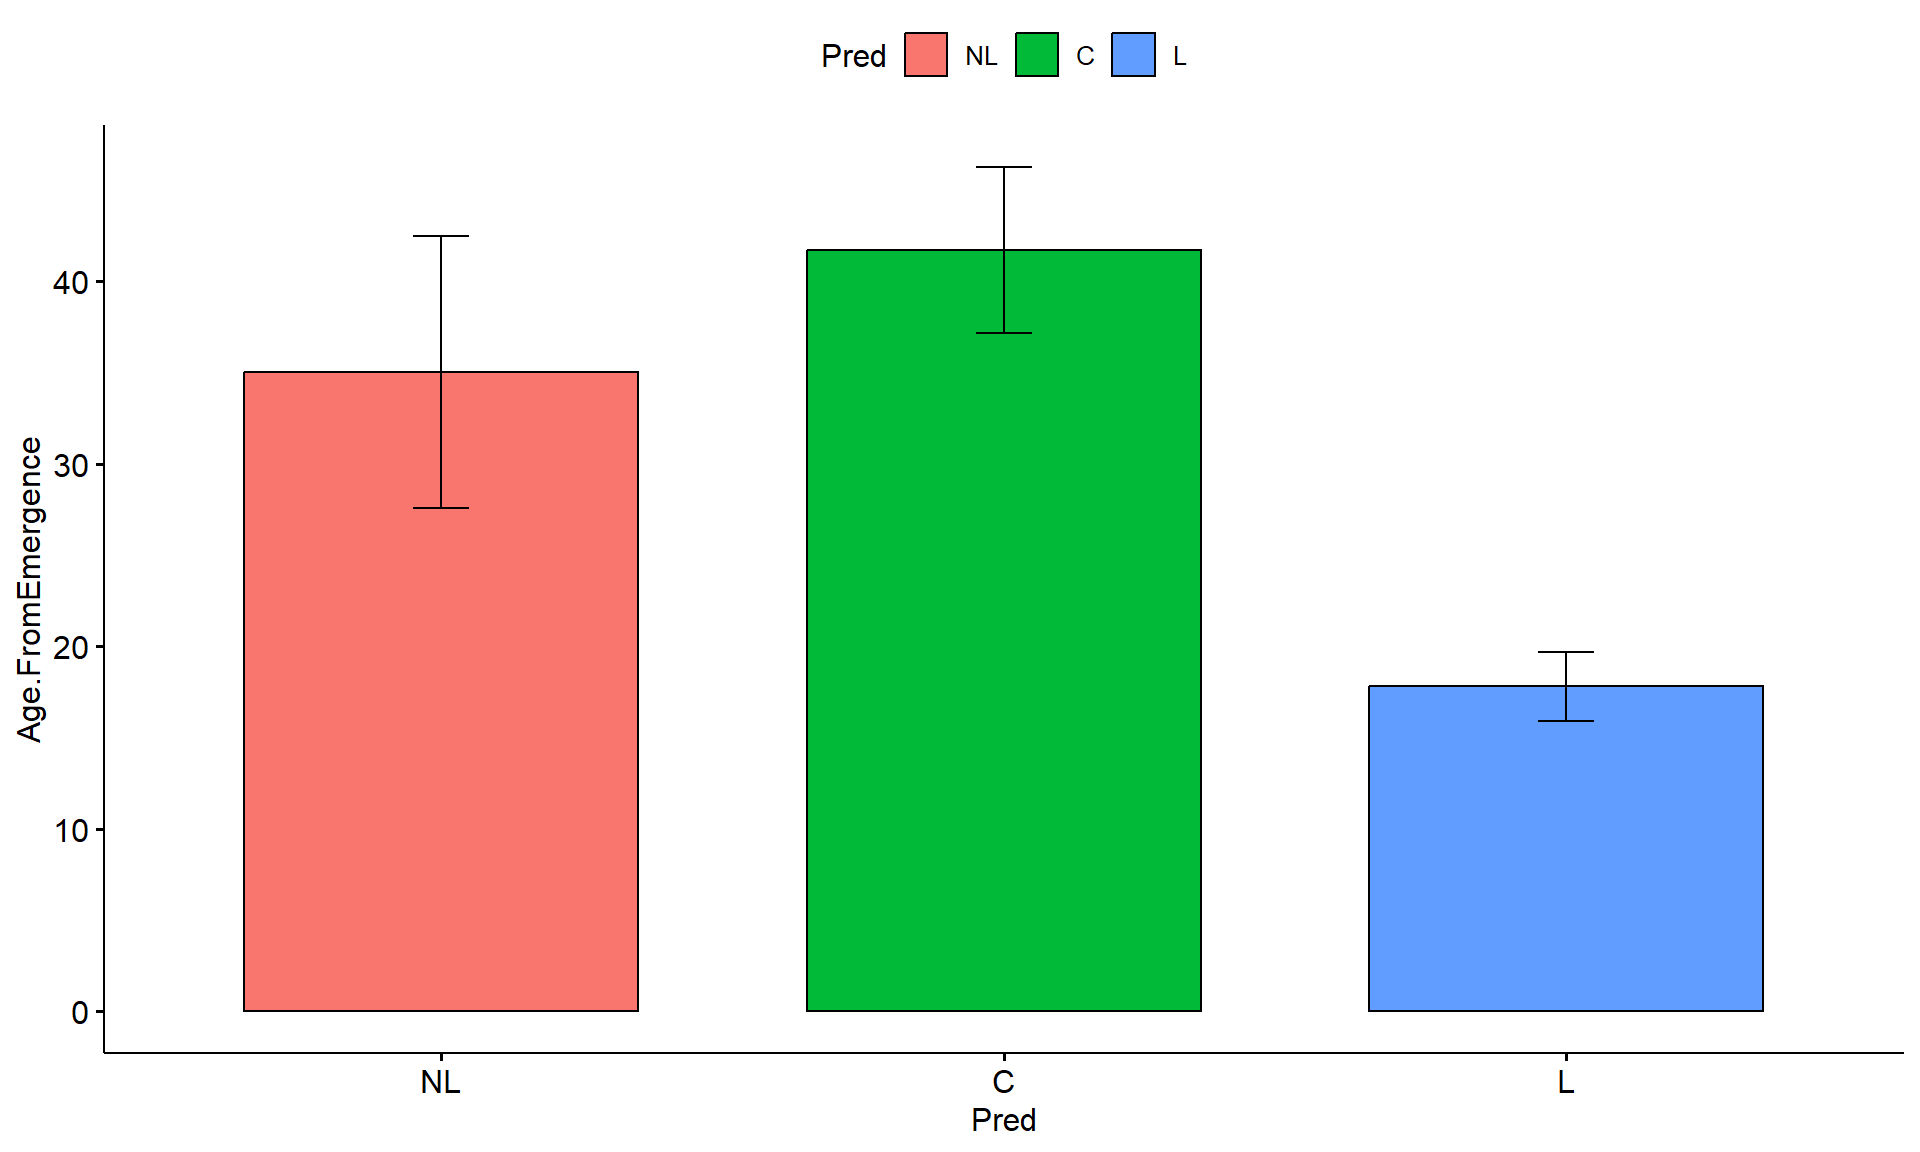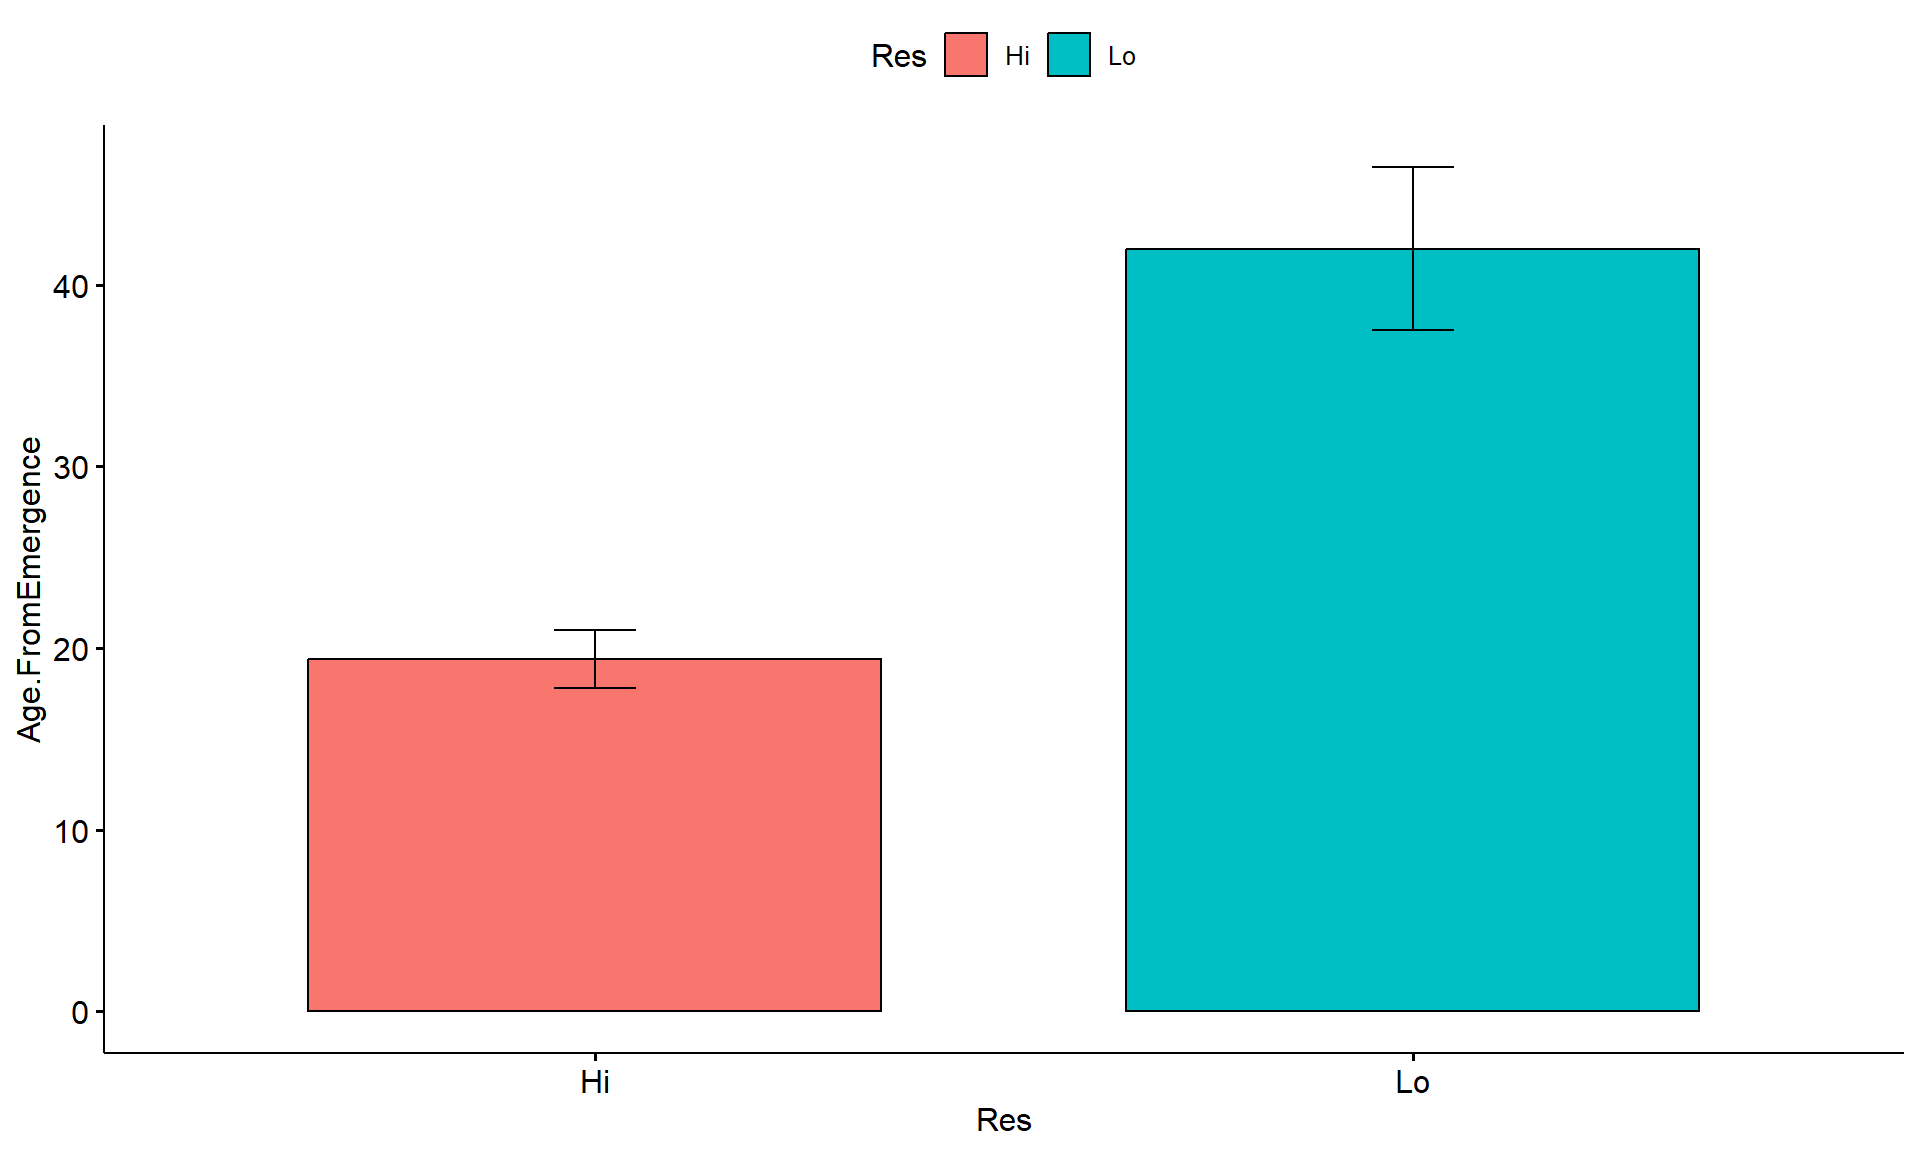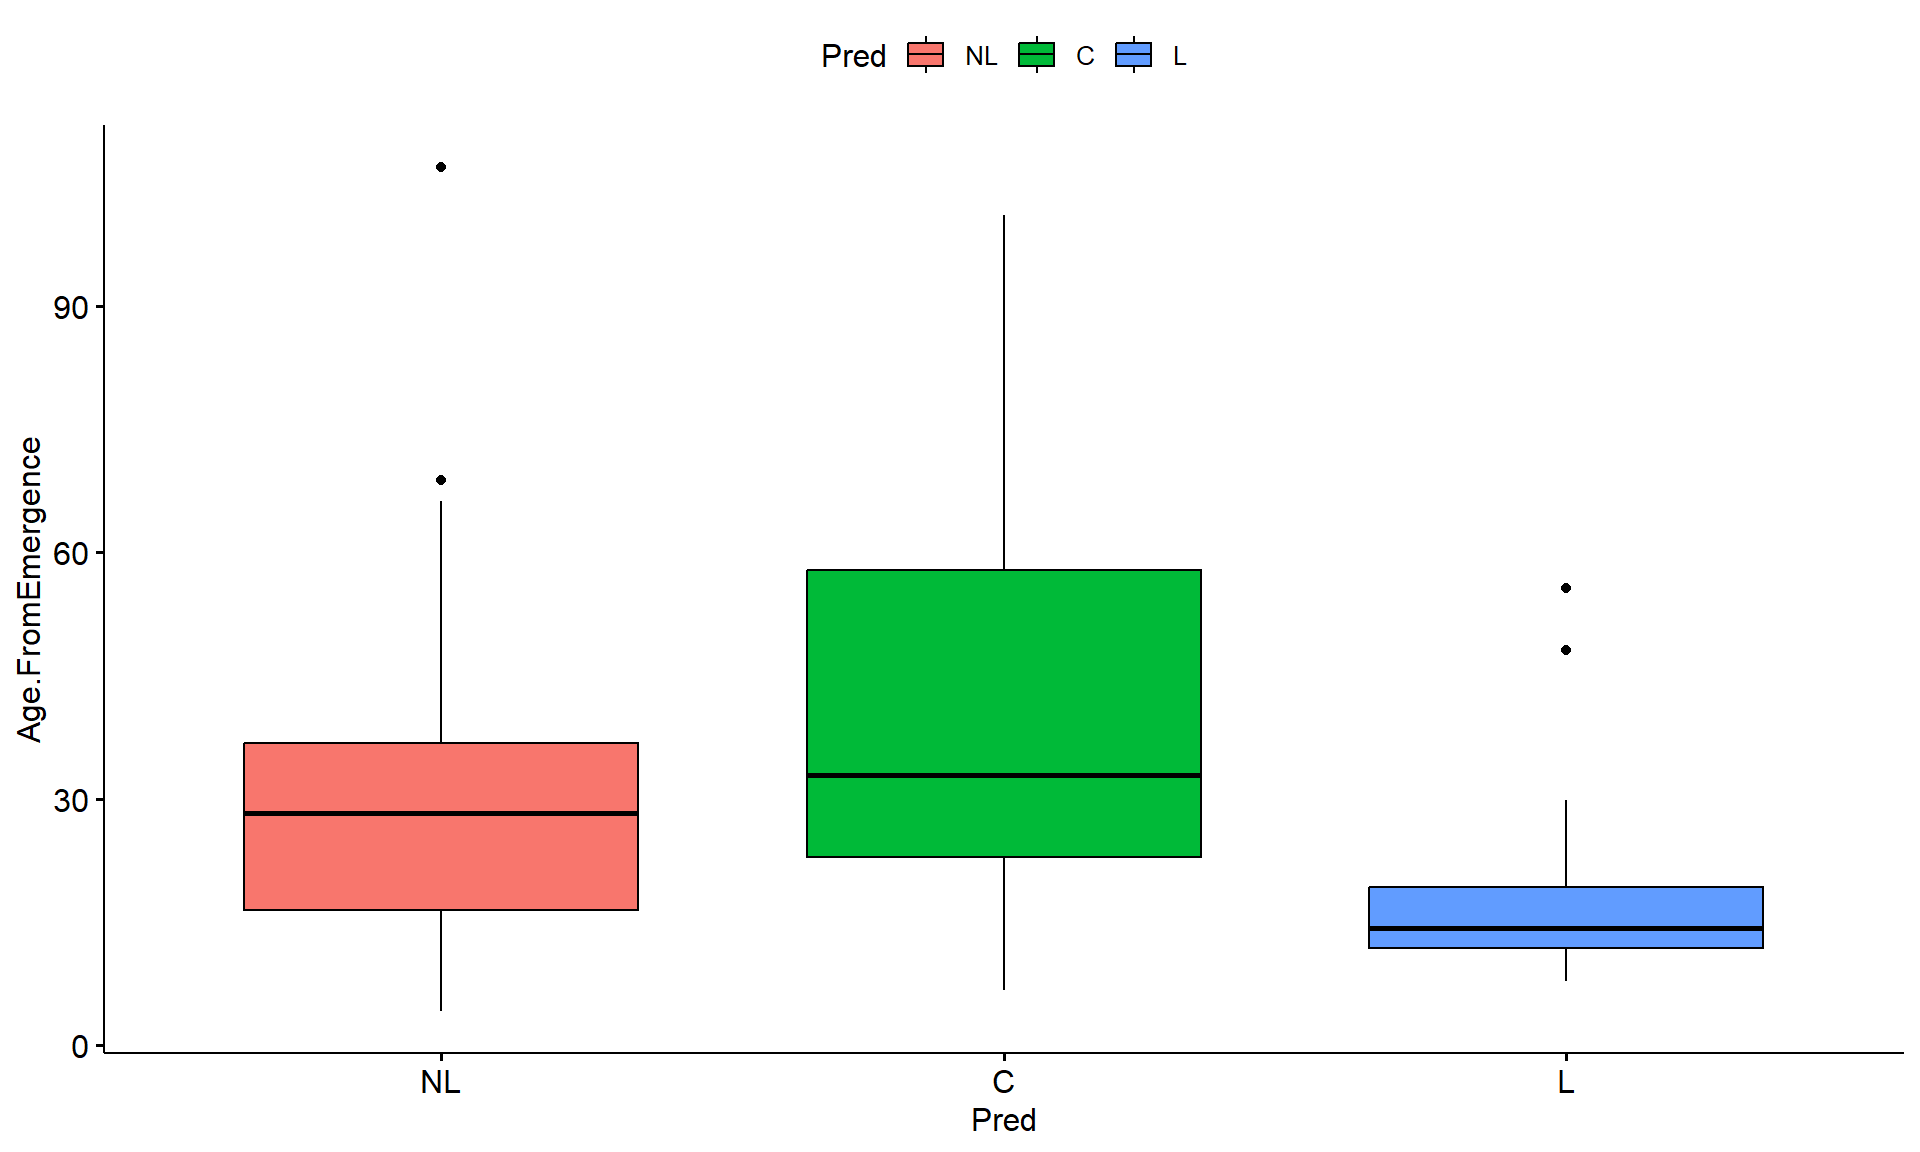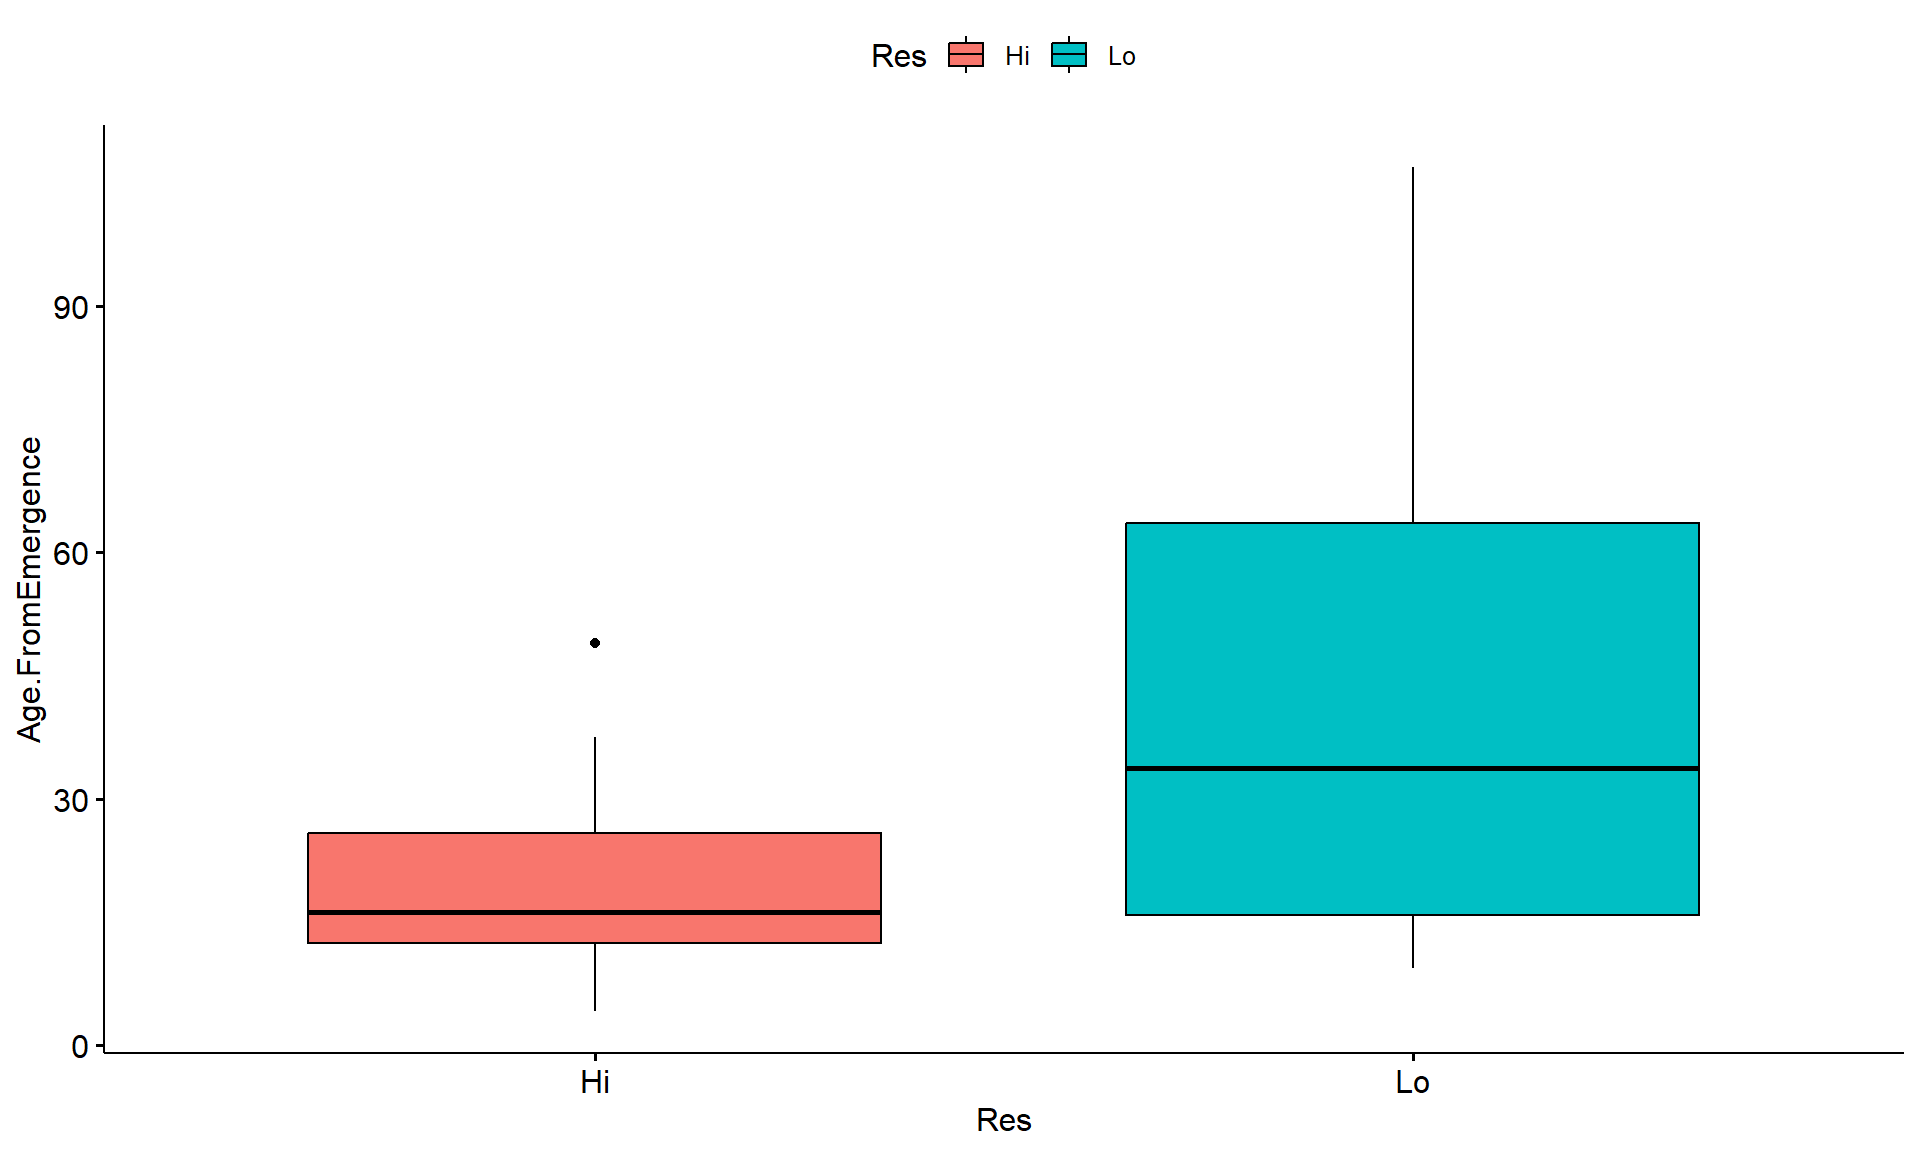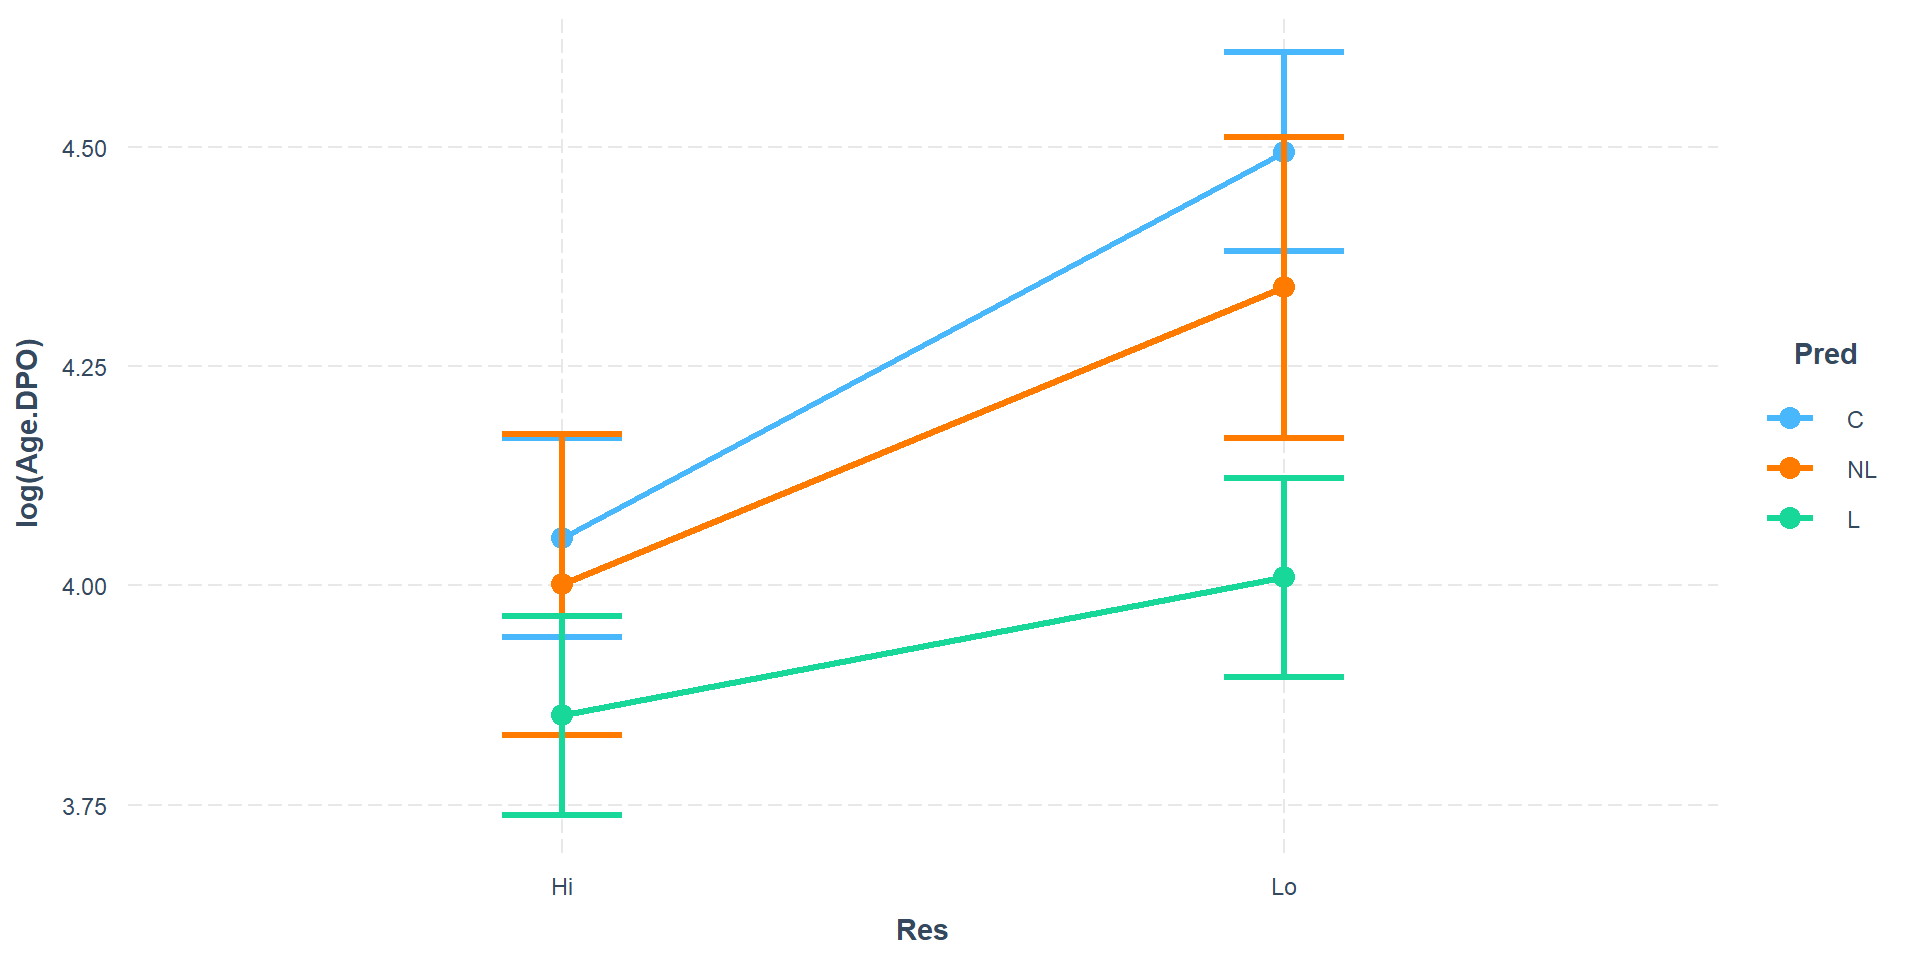
Estadística aplicada con R

Módulo 4: Herramientas Estadísticas

Mauricio Moreno, PhD

Definiciones básicas

Antes de comenzar

  • Uno de los objetivos de este curso es el evitar en la medida de lo posible el adentrarnos en teoría estadística. Entre los temas que dejaremos de lado están:

    • Teoría de la probabilidad básica

    • Descripción a detalle de la distribución normal

    • Descripción a detalle de otras distribuciones

  • Sin embargo, es preciso el comenzar por algunas definiciones que inevitablemente serán necesarias para entender de mejor manera el resto del mismo.

Muestras, poblaciones y muestreos

  • Muestra: Es un conjunto de observaciones que provienen de una población de interés. Idealmente, esta debería ser lo suficientemente grande para hacer inferencias de esa población.

  • Población: Es el conjunto de todas las posibles observaciones de las que tengamos interés en realizar inferencias. Es vital el definir adecuadamente sus características.

  • Muestreo: Es el proceso por el cual obtendremos nuestra muestra para un estudio. En estudios experimentales, el muestreo se entiende también como el proceso de aleatorización/randomización de unidades experimentales.

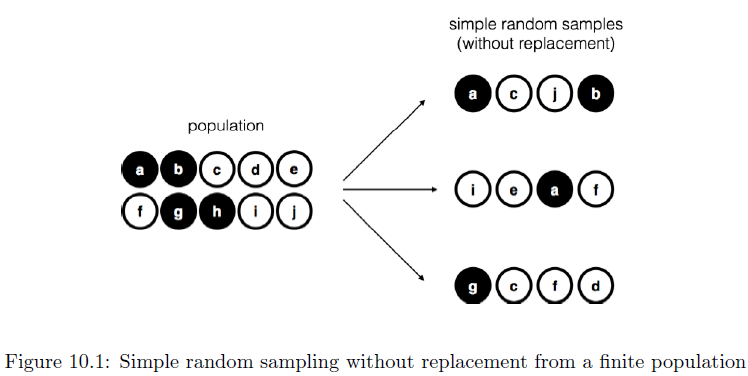
Muestreo simple sin reemplazo

Tomado de Learning Statistics with R

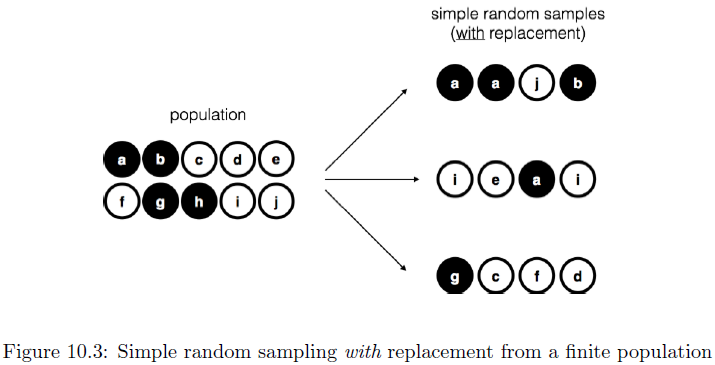
Muestreo simple con reemplazo

Tomado de Learning Statistics with R

Otros tipos de muestreo

  • Muestreo sistemático: consiste en tomar un determinado elemento de la población siguiendo un patrón. Por ejemplo, escoger los múltiplos de cuatro enumerados en una lista de posibles individuos de estudio (solía ser una práctica común en ensayos clínicos).

  • Muestreo a conveniencia: consiste en incluir en el estudio a todos los elementos disponibles de la población de interés. Esto sucede sobre todo con poblaciones escasas o de dificil acceso (ejemplo, realizar estudios en comunidades LGBTIQ+).

  • Muestreo estratificado: es una combinación del muestreo simple con los sujetos agrupados por alguna característica en común, por ejemplo sexo, edad, hábitat (suele ser usado en exit polls y conteos rápidos).

Parámetros poblacionales y estadísticos muestrales

  • Los parámetros poblacionales son características de toda una población (ejemplo, supongamos que el IQ de toda una población puede estar caracterizado por una media aritmética, \(\mu\), igual a 100, con una desviación estándar, \(\sigma\), igual a 15).

  • Si tomo una muestra de 100 individuos de dicha población, podría tener una media aritmética de esta muestra, \(\overline{X}\), igual a 101.4 y una desviación estándar de la muestra, \(s\), igual a 13.7.

  • En otras palabras, la \(\overline{X}\) y \(s\) son aproximaciones a los valores verdareros de \(\mu\) y \(\sigma\) de esa población.

Ley de los números grandes

  • La ley de los números grandes establece que a medida que aumenta el tamaño de una muestra, \(\overline{X}\) y \(s\) estarán más y más cerca de los valores verdaderos \(\mu\) y \(\sigma\).

  • Esta es una de las razones por las cuales en la conducción de experimentos siempre se aconseja el intentar recabar tantas observaciones sea posible.

set.seed(123)
IQ1 <- rnorm(100, mean = 100, sd = 15)
mean(IQ1)
[1] 101.3561
sd(IQ1)
[1] 13.69224
set.seed(123)
IQ2 <- rnorm(100000, mean = 100, sd = 15)
mean(IQ2)
[1] 100.0147
sd(IQ2)
[1] 14.996

Distribución de muestreo

  • La idea de poder medir enormes números de individuos es irreal.

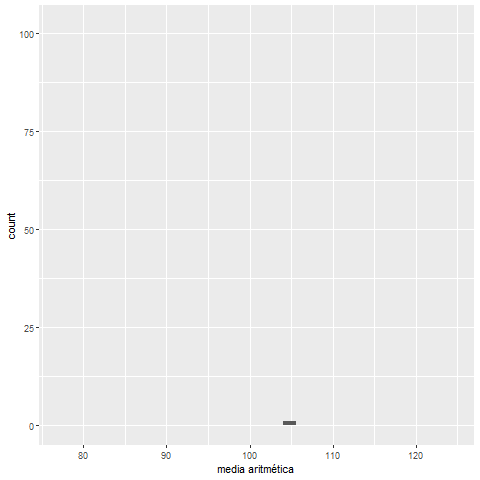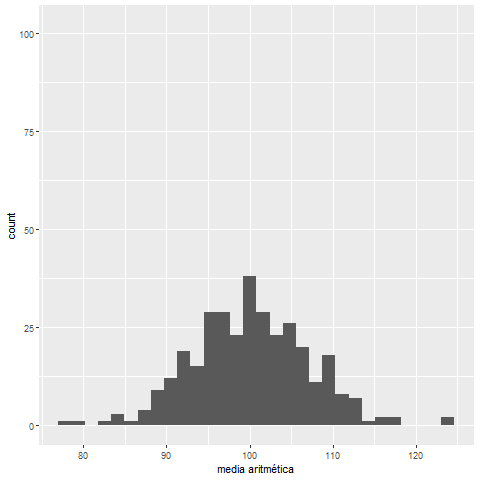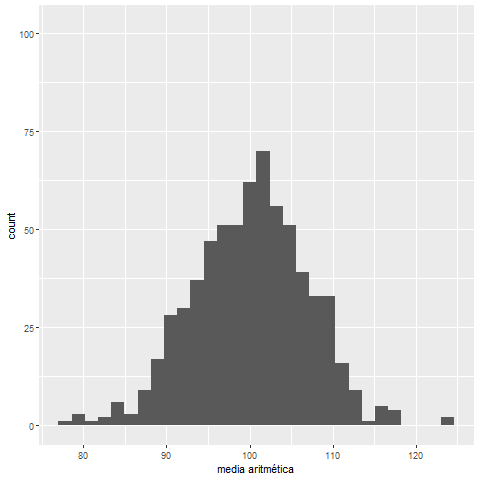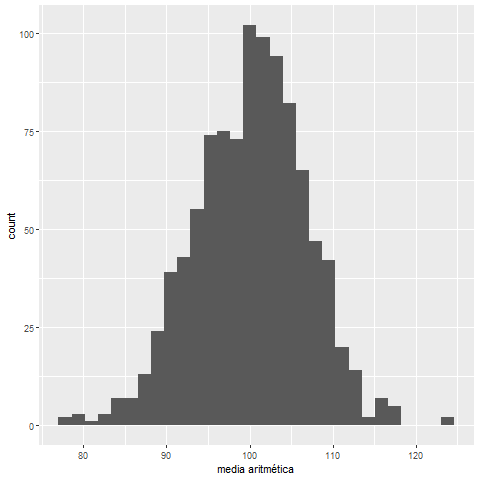
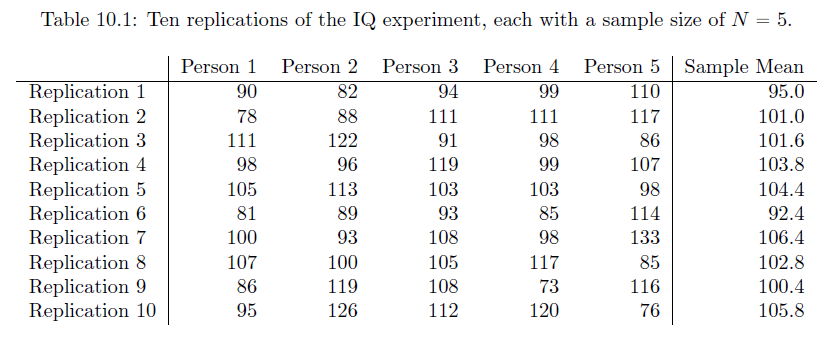
  • Sin embargo, consideremos el siguiente escenario: si en lugar de medir el IQ de 100000 personas, repito el experimento una y otra vez pero en grupos de 5, puedo observar que la distribución de las medias aritméticas de todos estos experimentos adopta la forma de una distribución normal
Distribución de muestreo

  • Esta distribución toma el nombre distribución de muestreo de la media aritmética.

  • Lo que nos demuestra es que, incluso ante reducidos números de observaciones en una muestra, la media aritmética de esta muestra (\(\overline{X}\)) estará próxima a la media aritmética verdadera de la población (\(\mu\)).
Teorema del límite central

  • El teorema del límite central establece que siempre que el número de observaciones sea lo suficientemente grande, la distribución de muestreo de la media aritmética tenderá a ser normal independientemente de si la distribución de las observaciones es normal o no.

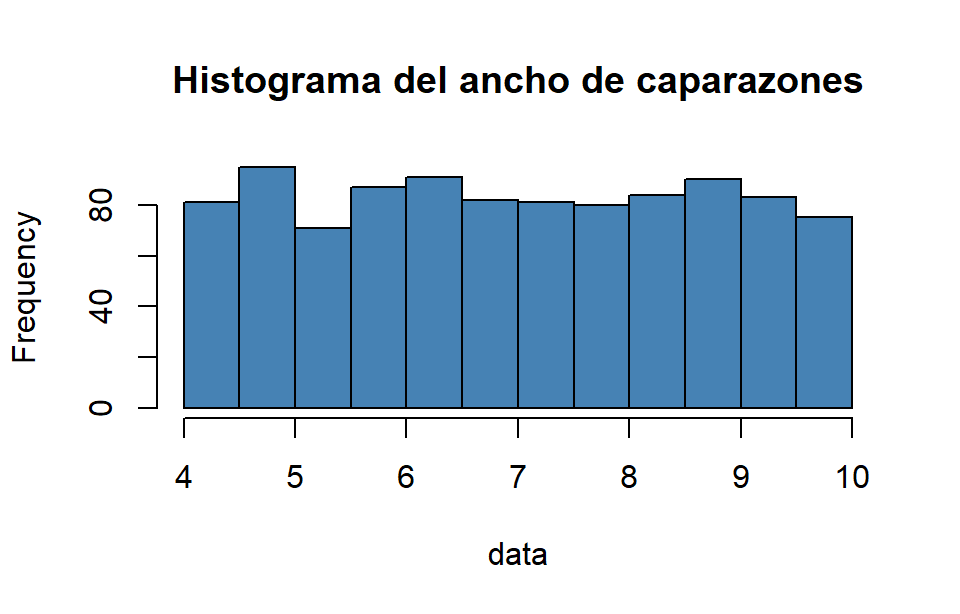
  • Ejemplo: supongamos que el ancho del caparazón de una especie de tortugas está comprendido entre 4 y 10 centímetros. En otras palabras, si observamos al azar una tortuga de esta población, sabemos que el ancho del caparazón estará en este rango. En términos de una distribución, podemos decir que el ancho del caparazón en una población de 1000 tortugas podría verse de esta manera:
Teorema del límite central

Teorema del límite central

  • Es gracias al teorema del límite central que la mayor parte de métodos estadísticos giran alrededor de la normalidad.

  • Sin embargo, cómo ya hemos mencionado, requiere a veces de un considerable número de observaciones para que se cumpla y no todas las veces esto es posible en la práctica.

  • Por ello, en el desarrollo del curso iremos mostrando ejemplos de cuando esto no ocurre y que medidas podemos tomar en tales casos.

Estimación de parámetros de población

Media aritmética

Símbolo ¿Qué es? ¿Sabemos qué es?
\(\overline{X}\) Media aritmética de la muestra Calculada de los datos
\(\mu\) Verdadera media aritmética de la población Casi nunca es conocida
\(\hat{\mu}\) Estimado de la media aritmética de la población Sí, identica a \(\overline{X}\)

\[ \overline{X} = \frac{1}{n}\sum^{n}_{i=1}\left(X_i\right) \]

Estimación de parámetros de población

Desviación estándar

Símbolo ¿Qué es? ¿Sabemos qué es?
\(s\) Desviación estándar de la muestra Calculada de los datos
\(\sigma\) Verdadera desviación estándar de la población Casi nunca es conocida
\(\hat{\sigma}\) Estimado de la deviación estándar de la población Sí, pero no es igual a \(s\)

\[ s = \sqrt{\frac{1}{n} \sum_{i=1}^n (X_i - \overline{X})^2} \]

\[ \sigma = \sqrt{\frac{1}{n-1} \sum_{i=1}^n (X_i - \overline{X})^2} \]

Estimación de parámetros de población

Varianza

Símbolo ¿Qué es? ¿Sabemos qué es?
\(s^2\) Varianza de la muestra Calculada de los datos
\(\sigma^2\) Verdadera varianza de la población Casi nunca es conocida
\(\hat{\sigma}^2\) Estimado de la varianza de la población Sí, pero no es igual a \(s^2\)

\[ s^2 = \frac{1}{n} \sum_{i=1}^n (X_i - \overline{X})^2 \]

\[ \sigma^2 = \frac{1}{n-1} \sum_{i=1}^n (X_i - \overline{X})^2 \]

Intervalos de confianza

  • Cómo hemos visto, los estimados de las verdaderas \(\mu\) y \(\sigma\) (\(\hat{\mu}\) y \(\hat{\sigma}\)) provienen de distribuciones de muestreo, y como tales, inherentemente poseen cierto grado de incertidumbre.

  • Los intervalos de confianza son medidas que nos permiten tener una idea de esa incertidumbre.

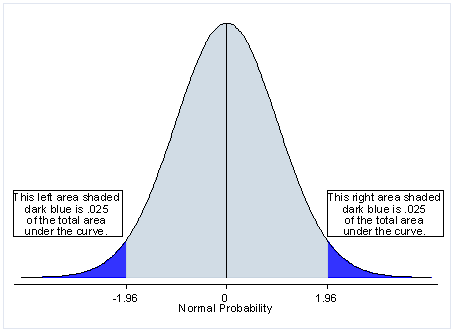
  • En el estudio de la distribución normal estándar tenemos el conocimiento que existe un 95% de chances que una cantidad normalmente distribuida colectada al azar, estará distante de la media aritmética entre \(\pm\) 1.96 desviaciones estándar.

\[ \overline{X} - \left(1.96\times\frac{\sigma}{\sqrt{n}}\right) \leq \mu \leq \overline{X} + \left(1.96\times\frac{\sigma}{\sqrt{n}}\right) \]

  • Y se interpreta como: con un 95% de confianza, podemos esperar que la media aritmética verdadera de la población de interés se encuentra contenida entre…

\[ \text{IC}_{95}=\overline{X} \pm \left(1.96\times\frac{\sigma}{\sqrt{n}}\right) \]

Intervalos de confianza

  • Sin embargo, como mencionamos \(\sigma\) es casi nunca conocido, y es necesario hacer una corrección a la fórmula anterior. La distribución normal trabaja bien baja la presunción de un numero grande de observaciones.

  • En su lugar, en 1908 el estadístico Gosset parametrizó una distribución para muestras pequeñas que asemeja a la normal. Con el tiempo, esta distribución adoptó el nombre de Student.

  • Y es precisamente que la fórmula anterior es corregida con la distribución de Student y así poder calcular intervalos de confianza para muestras pequeñas usando \(s\) en lugar de \(\sigma\):

\[ \text{IC}_{95}=\overline{X} \pm \left(t_{n-1,\alpha/2}\times\frac{s}{\sqrt{n}}\right) \]

  • Donde el valor \(t_{n-1,\alpha/2}\) refiere a:

    • \(n-1\): los grados de libertad, igual al número de observaciones \(n\) de la muestra, menos 1

    • \(\alpha\): es el nivel de significancia (probabilidad de obtener un resultado erróneo por azar).

    • Estos valores en el pasado se encontraban tabulados en libros de texto, hoy contamos con R!

Intervalos de confianza

  • Regresando al ejemplo del IQ, supongamos que medimos al azar el IQ de 5 personas y deseamos calcular el \(\text{IC}_{95}\)
IQ_muestra <- c(101, 98, 116, 96, 129)   # muestra
n <- 5                                   # número de observaciones
t95 <- qt(p = 0.975, df = n -1)          # valor de Student para 4 grados de libertad al 5%
x <- mean(IQ_muestra)                    # media aritmética de la muestra
s <- sd(IQ_muestra)                      # desviación estándar de la muestra
ls <- x + (t95*s/(n-1))                  # límite superior del IC95
li <- x - (t95*s/(n-1))                  # límite inferior del IC95
print(paste0("Con un 95% de confianza podemos esperar que la verdadera media aritmética de IQ de esta población se encuentre entre [",round(li,0),", ",round(ls,0),"]"))
[1] "Con un 95% de confianza podemos esperar que la verdadera media aritmética de IQ de esta población se encuentre entre [98, 118]"

Ejercicios 4.1

La concentración media de glucosa en ratones sanos se ha estimado en un rango entre 80 y 100 mg/dL. En un experimento, se han medido las siguientes concentraciones de glucosa en 10 ratones de una línea genética se presume tendría potencial de ser modelo de hiperglucemia después de unas cuantas más generaciones de cruce selectivo:

glc_rat <- c(108.7, 93.7, 52.7, 79.0, 74.7, 131.9, 99.5, 63.3, 98.6, 92.7)
  • Calcula la media aritmética \(\overline{X}\), la desviación de estándar \(s\) y el intervalo de confianza al 95% de la concentración de glucosa en estos ratones. Sin recurrir a pruebas estadísticas formales, ¿dirías que sus niveles de glucosa están dentro de lo normal o hay razón para desconfiar que son hiperglucémicos?

  • Calcula el \(\text{IC}_{95}\) sin usar la distribución de Student y nota la diferencia.

Pruebas de hipótesis

Hipótesis de investigación vs. hipótesis estadísticas

  • Una hipótesis de investigación gira alrededor del desarrollar una conclusión científica acerca de un tema de interés del investigador. Ejemplos: el fumar causa cáncer, las vacunas causan/previenen enfermedades.

    • Es decir, pueden tener una naturaleza subjetiva, que expresan la pregunta del investigador de una manera general sin mayor descripción del ¿cómo? voy a probar o descartarla, ni ¿en qué extensión?.
  • Hipótesis estadísticas, por el contrario, deben ser matemáticamente precisas y basadas en las características de los datos que recolectemos con el fin de probar o descartar la hipótesis de investigación.

    • Cómo es de esperar, el probar o descartar una hipótesis estadística será únicamente válida para la población sobre la cual una muestra fue tomada.

    • Es ahí donde radica la importancia en definir la población sujeto de estudio de manera planificada con el objetivo de que cumpla tantos detalles sean necesarios de la hipótesis de investigación. Ejemplo, el modelo animal más usado es el ratón. Si bien es cierto constituye uno de los primeros pasos en el desarrollo de muchas investigaciones, los hallazgos en ratones NO pueden ser inmediatamente atribuibles a suceder en seres humanos.

Hipótesis nula y alternativa

  • La formulación de hipótesis estadísticas puede reducirse a establer preguntas de investigación en forma de las hipótesis nula y alternativa.

  • La más sencilla manera de formular esta dupla, es la siguiente. Supongamos que tenemos dos grupos experimentales para probar la eficiencia de un nuevo procedimiento quirúrgico. Un grupo de pacientes será sometido a la intervención tradicional (control), y el otro grupo al nuevo procedimiento (experimental).

    • La hipótesis nula (\(H_0\)) establece que: no existe diferencia entre el grupo control y el grupo experimental,

    • Mientras que la hipótesis alternativa (\(H_a\)) establece que: sí existe differencia entre ambos.

\[\begin{align} H_0& : \mu_c = \mu_e& H_0& : \mu_c- \mu_e =0 \\ H_a& : \mu_c \neq \mu_e& H_a& : \mu_c- \mu_e \neq 0 \end{align}\]

Tipos de errores

  • Al llevar a cabo pruebas de hipótesis pueden ocurrir errores
\[\begin{array}{|c||c||c|} \hline & \text{Acepta }H_{0} & \text{Rechaza }H_{0} \\ \hline H_{0}\text{ es verdadera} & \text{Desición correcta} & \text{Error tipo I} \\ H_{0}\text{ es falsa} & \text{Error tipo II} & \text{Desición correcta} \\ \hline \end{array}\]
  • ¿De qué depende que aceptemos correctamente o no la hipótesis nula?

Las pruebas estadísticas dependen de la cantidad de variación y la diferencia entre tratamientos a detectar (tamaño del efecto). La solución: aumentar el número de observaciones

Poder de una prueba estadística

  • El poder de una prueba estadística es la probabilidad de rechazar la hipótesis nula cuando esta es de hecho falsa.

  • Se puede derivar de la tabla anterior

\[\begin{array}{|c||c||c|} \hline & \text{Acepta }H_{0} & \text{Rechaza }H_{0} \\ \hline H_{0}\text{ es verdadera} & 1-\alpha\text{ (Prob. decisión correcta)} & \alpha\text{ (Taza Error tipo I)} \\ H_{0}\text{ es falsa} & \beta\text{ (Taza Error tipo II)} & 1-\beta\text{ (Poder)} \\ \hline \end{array}\]
  • En la práctica, existen fórmulas cerradas para la determinación del número mínimo de observaciones para alcanzar un poder adecuado (\(\ge\) 80%).

Tamaño del efecto

  • El tamaño del efecto (\(\theta\)) es un valor que por lo general es determinado por el investigador y que puede ser la diferencia de interés a detectar en una prueba estadística.

  • Por simplicidad, vamos a enfocarnos en el ejercicio de los ratones. Supongamos que el investigador está interesado en saber cual sería el número de ratones que necesitaría para con un 80% de poder, encontrar una diferencia entre la media aritmética de su muestra y un valor que considera razonable chequear igual a 100 mg/dL. Este último valor viene a ser el \(\theta\).

  • Las hipótesis de esta prueba se verían así

\[\begin{align} H_0& : \mu_c- \mu_r = \theta \\ H_a& : \mu_c- \mu_r \neq \theta \end{align}\]
  • Sin embargo, la pregunta del investigador aún está incompleta. A tu criterio, ¿qué falta?

  • Al formular hipótesis, hemos considerado el caso más simple hasta el momento. Pero recordando la idea inicial del experimento de los ratones, la opción lógica sería preguntarnos ¿cuántos ratones necesitamos para estar seguros que la población sea hiperglucémica? (cuyo valor de glucosa en sangre esté por encima del de un ratón sano)

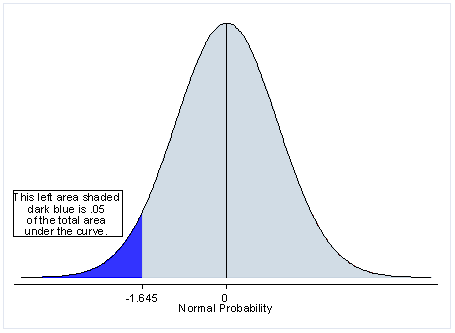
Pruebas de dos colas

\[\begin{align} H_0& : \mu_c- \mu_r = \theta \\ H_a& : \mu_c- \mu_r \neq \theta \end{align}\]

Imagen tomada de UCLA: Advanced Research Computing

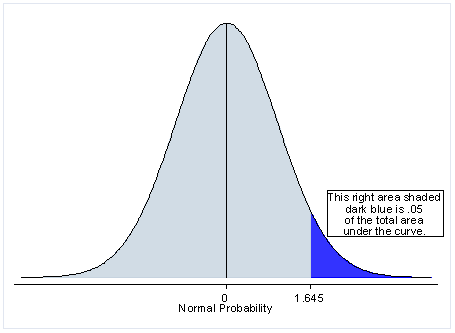
Pruebas de una cola

\[\begin{align} H_0& : \mu_c- \mu_r \ge \theta \\ H_a& : \mu_c- \mu_r < \theta \end{align}\]

Imagen tomada de UCLA: Advanced Research Computing

Pruebas de una cola

\[\begin{align} H_0& : \mu_c- \mu_r \le \theta \\ H_a& : \mu_c- \mu_r > \theta \end{align}\]

Imagen tomada de UCLA: Advanced Research Computing

Un ejemplo de análisis de poder

  • Retomando el poder de una prueba estadística (aunque no es un objetivo de este curso), culminaremos esta sección ejemplificando un análisis de poder con nuestro ejemplo del IQ de una muestra de participantes de una determinada población.

  • Sin entrar en mayor detalle, esto puede lograrse mediante el uso de la librería pwr

  • El tamaño del efecto para análisis de poder tiene que ser estandarizado

\[ \theta = \frac{\hat{\mu}_r-\hat{\mu}_c}{s} \]

Un ejemplo de análisis de poder

  • Acerca del IQ de la muestra de una población, supongamos que el investigador está interesado en saber el número de participantes necesarios para conducir un estudio donde se pueda demostrar que un valor de 100 en IQ esta dentro de la media aritmética del IQ de la población de donde se tomó la muestra.
library(pwr)

IQ_muestra <- c(101, 98, 116, 96, 129)
s <- sd(IQ_muestra)
uc <- mean(IQ_muestra)
ur <- 100

theta <- (ur-uc)/s

pwr.t.test(d = theta, 
           sig.level = 0.05,
           power = 0.80,
           type = "one.sample",
           alternative = "two.sided")

Un ejemplo de análisis de poder

library(pwr)

IQ_muestra <- c(101, 98, 116, 96, 129)
s <- sd(IQ_muestra)
uc <- mean(IQ_muestra)
ur <- 100

theta <- (ur-uc)/s

pwr.t.test(d = theta, 
           sig.level = 0.05,
           power = 0.80,
           type = "one.sample",
           alternative = "two.sided")

     One-sample t test power calculation 

              n = 26.45135
              d = 0.5663939
      sig.level = 0.05
          power = 0.8
    alternative = two.sided

Ejercicio 4.2

A partir de los estadísticos de muestreo de la muestra de ratones del ejemplo anterior, ¿cuál sería el número de los mismos para en un futuro experimento llevar a cabo una prueba estadística con al menos 80% de poder si el objetivo es demostrar que de hecho la media aritmética de esta línea de ratones está por encima del límite superior de 100 mg/dL de glucosa en sangre que se sabe poseen ratones saludables?

glc_rat <- c(108.7, 93.7, 52.7, 79.0, 74.7, 131.9, 99.5, 63.3, 98.6, 92.7)

Valores críticos y el valor p

  • Pero ¿cómo sabemos si una hipótesis es aceptada o rechazada?

  • Regresando al concepto de los intervalos de confianza, los cuartiles de la distribución de Student calculados a un nivel de significancia \(\alpha\) son valores críticos sobre los cuales se determina el rechazo o aceptación de la hipótesis nula.

  • El valor p, describe que tan probable sería observar resultados de la prueba asumiendo que la hipótesis nula no hubiese sido rechazada. Por ello, a menores valores p, mayor la diferencia estadística con respecto a la hipótesis alternativa.

Antes de continuar

Antes de continuar

  • El umbral de 0.05 es una convención arbitraria creada por Fischer en los inicios de la estadística moderna.

  • Lastimosamente, se ha generalizado la idea de que por más mínima sea la diferencia con respecto a 0.05, esta representa la diferencia entre publicar o no (en el campo académico), entre lanzar o no un nuevo fármaco/producto al mercado (en la industria).

  • En 2014, debido a un fallo de la corte suprema de justicia de los Estados Unidos que le dio la potestad a los inversionistas de farmaceúticas a demandarlas por fallar en reportar efectos secundarios de sus productos a pesar de haber sido hallados estadísticamente no significativos, la Asociación Americana de Estadística (ASA) se vio en la necesidad de definir más exhaustivamente el concepto del valor p.

  • Entre las recomendaciones de la ASA, se enfatizó el dar mayor prioridad a la estimación de otros estadísticos complementarios al valor p, tales como intervalos de confianza u otros provenientes de la estadística Bayesiana (intervalos de credibilidad, factores de Bayes).

  • Esta última (estadística Bayesiana), ofrece una interpretación más natural de la estadística al poder interpretar todos sus resultados en términos de probabilidades y no en números arbirtrarios como el valor p.

  • En resumen, una investigación no es inútil si el valor p sobrepasa o está por debajo de 0.05 por cantidades pequeñas.

Antes de continuar

  • En su lugar, en escenarios en que el valor p está alejado por una décima o varias centésimas de 0.05, los resultados deberían interpretarse como indeterminados para generalizar sobre la población objeto de estudio y específicos a las condiciones experimentales (análisis estadísticos, instrumentos de medición, etc) bajo las cuales fueron tomadas y modeladas las mediciones.

  • En el contexto de los modelos estadísticos que veremos más adelante, esto ha derivado en un “temor” del investigador cuando los resultados no pasan los chequeos de los supuestos sobre los que estos modelos se cimentan. Sobre todo cuando el valor p dista de 0.05 por ínfimas cantidades.

  • Esto puede llevar a malas prácticas científicas tales como: no reportar el resultado de los chequeos, blindar los datos, escoger “outliers” y removerlos y en el peor de los casos, manipular los datos para tratar de acomodar nuestros datos a estos chequeos.

  • Todo lo que he mencionado, no solamente constituyen casos de mala conducta científica, sino lo que hoy en día se le conoce como p hacking (que se puede resumir a torturar los datos hasta que nos confiesen una verdad agradable a nuestros propósitos).

Pruebas estadísticas paramétricas

Datos para esta sección

  • Para esta sección del curso usaremos algunas de las tablas de datos del libro Using R for Introductory Statistics, como también de la librería datarium.

  • Para ello, instalaremos las librerías de R: UsingR y datarium.

library(UsingR)
library(datarium)

Pruebas t

  • Las pruebas t son usadas para encontrar la diferencia entre dos medias aritméticas.

  • La \(H_0\) en estas pruebas es que las medias aritméticas son las mismas.

  • Se rechaza la \(H_0\) cuando el valor p resultante es \(<\) 0.05

  • Existen tres tipos de pruebas t

    • Pruebas t de una muestra

    • Pruebas t de muestras independientes

    • Pruebas t de muestras emparejadas

  • Estas pruebas fueron desarrolladas bajo la suposición de la normalidad y de homogeneidad de las varianzas.

  • De acuerdo a lo que hemos visto acerca del teorema del límite central, muestras grandes casi aseguran la normalidad.

  • Cuando el número de observaciones en una muestra es pequeño, es recomendable llevar a cabo un test de normalidad para decidir si es posible una prueba t o una de sus alternativas.

Normalidad de una muestra

  • Antes de llevar a cabo las pruebas t, hemos mencionado sus supuestos. Por ello, es aconsejable el siempre realizar estas pruebas antes de usarlas.

  • Existen dos tipos de pruebas para establecer si una muestra es normalmente distribuida o no

    • Indirectamente: gráfico Q-Q

    • Prueba formal de normalidad (ejemplo: Shapiro-Wilk)

  • En el caso del ANOVA, es importante enfatizar que estas pruebas no necesariamente tienen que hacerse antes de la prueba, como ya veremos más adelante.

Gráfico Q-Q

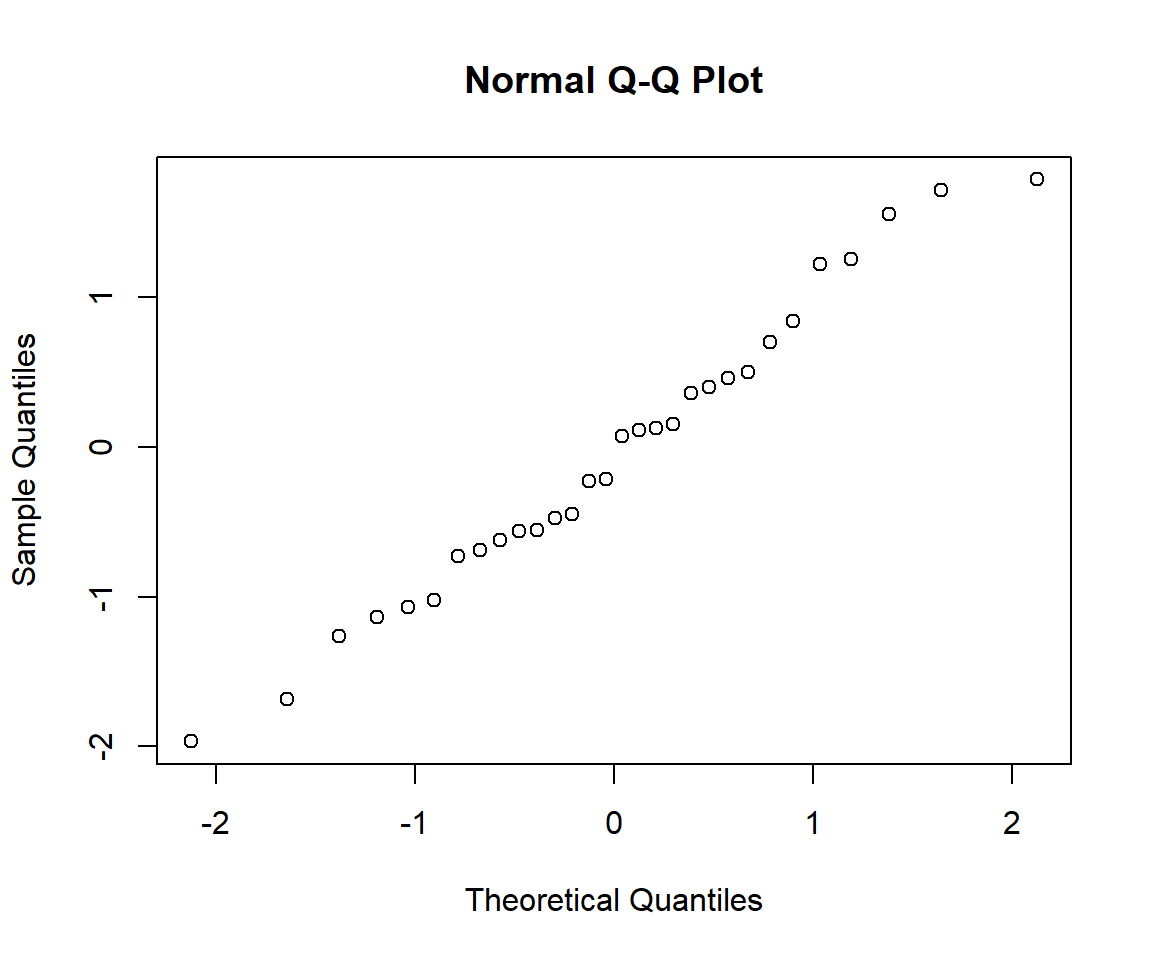
  • El gráfico Q-Q es una prueba visual indirecta de la normalidad.

  • Consiste en crear un gráfico de dispersión entre los valores observados de una muestra vs. los valores que deberían estos tener si siguieran una distribución normal.

  • Mientras en el gráfico de dispersión los puntos más se distribuyan a lo largo de una diagonal, más cercanos están los datos de la muestra a seguir un distribución normal.

  • Su desventaja es que es muy subjetivo, y a menudo requiere una prueba formal para poder confirmarlo.

Gráfico Q-Q

set.seed(123)
y <- rnorm(n = 30, mean = 0, sd = 1)  # simulamos 30 observaciones de una normal estandar
qqnorm(y)                             # producimos el gráfico Q-Q

Gráfico Q-Q

set.seed(123)
y <- rnorm(n = 30, mean = 0, sd = 1)  # simulamos 30 observaciones de una normal estandar
qqnorm(y)                             # producimos el gráfico Q-Q

Prueba de normalidad Shapiro-Wilk

  • La \(H_0\) de esta prueba (y del resto de pruebas formales de normalidad) es que un set de \(n\) observaciones es normalmente distribuido.

  • Otro conocido método es Kolmogorov-Smirnov. Sin embargo, Shapiro-Wilk es más apropiado para cuando el número de muestras es menor a 50.

  • Para ilustrar su uso, chequeemos la normalidad de los datos que simulamos anteriormente

shapiro.test(y)

    Shapiro-Wilk normality test

data:  y
W = 0.97894, p-value = 0.7966

Prueba de homogeneidad de las varianzas

  • En el caso de comparaciones entre las medias de dos grupos, la homogeneidad de varianzas puede chequearse usando la prueba F.

  • La prueba t de una muestra no requiere chequear este supuesto.

  • Para ilustrar su uso, creemos otro vector con datos simulados. En este caso, un igual número de observaciones con la misma desviación estándar pero diferente media:

set.seed(123)
x <- rnorm(n = 30, mean = 4, sd = 1)
var.test(x, y)

    F test to compare two variances

data:  x and y
F = 1, num df = 29, denom df = 29, p-value = 1
alternative hypothesis: true ratio of variances is not equal to 1
95 percent confidence interval:
 0.4759648 2.1009958
sample estimates:
ratio of variances 
                 1 

Supuestos en la práctica

  • Usemos las pruebas con datos reales, esta vez con la tabla de datos crime de la librería Using R.

  • Esta tabla de datos contiene registros de las tasas de crimen (# de reportes/100000 habitantes) en 50 estados en los Estados Unidos correspondiente a los años 1983 y 1993.

  • Sin enfocarnos por el momento en que prueba t específica usaremos, limitémonos a chequear la normalidad y la homogeneidad de varianzas entre las tasas de crimen registradas en 1983 y 1993.

data(crime)

Normalidad 1983

shapiro.test(crime$y1983)     

    Shapiro-Wilk normality test

data:  crime$y1983
W = 0.77333, p-value = 1.827e-07

Normalidad 1993

shapiro.test(crime$y1993)     

    Shapiro-Wilk normality test

data:  crime$y1993
W = 0.77348, p-value = 1.841e-07

Homogeneidad de las varianzas

var.test(crime$y1983, crime$y1993)

    F test to compare two variances

data:  crime$y1983 and crime$y1993
F = 0.49163, num df = 50, denom df = 50, p-value = 0.01342
alternative hypothesis: true ratio of variances is not equal to 1
95 percent confidence interval:
 0.2806163 0.8613069
sample estimates:
ratio of variances 
         0.4916266 
Transformación de variables

  • A menudo nos encontraremos con conjuntos de observaciones que no cumplen uno o ninguno de los supuestos.

  • Antes de considerar pruebas no paramétricas, podemos intentar transformaciones de variables para regresar al mundo de las pruebas paramétricas. Las transformaciones más usadas son:

    • La raíz cuadrada (si los datos no contienen números negativos)

    • Elevar al cuadrado

    • Logaritmo (si los datos solo incluyen números reales positivos, cero excluido)

Transformación de variables

  • Existe un método más sofisticado para “normalizar” una muestra. La transformación de Box-Cox.

  • Cuando se trabaja con muestras transformadas, el objetivo es poder revertir la transformación a las unidades reales para así poder hacer conclusiones sobre las inferencias estadísticas.

  • En otras palabras, una misma transformación debe aplicarse a todos los grupos a ser comparados. NO tiene ningún sentido tratar de realizar inferencias entre grupos donde se hayan usado distintas transformaciones para normalizarlos.

  • Si el número de observaciones es muy reducido, usualmente no hay transformación que funcione y se recomienda usar directamente pruebas no paramétricas.

Transformación de variables

Raíz cuadrada

shapiro.test(sqrt(crime$y1983))     

    Shapiro-Wilk normality test

data:  sqrt(crime$y1983)
W = 0.9411, p-value = 0.01359

Elevar al cuadrado

shapiro.test(crime$y1983^2)     

    Shapiro-Wilk normality test

data:  crime$y1983^2
W = 0.38921, p-value = 2.954e-13

Logaritmo

shapiro.test(log(crime$y1983))     

    Shapiro-Wilk normality test

data:  log(crime$y1983)
W = 0.98076, p-value = 0.5713

Chequeemos con el otro grupo

shapiro.test(log(crime$y1993))     

    Shapiro-Wilk normality test

data:  log(crime$y1993)
W = 0.96191, p-value = 0.1006

Homogeneidad de las varianzas con transformación logarítmica

var.test(log(crime$y1983), log(crime$y1993))

    F test to compare two variances

data:  log(crime$y1983) and log(crime$y1993)
F = 0.84048, num df = 50, denom df = 50, p-value = 0.5412
alternative hypothesis: true ratio of variances is not equal to 1
95 percent confidence interval:
 0.4797393 1.4724831
sample estimates:
ratio of variances 
         0.8404808 
Prueba t de una muestra

  • Es usada para comparar la media aritmética de una muestra con un valor conocido (un estándar por ejemplo).

  • Por lo general el valor al que se va a comparar proviene de referencias bibliográficas, pre-experimentos o supociones fundamentadas.

  • En este caso, el supuesto que debe cumplirse es el de la normalidad de los datos

  • Regresando a nuestro ejemplo de los ratones, determinemos si la media de la muestra es mayor al límite superior de glucosa de ratones saludables.

Prueba t de una muestra

glc_rat <- c(108.7, 93.7, 52.7, 79.0, 74.7, 131.9, 99.5, 63.3, 98.6, 92.7)
t.test(glc_rat,
       mu = 100,
       alternative = "greater")

Prueba t de una muestra

glc_rat <- c(108.7, 93.7, 52.7, 79.0, 74.7, 131.9, 99.5, 63.3, 98.6, 92.7)
t.test(glc_rat,
       mu = 100,
       alternative = "greater")

    One Sample t-test

data:  glc_rat
t = -1.4485, df = 9, p-value = 0.9093
alternative hypothesis: true mean is greater than 100
95 percent confidence interval:
 76.16687      Inf
sample estimates:
mean of x 
    89.48 

Ejercicio 4.3

La tabla de datos blood de la librería UsingR tiene las medidas de presión sistólica de sangre correspondientes a 15 pacientes (columna “machine”). De acuerdo al Centro de Prevención y Control de Enfermedades de los Estados Unidos (CDC), una presión sistólica saludable está por debajo de 120 mm Hg. Determina si la media de la muestra contenida en esta tabla de datos está por debajo de este valor sugerido por el CDC.

Copia y pega las siguientes líneas de código a tu script. Luego de ejecutarlas, una tabla de datos de nombre blood aparecerá disponible en la ventana del ambiente de RStudio

data(blood)
blood

Tip: para acceder a la columna con las presiones sistólicas, usa la siguiente sintaxis: blood$machine

Prueba t de muestras independientes

  • Es usado para comparar las medias aritméticas de dos grupos independientes.

  • Por ejemplo, si deseas comparar las medias aritméticas de individuos agrupados por sexo.

  • Para ilustrar esta prueba, vamos a hacer uso de la tabla de datos de genderweight de la librería datarium.

    • Veamos si existe una diferencia significativa en la media del peso entre hombres y mujeres
data(genderweight)

Prueba t de muestras independientes

Chequeamos normalidad: Group M

shapiro.test(subset(genderweight, group == "M")$weight)     

    Shapiro-Wilk normality test

data:  subset(genderweight, group == "M")$weight
W = 0.98634, p-value = 0.9886

Chequeamos normalidad: Group F

shapiro.test(subset(genderweight, group == "F")$weight)     

    Shapiro-Wilk normality test

data:  subset(genderweight, group == "F")$weight
W = 0.93847, p-value = 0.2243

Chequeamos la homogeneidad de las varianzas

var.test(genderweight$weight ~ genderweight$group)

    F test to compare two variances

data:  genderweight$weight by genderweight$group
F = 0.21692, num df = 19, denom df = 19, p-value = 0.001648
alternative hypothesis: true ratio of variances is not equal to 1
95 percent confidence interval:
 0.08585766 0.54802553
sample estimates:
ratio of variances 
         0.2169152 
  • ¡La homogeneidad de las varianzas no se cumple! 😱

  • ¿Debemos transformar? No necesariamente

  • El no cumplir con el supuesto de la homogeneidad de varianzas no es un gran problema gracias a varias correcciones.

  • La función base de R t.test cuenta con el argumento var.equal = F como default.

  • Bajo este argumento, no se asumen varianzas iguales entre los grupos y en su lugar R lleva a cabo la aproximación de Welch para lidiar con este problema.

Prueba t de muestras independientes

t.test(genderweight$weight ~ genderweight$group)

    Welch Two Sample t-test

data:  genderweight$weight by genderweight$group
t = -20.791, df = 26.872, p-value < 2.2e-16
alternative hypothesis: true difference in means between group F and group M is not equal to 0
95 percent confidence interval:
 -24.53135 -20.12353
sample estimates:
mean in group F mean in group M 
       63.49867        85.82612 

Ejercicio 4.4

La tabla de datos normtemp de la librería UsingR tiene las medidas en grados Fahrenheit de temperatura corporal (columna “temperature” ) correspodientes a 65 mujeres y 65 hombres (columna “gender”). Determina si existe una diferencia entre las temperaturas corporales de hombres y mujeres.

Copia y pega las siguientes líneas de código a tu script. Luego de ejecutarlas, una tabla de datos de nombre normtemp aparecerá disponible en la ventana del ambiente de RStudio

data(normtemp)
normtemp

Tip: para acceder a las columnas con las temperaturas corporales y sexo, usa la siguiente sintaxis: normtemp$temperature y normtemp$gender respectivamente

Prueba t para muestras emparejadas

  • Es usado para comparar las medias de dos grupos que guardan una relación.

  • Esto solo ocurre cuando las medidas se han realizado a partir de los mismos grupos. Por ejemplo, al inicio y al final de un experimento.

  • Para esta prueba, vamos a usar la tabla de datos crime de la librería UsingR

    • Veamos si existe una diferencia en las tasas de crimen (# de reportes/100000 habitantes) en 50 estados de los Estados unidos entre 1983 y 1993
data(crime)

Prueba t para muestras emparejadas

t.test(x = log(crime$y1983), y = log(crime$y1993), paired = TRUE)
exp(mean(log(crime$y1983)))
exp(mean(log(crime$y1993)))

Prueba t para muestras emparejadas

t.test(x = log(crime$y1983), y = log(crime$y1993), paired = TRUE)

    Paired t-test

data:  log(crime$y1983) and log(crime$y1993)
t = -10.027, df = 50, p-value = 1.469e-13
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 -0.3628437 -0.2417349
sample estimates:
mean difference 
     -0.3022893 
exp(mean(log(crime$y1983)))
[1] 362.8298
exp(mean(log(crime$y1993)))
[1] 490.8915

Ejercicio 4.5

La tabla de datos mice2 de la librería datarium tiene las medidas del peso de 10 ratones antes y después de haber sido sometidos a una determinada dieta. Encuentra si existe una diferencia significativa en el peso de estos ratones antes y después del régimen de dieta al que fueron expuestos. ¿Ganaron o perdieron peso?

Copia y pega las siguientes líneas de código a tu script. Luego de ejecutarlas, una tabla de datos de nombre mice2 aparecerá disponible en la ventana del ambiente de RStudio

data(mice2)
mice2

Tip: usa el mismo tips de los ejemplos anteriores

Ejercicios 4.6

  • En la librería UsingR tenemos disponible una lista con 5 objetos bajo el nombre cancer. Esta contiene el tiempo de sobreviviencia en días de pacientes con distintos tipos de cáncer desde el momento de su diagnóstico hasta su deceso. Chequea si los datos correspondientes a cáncer de colon son normalmente distribuidos. Si no lo son, prueba si puedes normalizarlos usando alguna de las tres transformaciones que vimos. En el caso que más de una transformación funcione, ¿cuál escogerías para continuar con alguna prueba estadística, y por qué?

Tip: usa el siguiente código para extraer en un vector los datos de pacientes con cáncer de colon:

data(cancer)
colon <- cancer$colon

Pruebas estadísticas no paramétricas

Pruebas de Wilcoxon para datos no normales

  • Las pruebas de Wilcoxon usan la mediana como criterio para evaluar la \(H_0\).

  • Lastimosamente, estas pruebas son usualmente menos poderosas (mayor tasa de errores tipo II).

  • Tiene dos formas:

    • Pruebas para una muestra (análoga a la prueba t para una muestra)

    • Pruebas para dos muestras (análoga a las pruebas t para dos muestras independientes y emparejadas)

Prueba de Wilcoxon para una muestra

  • Prof. Danielle Navarro midió el nivel de felicidad de sus estudiantes antes y después de su clase de Estadística. Ella estaba interesada en saber si el tomar una clase de Estadística tiene algún efecto en la felicidad de sus estudiantes. Los datos que obtuvo no están normalmente distribuidos. Por ello, se vio en la necesidad de llevar a cabo una prueba de Wilcoxon.

  • En este caso, la \(H_0\), es que la diferencia de la mediana de la felicidad de sus estudiantes antes y después de la clase debería ser igual a cero para clamar que no existe tal efecto.

Prueba de Wilcoxon para una muestra

# Primero recreo la tabla de Prof. Navarro
felicidad <- data.frame(before = c(30,43,21,24,23,40,29,56,38,16),
                        after = c(6,29,11,31,17,2,31,21,8,21))
felicidad$change <- felicidad$after - felicidad$before

wilcox.test(felicidad$change, mu = 0)

    Wilcoxon signed rank exact test

data:  felicidad$change
V = 7, p-value = 0.03711
alternative hypothesis: true location is not equal to 0

Prueba de Wilcoxon para dos muestras

  • Regresando al ejemplo de la tabla de datos genderweight, supongamos que estos no están normalmente distribuidos.

  • Usaremos la prueba de Wilcoxon para muestras independientes para ver si existe diferencia entre los pesos de hombres y mujeres.

wilcox.test(genderweight$weight ~ genderweight$group, paired = F)

    Wilcoxon rank sum exact test

data:  genderweight$weight by genderweight$group
W = 0, p-value = 1.451e-11
alternative hypothesis: true location shift is not equal to 0

Ejercicios 4.7

  • Con el vector de nombre colon que creaste en el ejercicio 4.6, aplica una prueba de Wilcoxon para una muestra bajo la hipótesis de que la mediana de los días de superviviencia de un paciente con cáncer de colon es de 370 días.

  • A partir de la tabla de datos de felicidad de la Prof. Navarro, lleva a cabo una prueba de Wilcoxon para dos muestras emparejadas de la felicidad de los estudiantes antes y después de recibir una clase de Estadística. Compara el resultado con la prueba de una muestra que usé de ejemplo. ¿Por qué no hay diferencia?.

Pruebas para datos discretos

Introducción

  • Para valores discretos univariados tenemos:

    • Estadísticos descriptivos

    • Prueba de bondad de ajuste de \(\chi^2\)

  • Para datos discretos bivariados arreglados en Tablas de contingencia tenemos:

    • Prueba de independencia de \(\chi^2\)

    • Prueba exacta de Fisher

Revisitando los estadísticos descriptivos

  • Recordarán que en módulo de análisis exploratorio de datos vimos los estadísticos descriptivos usando la función base summary.

  • Sin embargo, para los fines del AED, summary es suficiente para tener una idea de estos estadísticos pero su exportación a tablas de Word es un proceso tedioso.

  • Aprovechando esta oportunidad, vamos a ver una forma de ver a los estadísticos descriptivos con la posibilidad de exportarlos a Word de una manera sencilla.

  • Para ello usaremos la librería tidycomm, flextable y palmerpenguins.

library(tidycomm)
library(palmerpenguins)
library(flextable)

data("penguins")
penguins_cat <- describe_cat(penguins)
penguins_cat
# A tibble: 3 × 6
  Variable     N Missing Unique Mode   Mode_N
  <chr>    <int>   <int>  <int> <chr>   <int>
1 species    344       0      3 Adelie    152
2 island     344       0      3 Biscoe    168
3 sex        333      11      3 male      168

Tablas de estadísticos descriptivos

Tablas de estadísticos descriptivos de variables continuas

penguins_con <- describe(penguins)
penguins_con
# A tibble: 5 × 15
  Varia…¹     N Missing      M      SD    Min    Q25    Mdn    Q75    Max  Range
  <chr>   <int>   <int>  <dbl>   <dbl>  <dbl>  <dbl>  <dbl>  <dbl>  <dbl>  <dbl>
1 bill_l…   342       2   43.9   5.46    32.1   39.2   44.4   48.5   59.6   27.5
2 bill_d…   342       2   17.2   1.97    13.1   15.6   17.3   18.7   21.5    8.4
3 flippe…   342       2  201.   14.1    172    190    197    213    231     59  
4 body_m…   342       2 4202.  802.    2700   3550   4050   4750   6300   3600  
5 year      344       0 2008.    0.818 2007   2007   2008   2009   2009      2  
# … with 4 more variables: CI_95_LL <dbl>, CI_95_UL <dbl>, Skewness <dbl>,
#   Kurtosis <dbl>, and abbreviated variable name ¹​Variable
tabla1 <- flextable(penguins_cat)
tabla2 <- flextable(penguins_con)
tabla2

Variable

N

Missing

M

SD

Min

Q25

Mdn

Q75

Max

Range

CI_95_LL

CI_95_UL

Skewness

Kurtosis

bill_length_mm

342

2

43.92193

5.4595837

32.1

39.225

44.45

48.5

59.6

27.5

43.34125

44.50261

0.05288481

2.119235

bill_depth_mm

342

2

17.15117

1.9747932

13.1

15.600

17.30

18.7

21.5

8.4

16.94113

17.36121

-0.14283463

2.088845

flipper_length_mm

342

2

200.91520

14.0617137

172.0

190.000

197.00

213.0

231.0

59.0

199.41960

202.41081

0.34416383

2.012566

body_mass_g

342

2

4,201.75439

801.9545357

2,700.0

3,550.000

4,050.00

4,750.0

6,300.0

3,600.0

4,116.45833

4,287.05044

0.46826396

2.273757

year

344

0

2,008.02907

0.8183559

2,007.0

2,007.000

2,008.00

2,009.0

2,009.0

2.0

2,007.94228

2,008.11586

-0.05349321

1.499457

tabla1 <- flextable(penguins_cat)
tabla2 <- flextable(penguins_con)
tabla2 <- colformat_double(tabla2, j = c(3:15), digits = 2)
tabla2

Variable

N

Missing

M

SD

Min

Q25

Mdn

Q75

Max

Range

CI_95_LL

CI_95_UL

Skewness

Kurtosis

bill_length_mm

342

2

43.92

5.46

32.10

39.23

44.45

48.50

59.60

27.50

43.34

44.50

0.05

2.12

bill_depth_mm

342

2

17.15

1.97

13.10

15.60

17.30

18.70

21.50

8.40

16.94

17.36

-0.14

2.09

flipper_length_mm

342

2

200.92

14.06

172.00

190.00

197.00

213.00

231.00

59.00

199.42

202.41

0.34

2.01

body_mass_g

342

2

4,201.75

801.95

2,700.00

3,550.00

4,050.00

4,750.00

6,300.00

3,600.00

4,116.46

4,287.05

0.47

2.27

year

344

0

2,008.03

0.82

2,007.00

2,007.00

2,008.00

2,009.00

2,009.00

2.00

2,007.94

2,008.12

-0.05

1.50

save_as_docx("Tabla1" = tabla1, "Tabla2" = tabla2,
             path = "C:/Users/mmore/Documents/cursos_uce_2023/modulos/uce2023-modulo4/descriptivos.docx")

Prueba de bondad de ajuste \(\chi^2\)

  • Permite el comparar que tan bien se ajustan las proporciones (probabilidades) observadas en las categorías de una variable discreta con respecto de una probabilidad hipotética de estas.

  • Volviendo con los pingüinos de Palmer, supongamos que quisieramos probar que la distribución observada de estos a lo largo de las tres islas donde fueron encontrados es igual 1/3 por isla.

  • La \(H_0\) sería: encontramos la misma proporción de pingüinos en cada isla (1/3 = 1/3 = 1/3)

  • Checamos cuántos pingüinos fueron observados por isla
table(penguins$island)

   Biscoe     Dream Torgersen 
      168       124        52 
  • Llevamos a cabo la prueba de bondad de ajuste de \(\chi^2\)
penguins_isla <- c(168, 124, 52)
chisq.test(penguins_isla, p = c(1/3, 1/3, 1/3))

    Chi-squared test for given probabilities

data:  penguins_isla
X-squared = 59.814, df = 2, p-value = 1.027e-13

Tablas de contingencia

  • Una tabla de contigencia nos sirve para ver si los valores de una variable categórica dependen de los valores de otra variable categórica.

    • ¿Qué tan probable es que beban más alcohol personas que fuman con respecto a aquellas que no?

    • ¿Las personas que toman una aspirina diaria tienen menos probabilidad de sufrir un ataque cardíaco con respecto a las que no?

    • ¿Durante la tragedia del Titanic, tuvieron tanto hombres como mujeres los mismos chances de salvarse?

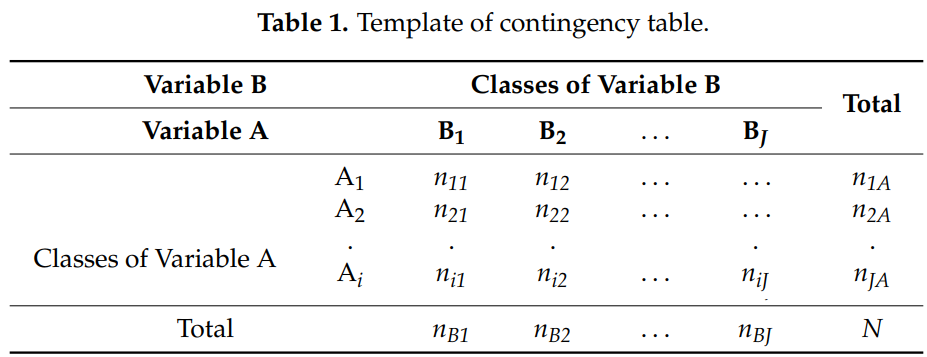
Tabla de contingencia \(n \times n\)

Prueba de independencia de \(\chi^2\)

  • Puede usarse con 2 variables discretas con más de dos categorías.

  • La \(H_0\) en esta prueba es que las filas y columnas de la tabla de contingencia son independientes.

  • Construimos la tabla de contingencia
cont_tabla <- xtabs(~ island + species, data = penguins)
cont_tabla
           species
island      Adelie Chinstrap Gentoo
  Biscoe        44         0    124
  Dream         56        68      0
  Torgersen     52         0      0
  • Llevamos a cabo la prueba de independencia de \(\chi^2\)
chisq <- chisq.test(cont_tabla)
chisq

    Pearson's Chi-squared test

data:  cont_tabla
X-squared = 299.55, df = 4, p-value < 2.2e-16

Dependencia entre las filas y las columnas

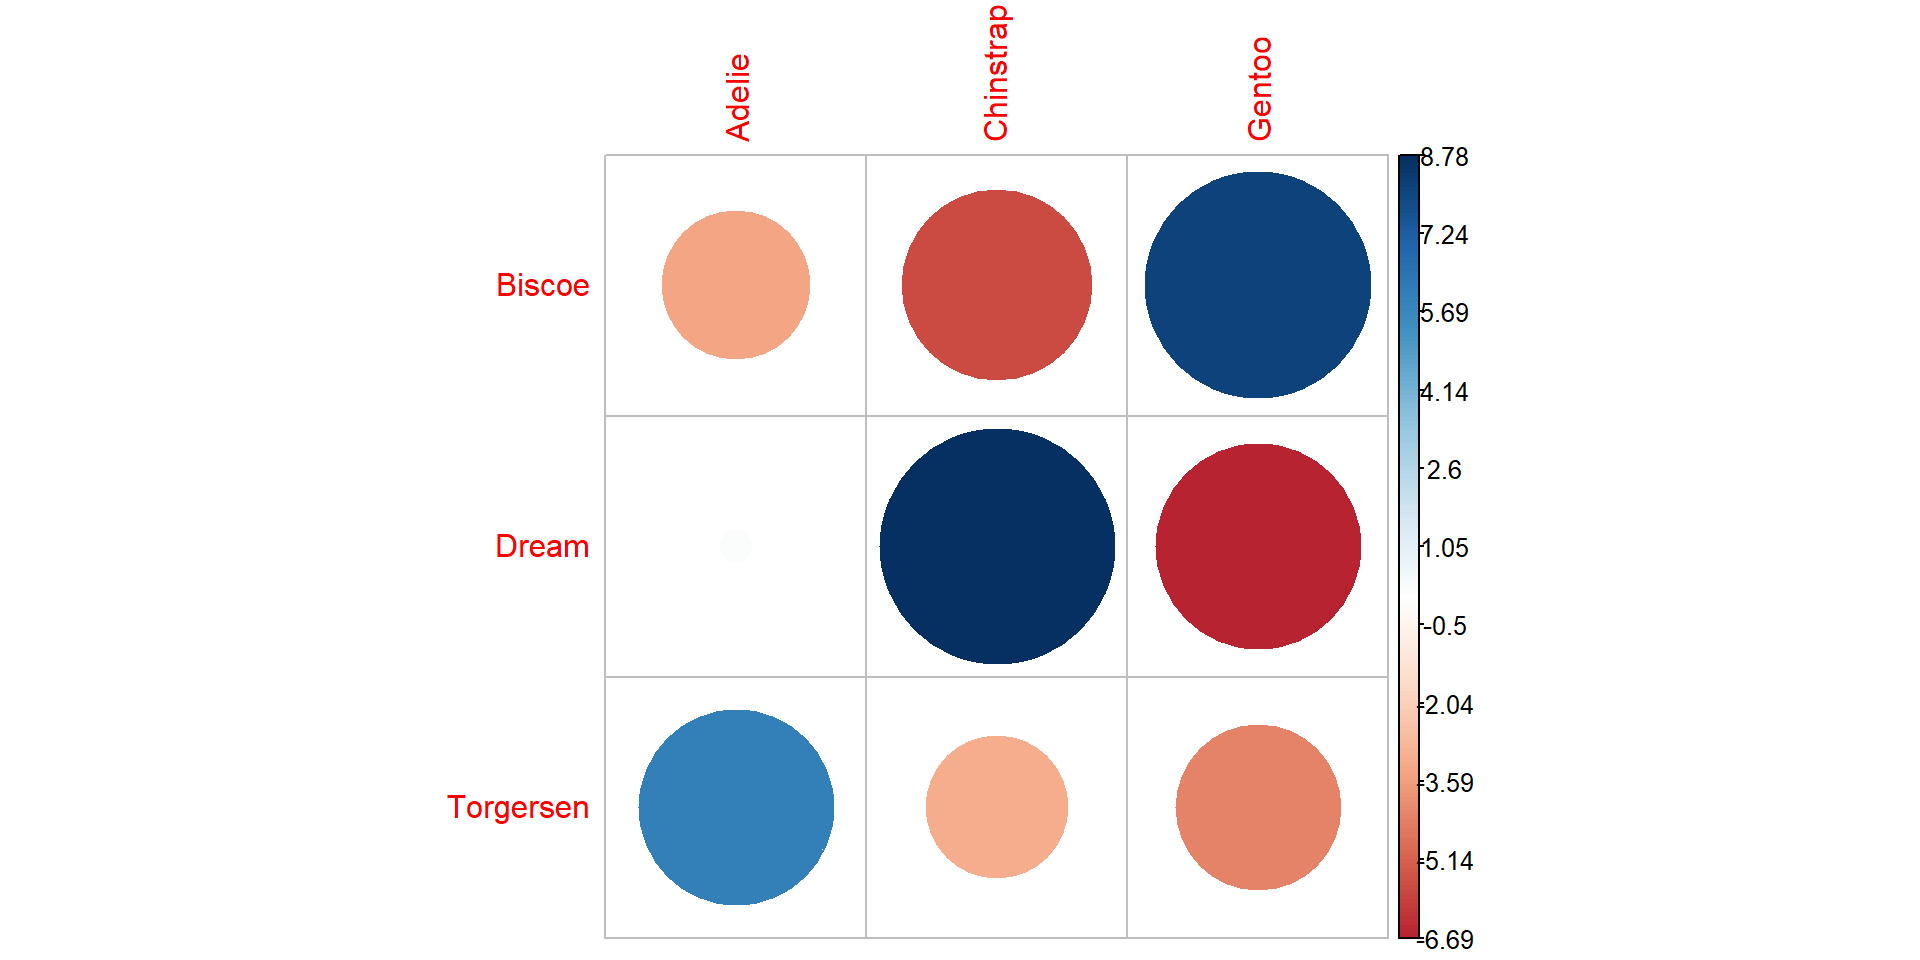
  • Extraemos los residuos (residuos) de la prueba \(\chi^2\)
residuos <- chisq$residuals
  • Con ayuda de la librería corrplot podemos ver a las dependencias una por una
library(corrplot)
corrplot(residuos, is.corr = F)

Ejercicio 4.8

La tabla de datos housetasks tiene una tabla de contingencia con dos variables discretas, en las filas: tareas del hogar, y en las columnas: responsable (de llevarlas a cabo). Las celdas de esta tabla cuentan el número de veces que estas preguntas fueron contestadas en una encuesta. Para acceder a esta tabla, copia, pega y ejecuta las siguientes líneas de código:

file_path <- "http://www.sthda.com/sthda/RDoc/data/housetasks.txt"
housetasks <- read.delim(file_path, row.names = 1)

Realiza una prueba de independencia de \(\chi^2\) en esta tabla de contigencia.

Prueba exacta de Fisher

  • Es usada cuando el conteo de las combinaciones de las clases de dos variables discretas es pequeño. Cuando este número es muy grande, la función de R fisher.test devuelve un mensaje sugiriendo usar otra prueba estadística en su lugar.

  • También se puede usar cuando las variables discretas tienen varias categorías. Sin embargo, su uso más común es en tablas de contingencia 2 .

  • Esto último por cuánto introduce un estadístico conocido como cociente de probabilidades (en inglés: odds ratio) que sirve para hacer conclusiones interesantes.

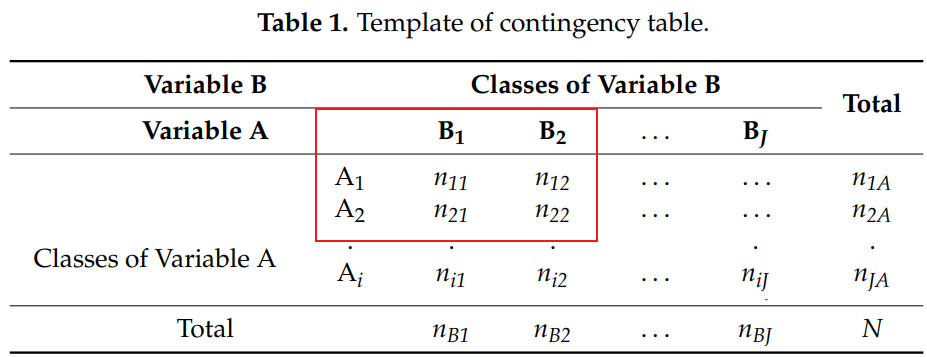
Tabla de contingencia \(2 \times 2\)

  • La variable B (o respuesta) contendrá como posibles resultados “éxito” o “fracaso”.

  • La variable A (o explanatoria) posee las clases que identifican los grupos cuya probabilidad es sujeto de comparación.

Cociente de probabilidad para tablas de contingencia \(2 \times 2\)

  • El cociente de probabilidad mide la magnitud de asociación entre dos variables categóricas cuando estas tienen dos clases (categorías).

  • En una tabla de contingencia \(2 \times 2\), el cociente de probabilidad (OR) se define como:

\[ OR=\frac{n_{11}/n_{12}}{n_{21}/n_{22}} \]

Cociente de probabilidad para tablas de contingencia \(2 \times 2\)

  • La interpretación del OR depende de la magnitud del mismo:

    • Igual a 1, los eventos (clase de la variable explanatoria) son independientes de la variable de respuesta.

    • Mayor o menor a 1, existe una relación positiva o negativa de la variable explanatoria con la variable de respuesta.

    • La magnitud de OR depende de la clase tomada como referencia en el análisis.

    • Los coecientes de probabilidad son más fáciles de interpretar cuando son \(\ge\) 1

Cociente de probabilidad en R

Usaremos para este ejemplo los datos del Titanic. La pregunta de investigación es: ¿tuvieron las mujeres mayores chances de salvarse durante el hundimiento del Titanic?

  1. Cargamos en nuestro ambiente la tabla de datos (librería datarium)
data(titanic.raw)
  1. Definimos las clases de referencia
titanic.raw$Survived <- relevel(titanic.raw$Survived, ref = "Yes")
titanic.raw$Sex <- relevel(titanic.raw$Sex, ref = "Female")

Cociente de probabilidad en R

  1. Creamos la tabla de contingencia
tabla_cont <- table(titanic.raw$Sex, titanic.raw$Survived)


tabla_cont
        
          Yes   No
  Female  344  126
  Male    367 1364
  1. Calculamos el OR
oddratio <- fisher.test(tabla_cont)


oddratio 

    Fisher's Exact Test for Count Data

data:  tabla_cont
p-value < 2.2e-16
alternative hypothesis: true odds ratio is not equal to 1
95 percent confidence interval:
  7.97665 12.92916
sample estimates:
odds ratio 
   10.1319 

¿Cómo interpretamos estos resultados?


oddratio

    Fisher's Exact Test for Count Data

data:  tabla_cont
p-value < 2.2e-16
alternative hypothesis: true odds ratio is not equal to 1
95 percent confidence interval:
  7.97665 12.92916
sample estimates:
odds ratio 
   10.1319 
  • Vemos que el cociente de probabilidad (OR) es 10. La interpretación es: durante el hundimiento del Titanic fue 10 veces más probable que un pasajero se salve si este era mujer.

  • Adicionalmente, del valor p de la prueba estadística exacta de Fisher menor al 0.05, se puede concluir que este cociente de probabilidad es significativo. En otras palabras, existe evidencia estadística significativa para afirmar que las probabilidades de sobrevivir durante el hundimiento del Titanic fueron 10 veces más para pasajeras mujeres en comparación a los hombres.

Análisis de Varianza (ANOVA)

Introducción

  • Hasta el momento nos hemos enfocado a los casos donde comparamos las medias entre dos grupos.

  • Pero es más común el evaluar distintos tratamientos al mismo tiempo, como ya vimos en el módulo 2 del curso.

  • Para ello, contamos con el ANOVA, desarrollado por el estadístico Ronald Fisher a inicios del siglo 20, y que sin duda es el método estadístico más usado hoy en día.

  • Su nombre puede ser confuso. El objetivo de un ANOVA es el de determinar la existencia de diferencias entre las medias aritméticas de las muestras representativas de \(n\) poblaciones (o en términos más precisos, tratamientos).

Supuestos del ANOVA

  1. Independencia de los datos: conseguida mediante una correcta randomización y definición del experimento.

  2. Homogeneidad de las varianzas: la varianza entre los tratamientos es la misma.

  3. Normalidad: pero, ¿de qué exactamente?

  • Siempre ha existido una confusión de este supuesto. Cómo vimos antes, la normalidad es un requisito para conducir pruebas t, y lo es también para el ANOVA.

  • Muchos libros de texto y otros recursos, mencionan que los datos de cada tratamiento deben ser normalmente distribuidos para llevar a cabo un ANOVA. Esto es cierto e impráctico a la vez.

  • Mencionamos que como mínimo deberíamos contar con 3 repeticiones por tratamiento. Pero, ¿son 3 repeticiones suficientes para alcanzar la normalidad?

  • Es común el sugerir el llevar a cabo una prueba de normalidad antes de un ANOVA, pero esto tiene varios problemas que supongo no te han dicho antes:

    • Cada tratamiento tiene su propia media, en caso de medias muy distantes entre sí, la prueba puede fallar.

    • En su lugar, podrías correr una prueba por cada tratamiento. Esto solo funciona con un considerable número de observaciones/tratamiento (3 no son suficientes).

Supuestos del ANOVA

  • Esta confusión nos puede llevar a soluciones erróneas como transformar datos, borrar outliers o utilizar pruebas no paramétricas innecesariamente.

  • Entonces, ¿normalidad de qué?

  • De los residuos estandarizados!… ¿Qué es un residual?

    • Un residual es la diferencia entre una observación y su predicción

    • Un residual estandarizado resulta de la división del residual para la raíz cuadrada de la predicción

    • La distribución muestral de los residuos estandarizados tiene media 0 y desviación estándar 1

  • Y es sobre esta distribución que los valores críticos del ANOVA (valores F) son calculados. Es decir, estos no dependen enteramente de los datos originales, por lo tanto los datos originales no tienen que ser necesariamente normalmente distribuidos.

  • Pero, ¿por qué la confusión? Solo cuando el número de observaciones es lo suficientemente grande (y ya sabemos que distribución tiene la media muestral cuando el número incrementa), se tiene la certeza que los residuos serán normalmente distribuidos.

  • En resumen, es mejor chequear la normalidad después que realizamos el ANOVA.

El dataset de recursos por depredación

El dataset de recursos por depredación

  • Los datos que usaremos en esta y otras secciones corresponden a un experimento del Prof. Justin C. Touchon acerca de la interacción entre predadores y recursos.

  • El experimento consistió de múltiples tanques (mesocosmos) dispuestos al aire libre en Gamboa, Panamá. Los investigadores tenían por objetivo el saber como la variación en la incubación de huevos de la rana arbórea de ojos rojos podría afectar su desarrollo hasta la metamorfosis bajo varias combinaciones de recursos y predadores.

  • Los tratamientos fueron los siguientes:

    • Edad de incubación: Temprana (E: 4 días después de la oviposición) o tardía (L: 6 días después de la oviposición).

    • Predadores: control (C), no letal (NL: larvas de libélula enjauladas) y letal (L: larvas de libélula libres)

    • Recursos: bajo (Lo: 0.75 g) o alto (Hi: 1.5 g) de comida suministrados cada 5 días.

  • Los mesocosmos fueron colocados en 8 bloques de 12 tanques cada uno.

  • El experimento inició con 50 renacuajos por tanque y terminó cuando todos los renacuajos alcanzaron la metamorfosis, o murieron.

El dataset de recursos por depredación

  • Variables de respuesta:

    • Edad de metaformosis contada desde el día de oviposición (Age.DPO).

    • Edad de salida del agua (Age.FromEmergence)

    • Longitud nariz-cloaca al emerger (SVL.initial)

    • Longitud de la cola al emerger (Tail.initial)

    • Longitud nariz-cloaca al término de la reabsorción de la cola (SVL.final)

    • Peso al término de la reabsorción de la cola (Mass.final)

    • Número de días requeridos por cada metamorfo para reabsorber completamente la cola (Resorb.days)

  • 18 tanques conteniendo predadores no letales fueron descartados debido al brote de una enfermedad

  • NOTA: el dataset original de Touchon contiene alrededor de 2500 observaciones. Sin embargo, para poder usar los datos bajo los supuestos del ANOVA es necesario reducirlos a las medias aritméticas de cada tratamiento por cuanto se tratan de pseudo repeticiones. Esta reducción ya está hecha en el archivo “touchon.csv” disponible con el resto de materiales extras del curso.

Explorando este dataset

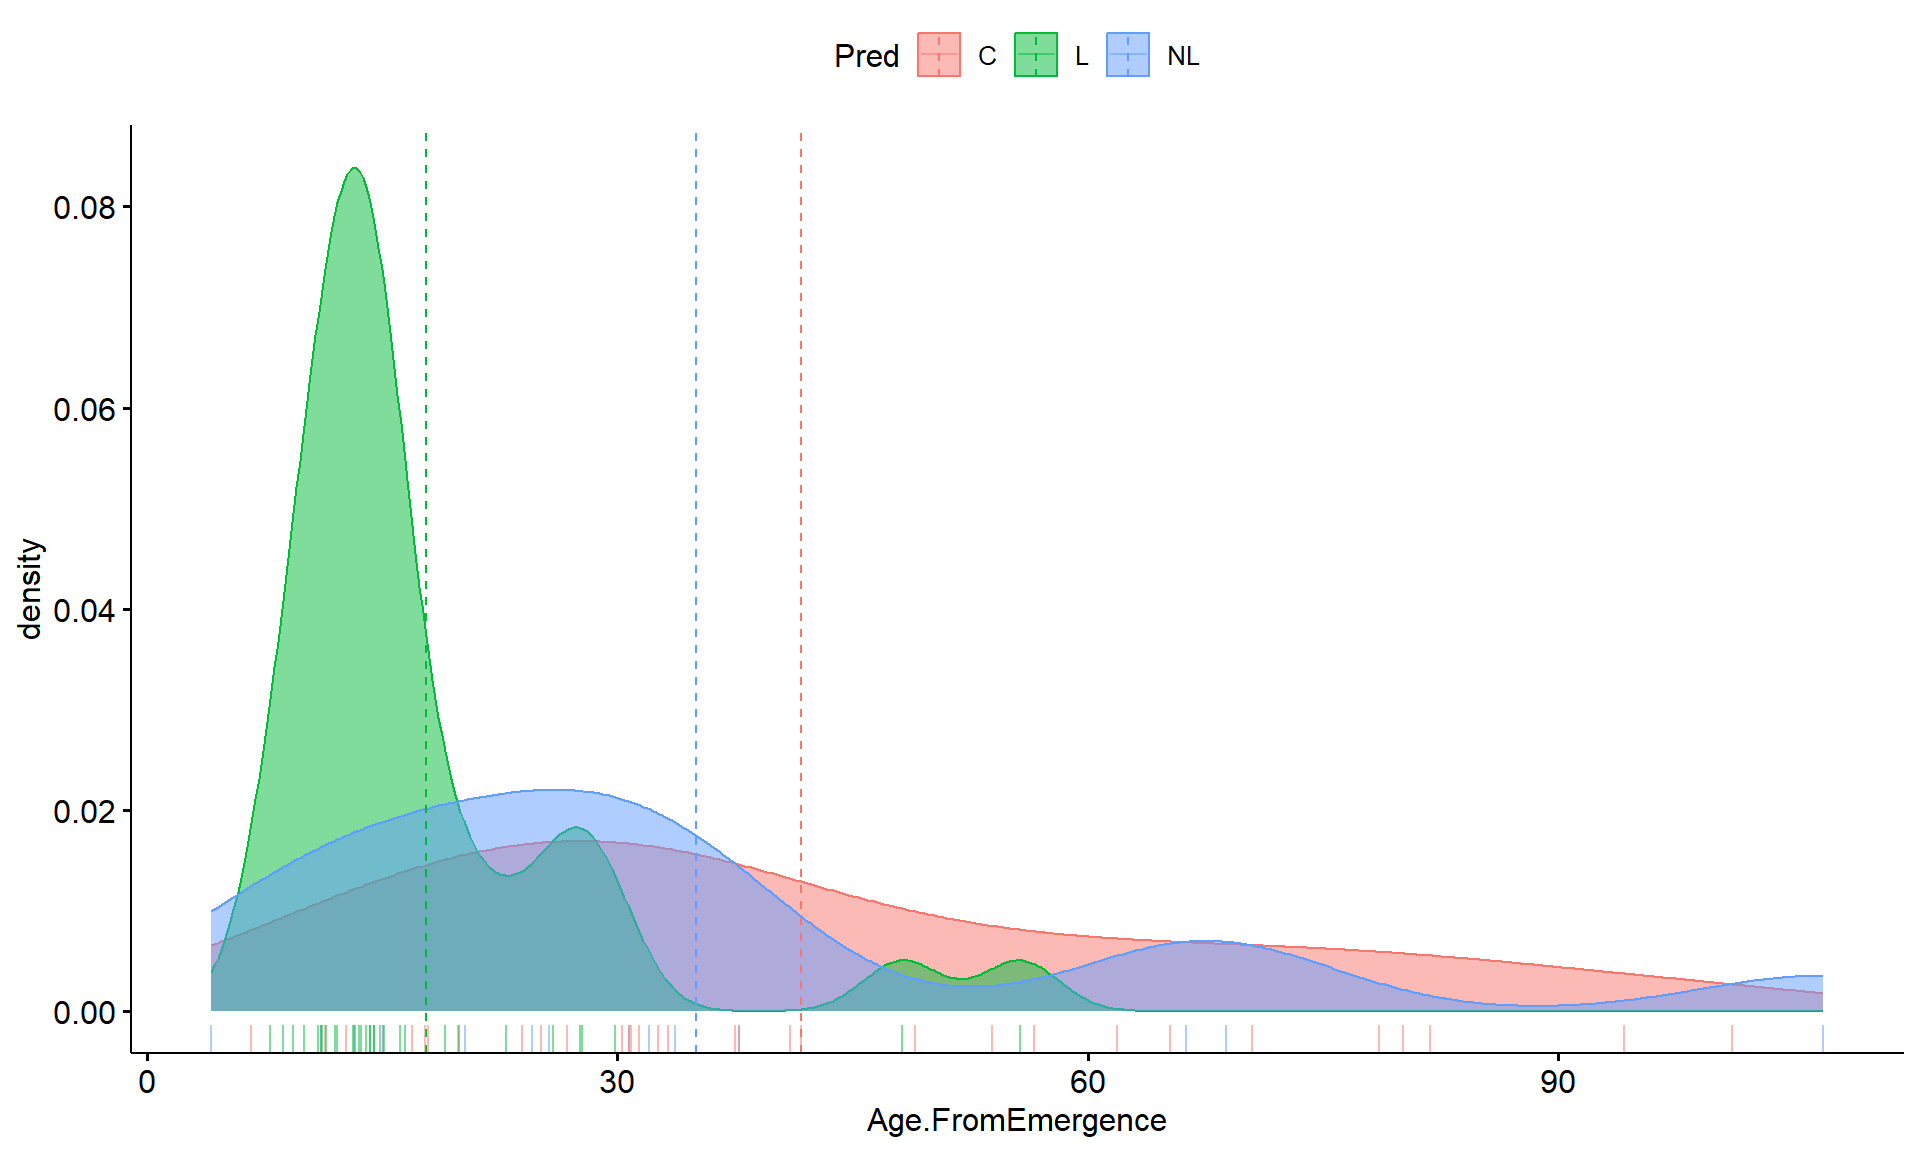
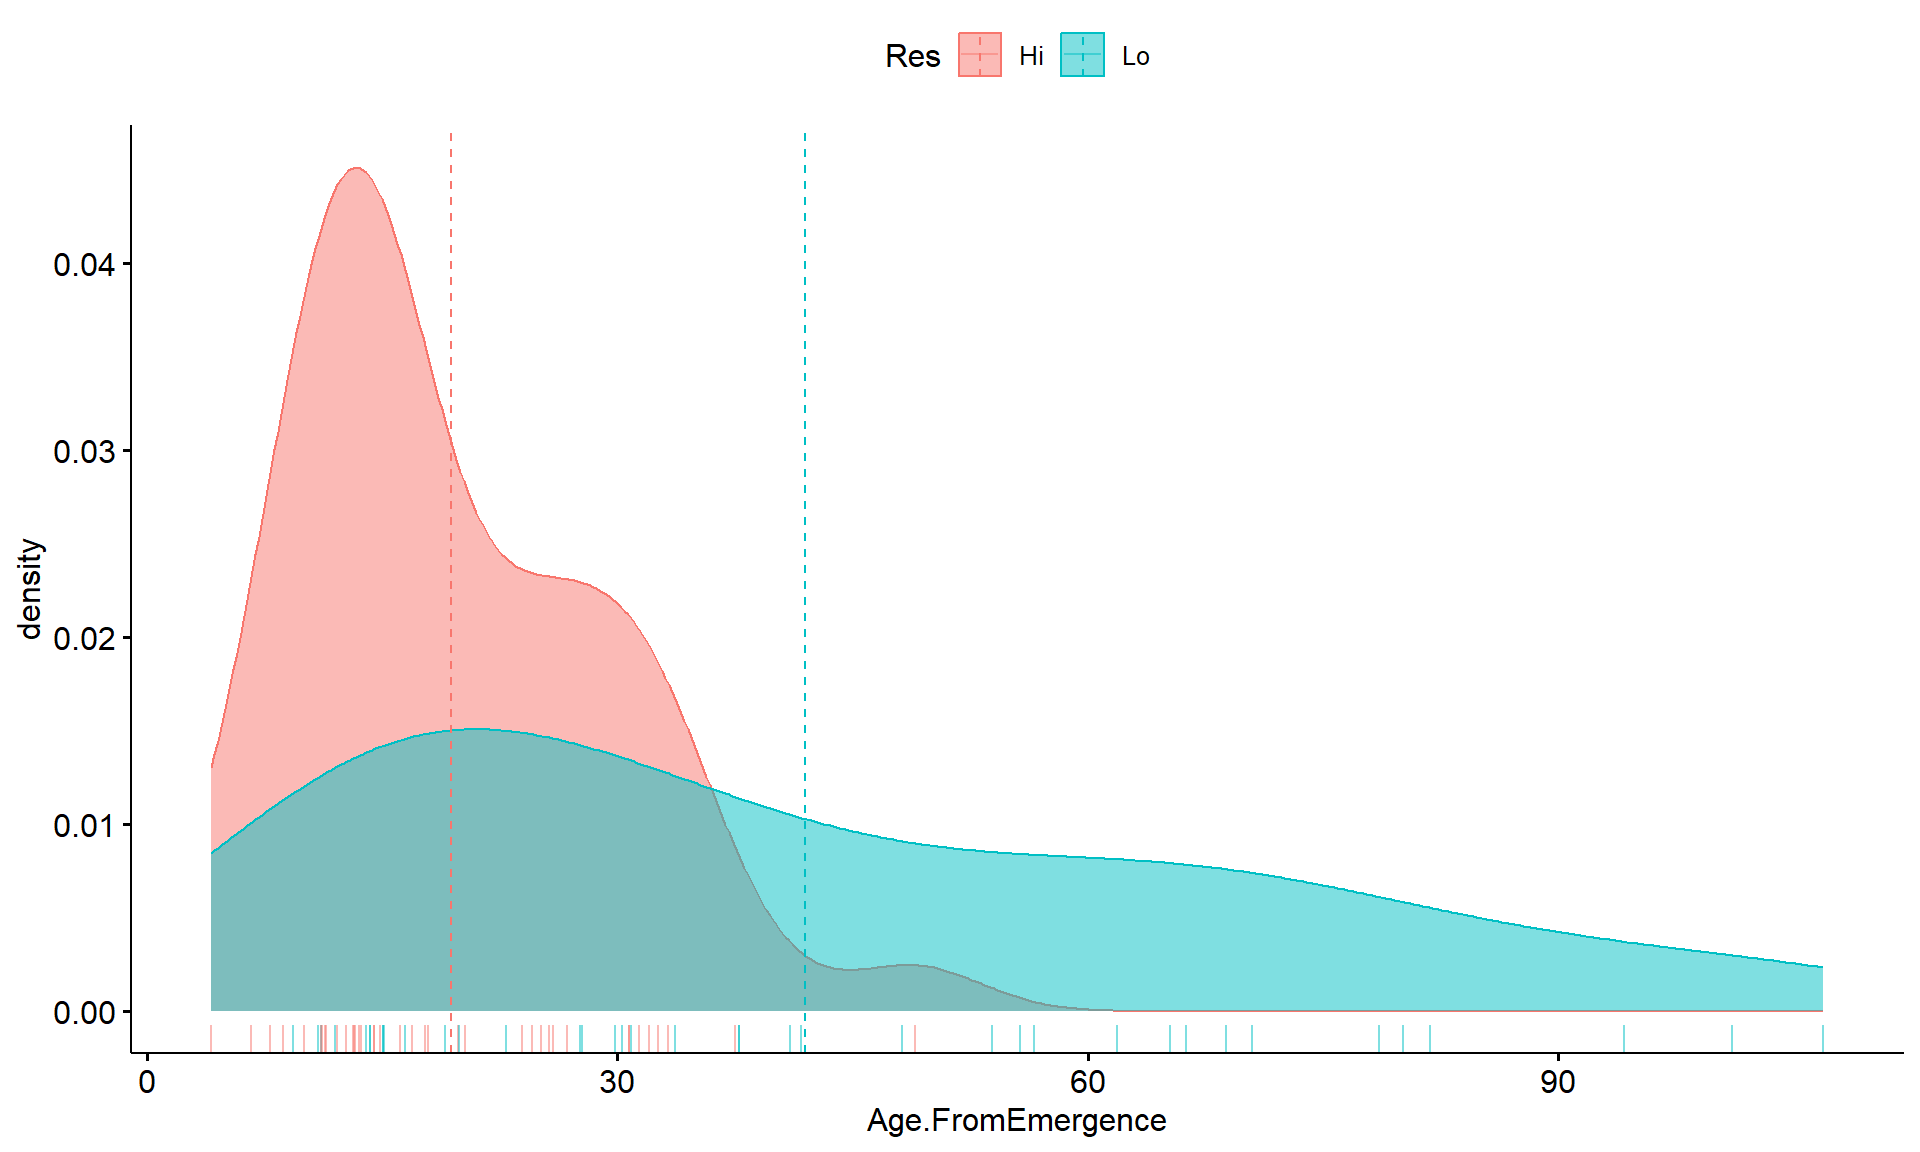
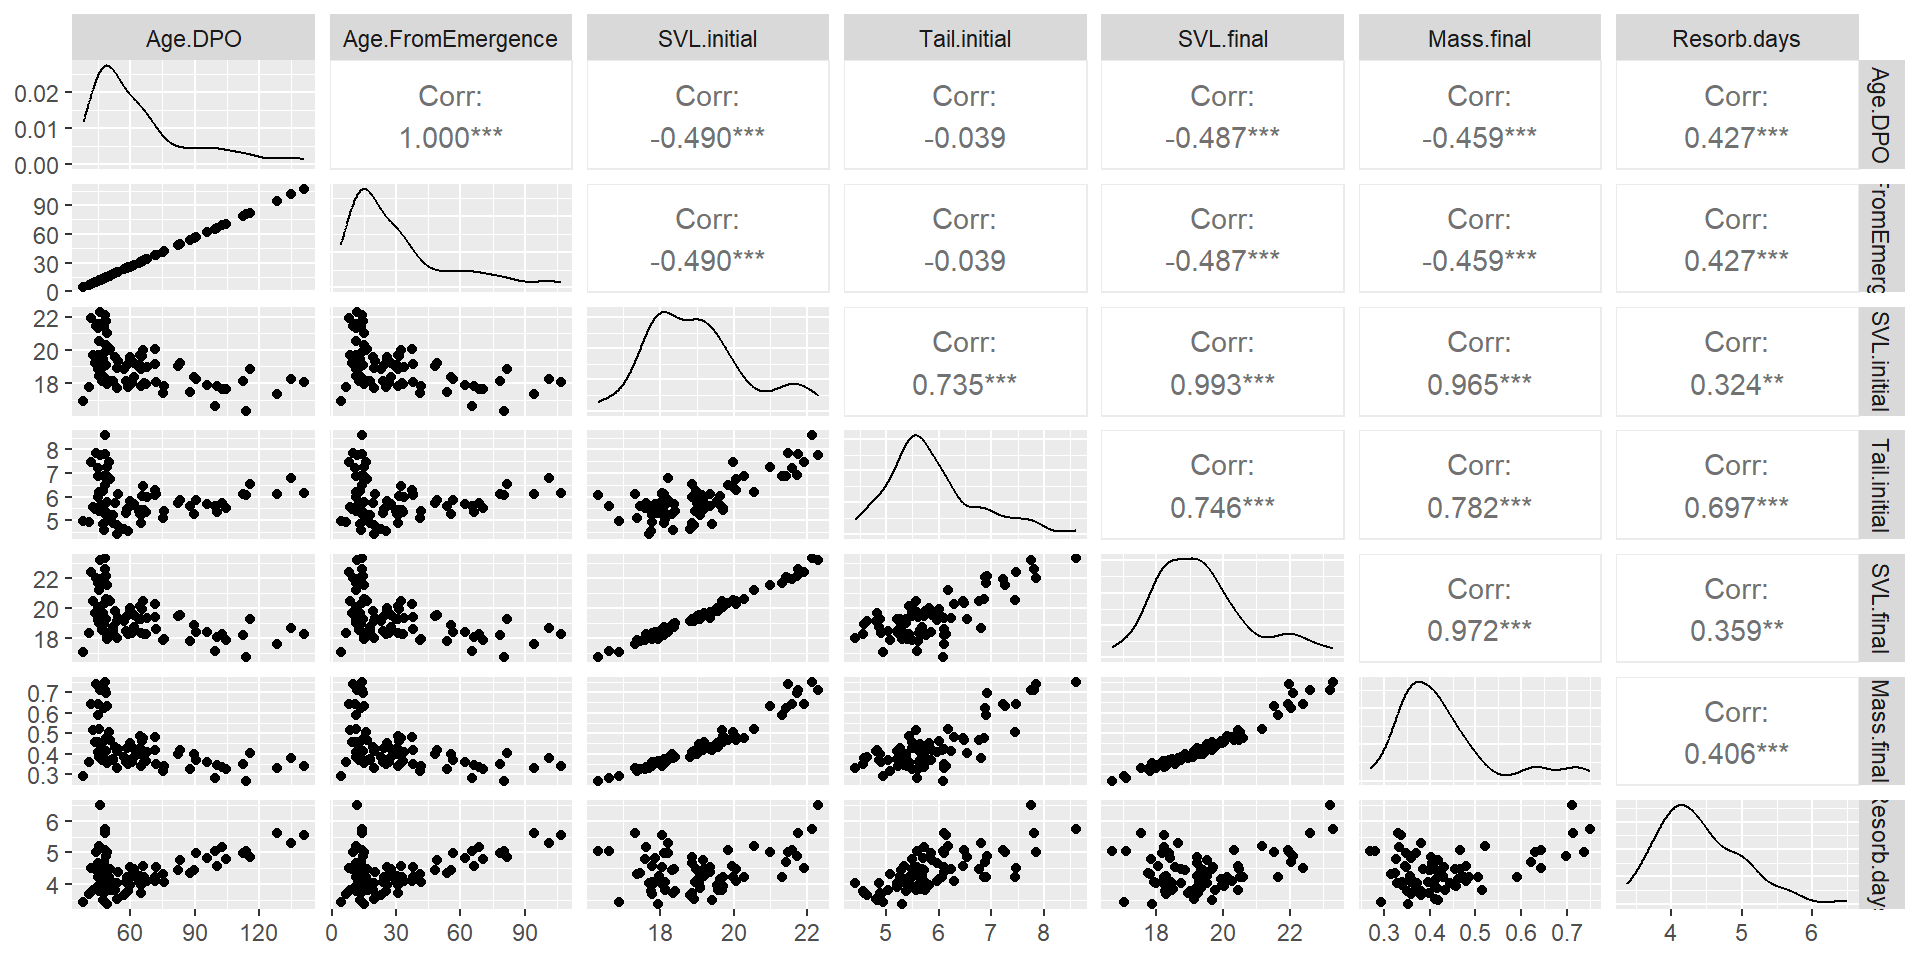
  • Haremos una exploración básica del dataset anteriormente descrito: gráficos de caja y bigote, de barras, de densidad y matrices de dispersión.

  • Como estos datos han sido pre-procesados, omitiremos el mapa de observaciones perdidas.

  • Para esto, aprovecho la oportunidad para introducir otro par de librerías útiles

  • Como vimos anteriormente, ggplot2 es una poderosa librería de visualización de datos cuyo uso es relativamente sencillo. Sin embargo, su dominio requiere un poco de tiempo y paciencia. Para quienes quizá deseen una manera más rápida de realizar sus gráficos y solamente tomarse el tiempo en añadir detalles finales, usaremos ggpubr.

Medias aritméticas observadas

# usaremos nuevamente la librería `tidycomm` para los estadísticos descriptivos
ranas <- read.csv("touchon.csv")
describe(ranas)
# A tibble: 9 × 15
  Varia…¹     N Missing      M     SD    Min    Q25    Mdn    Q75    Max   Range
  <chr>   <int>   <int>  <dbl>  <dbl>  <dbl>  <dbl>  <dbl>  <dbl>  <dbl>   <dbl>
1 Block      78       0  4.13   2.30   1      2      4      6       8      7    
2 Tank.U…    78       0 44.2   28.0    1     20.2   40.5   67.5    96     95    
3 Age.DPO    78       0 64.7   23.8   38.1   47.7   57.4   71.7   141.   103.   
4 Age.Fr…    78       0 30.7   23.8    4.11  13.7   23.4   37.7   107.   103.   
5 SVL.in…    78       0 19.0    1.34  16.3   18.0   18.9   19.7    22.3    5.98 
6 Tail.i…    78       0  5.87   0.845  4.41   5.33   5.68   6.16    8.6    4.19 
7 SVL.fi…    78       0 19.4    1.44  16.7   18.3   19.2   20.0    23.3    6.62 
8 Mass.f…    78       0  0.430  0.109  0.269  0.359  0.404  0.462   0.75   0.481
9 Resorb…    78       0  4.40   0.595  3.38   4.02   4.26   4.79    6.5    3.12 
# … with 4 more variables: CI_95_LL <dbl>, CI_95_UL <dbl>, Skewness <dbl>,
#   Kurtosis <dbl>, and abbreviated variable name ¹​Variable

Gráficos de barras

library(ggpubr)
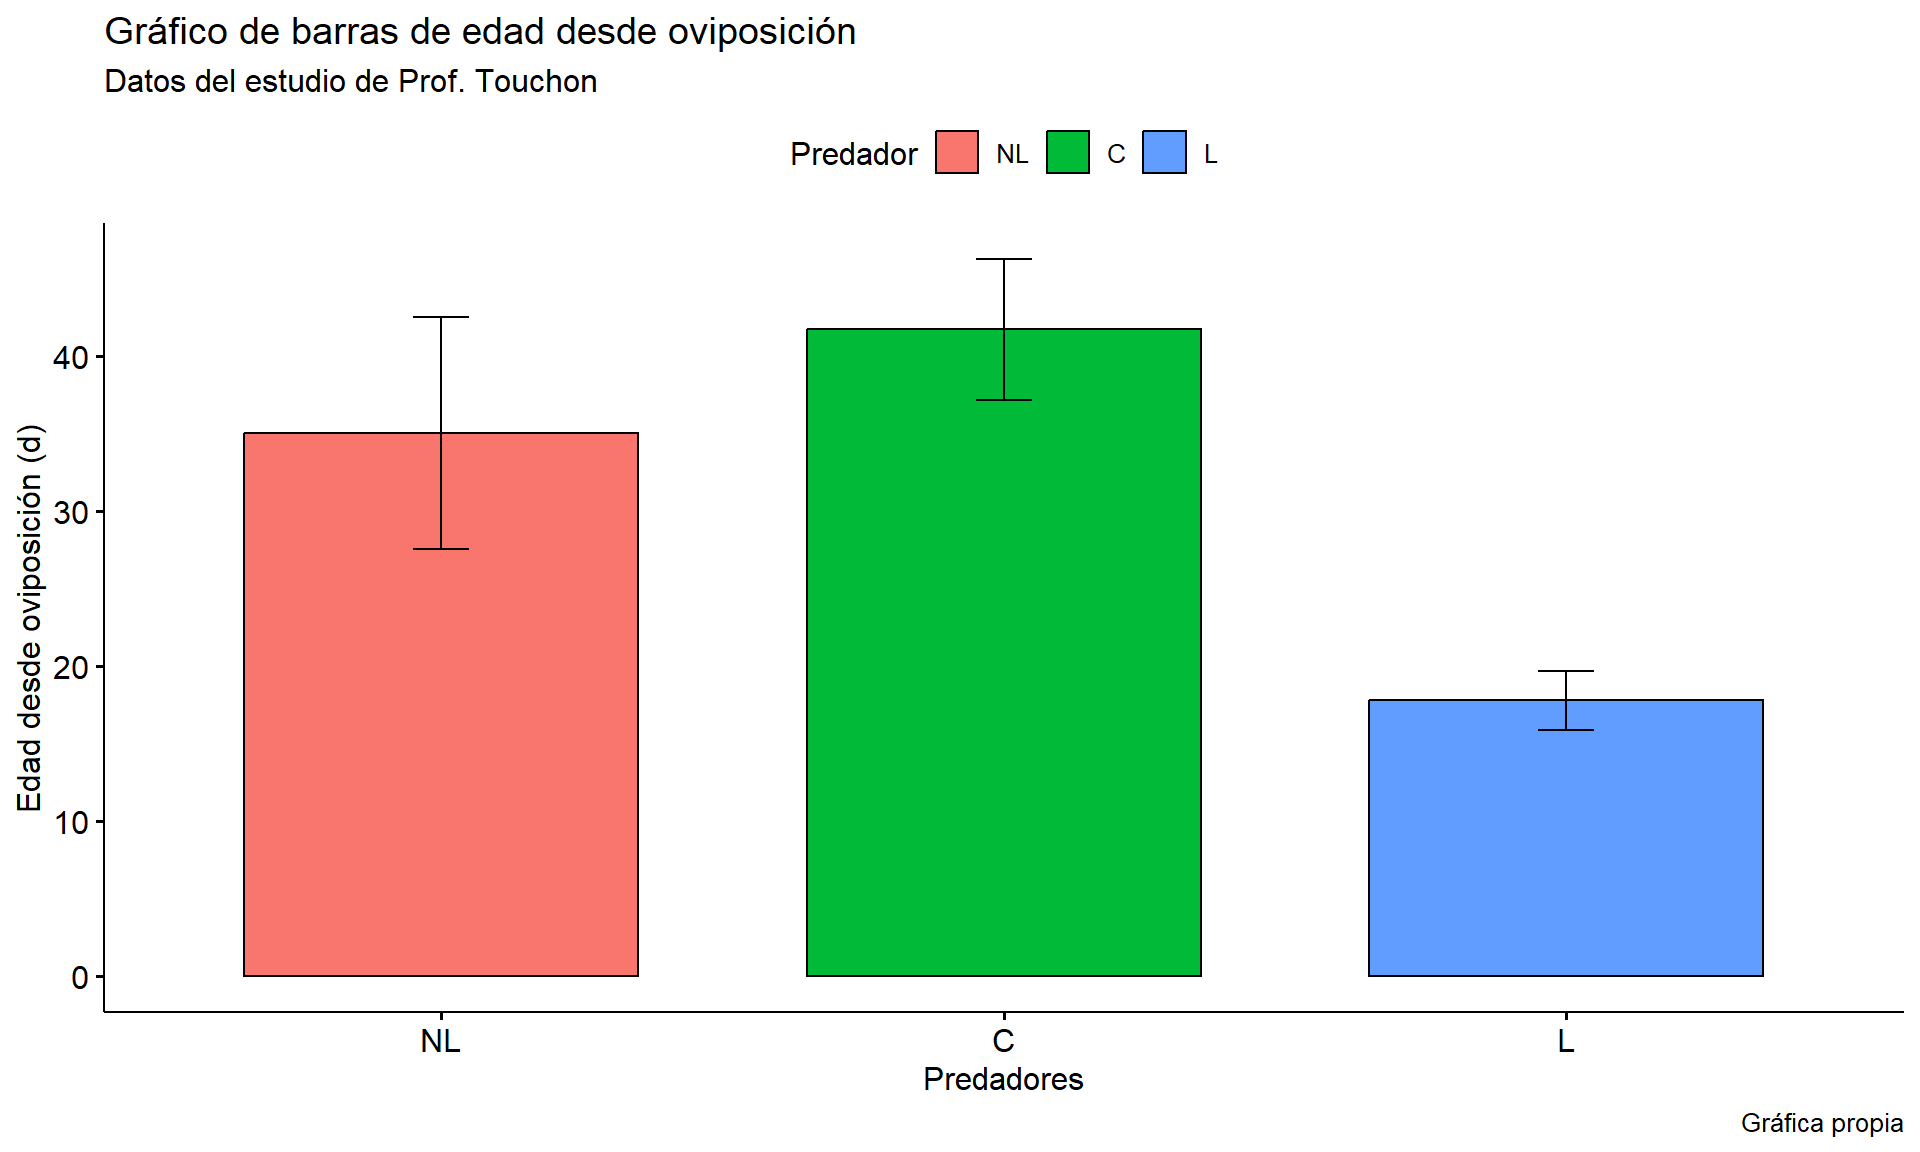
ggbarplot(data = ranas,
          x = "Pred",
          y = "Age.FromEmergence",
          add = "mean_se",
          fill = "Pred")

ggbarplot(data = ranas,
          x = "Res",
          y = "Age.FromEmergence",
          add = "mean_se",
          fill = "Pred")

Gráficos de barras

p1 <- ggbarplot(data = ranas,
                x = "Pred",
                y = "Age.FromEmergence",
                add = "mean_se",
                fill = "Pred")

p1 + labs(title = "Gráfico de barras de edad desde oviposición",
       subtitle = "Datos del estudio de Prof. Touchon",
       caption = "Gráfica propia",
       x = "Predadores",
       y = "Edad desde oviposición",
       color = "Predador")
Gráficos de caja y bigote

ggboxplot(data = ranas,
          x = "Pred",
          y = "Age.FromEmergence",
          fill = "Pred")

ggboxplot(data = ranas,
          x = "Res",
          y = "Age.FromEmergence",
          fill = "Res")

Gráficos de densidad

ggdensity(data = ranas,
          x = "Age.FromEmergence", 
          add = "mean", 
          rug = "true", 
          color = "Pred", 
          fill = "Pred")

ggdensity(data = ranas,
          x = "Age.FromEmergence", 
          add = "mean", 
          rug = "true", 
          color = "Res", 
          fill = "Res")

Matriz de dispersión

library(GGally)
ranas_matriz <- ranas[,c(6:12)]
ggpairs(ranas_matriz)

ANOVA de una vía

  • ANOVA de una vía se refiere cuando tenemos más de dos tratamientos que están definidos por un solo factor a la vez.

  • Usando los datos del Prof. Touchon, vamos a ilustrar el caso del ANOVA de una vía. Para ello, vamos a considerar lo siguiente

    • Supongamos que estamos interesados en saber si existe alguna diferencia entre la edad de salida del agua Age.FromEmergence determinada por los predadores:

    • Los niveles del factor predadores son:

      • Predadores no letales NL

      • Predadores letales L

      • Control (sin predadores) C

  • La \(H_0\) en todo ANOVA es simplemente que no existe diferencia entre \(n\) tratamientos, y la \(H_a\) es que al menos uno de los tratamientos tiene una media distinta.

ANOVA en R

  • Existen dos formas de llevar a cabo ANOVA en R:

    1. Crear un modelo lineal con la función lm y luego el ANOVA con la función anova sobre el objeto producto de lm.

    2. Aplicar directamente la función aov sobre nuestros datos.

  • Ambas funciones (lm y aov) tienen la misma sintaxis. Personalmente prefiero la primera opción.

  • Adicionalmente, la librería car ofrece la función Anova. El resultado de ambas es prácticamente el mismo para la mayoría de modelos. Sin embargo, personalmente prefiero Anova ya que permite realizar correcciones cuando tenemos datos no balanceados.

ANOVA de una vía en R

Opción 1

library(car)
lm1 <- lm(Age.FromEmergence ~ Pred, data = ranas)
Anova(lm1)

Opción 2

anova1 <- aov(Age.FromEmergence ~ Pred, data = ranas)
summary(anova1)
Anova Table (Type II tests)

Response: Age.FromEmergence
          Sum Sq Df F value    Pr(>F)    
Pred        9467  2  10.442 9.986e-05 ***
Residuals  33999 75                      
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
            Df Sum Sq Mean Sq F value   Pr(>F)    
Pred         2   9467    4733   10.44 9.99e-05 ***
Residuals   75  33999     453                     
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Diagnósticos del ANOVA

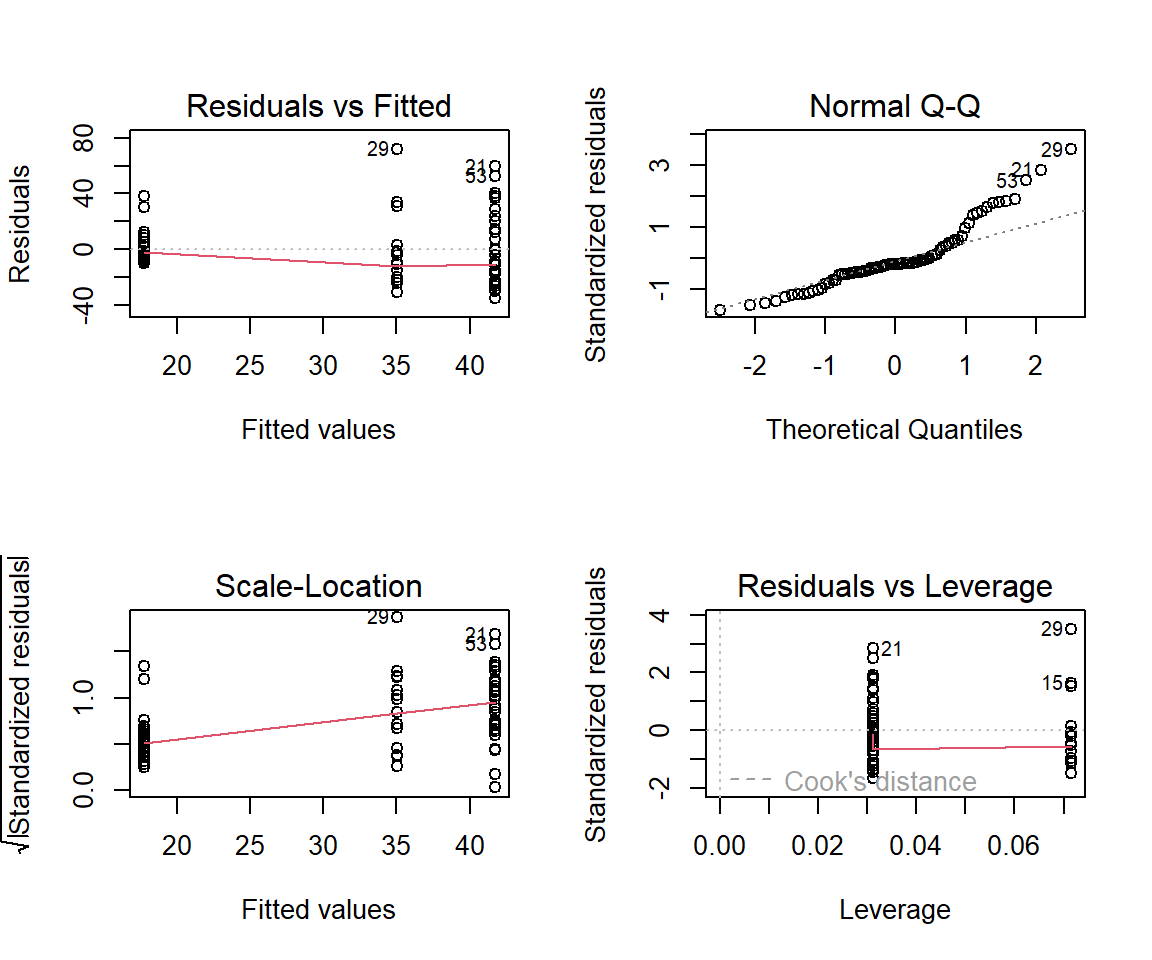
  • Antes de conducir pruebas formales para los supuestos del ANOVA, es preciso darle un vistazo a diagnósticos visuales que podemos obtener del mismo.

  • El ANOVA es un caso de regresión lineal (con predictores categóricos), por lo que en esta sección nos centraremos en la interpretación de estos diagnósticos desde la perspectiva del ANOVA.

  • En el apartado de regresión lineal volveremos a profundizar en las interpretaciones de los mismos para ese caso determinado.

  • Para acceder a estos diagnósticos, basta usar la función plot sobre el objeto donde guardamos los resultados del modelo lm1.

Diagnósticos del ANOVA

lm1 <- lm(Age.FromEmergence ~ Pred, data = ranas)
par(mfrow = c(2, 2))
plot(lm1)
par(mfrow = c(1, 1))

Diagnósticos del ANOVA

Diagnósticos del ANOVA

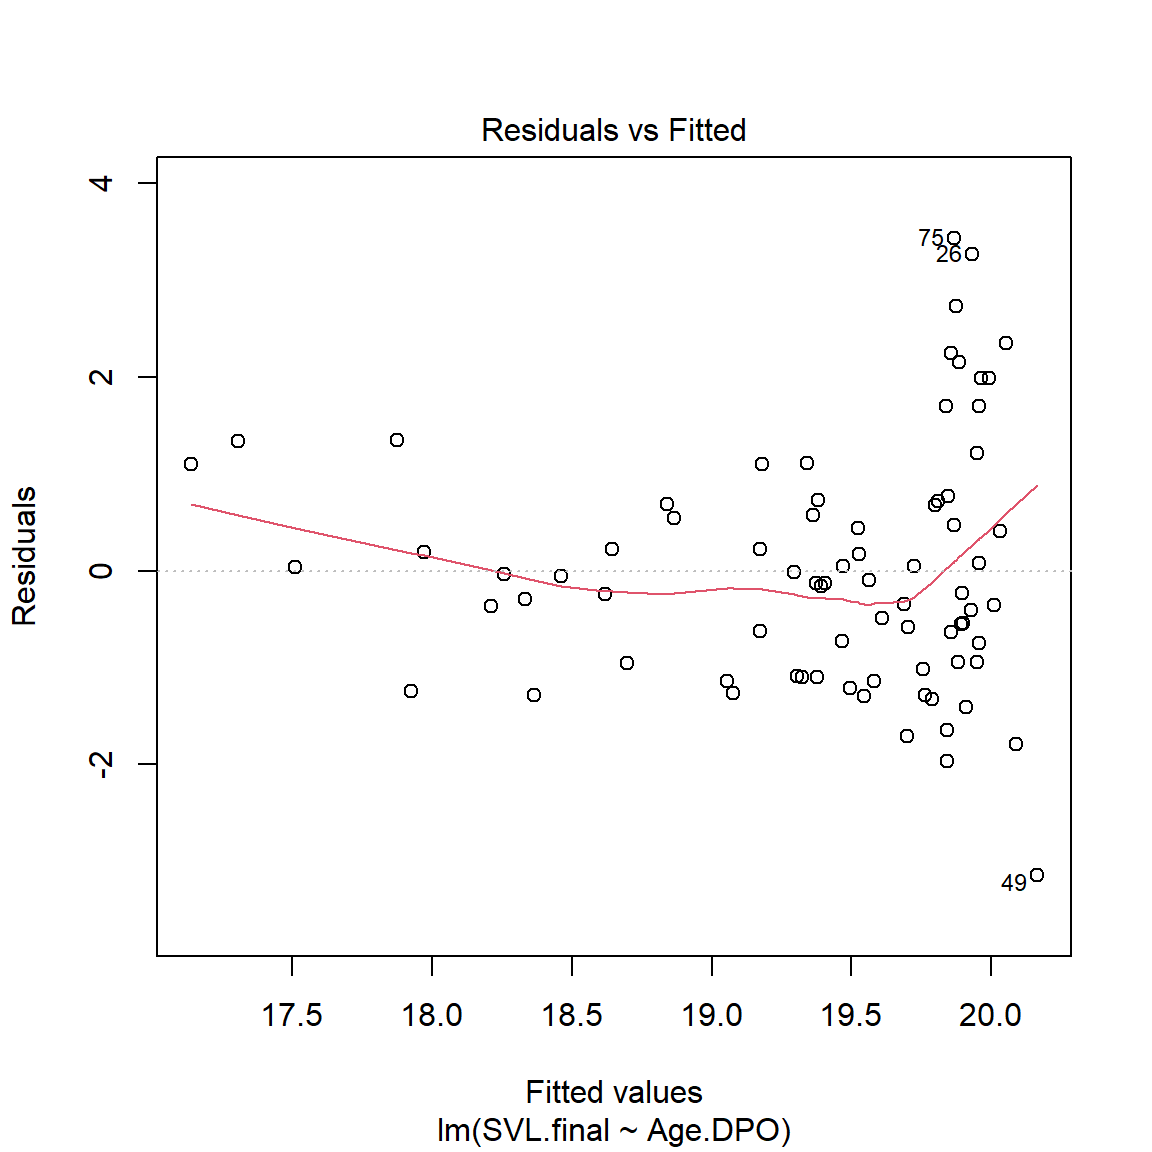
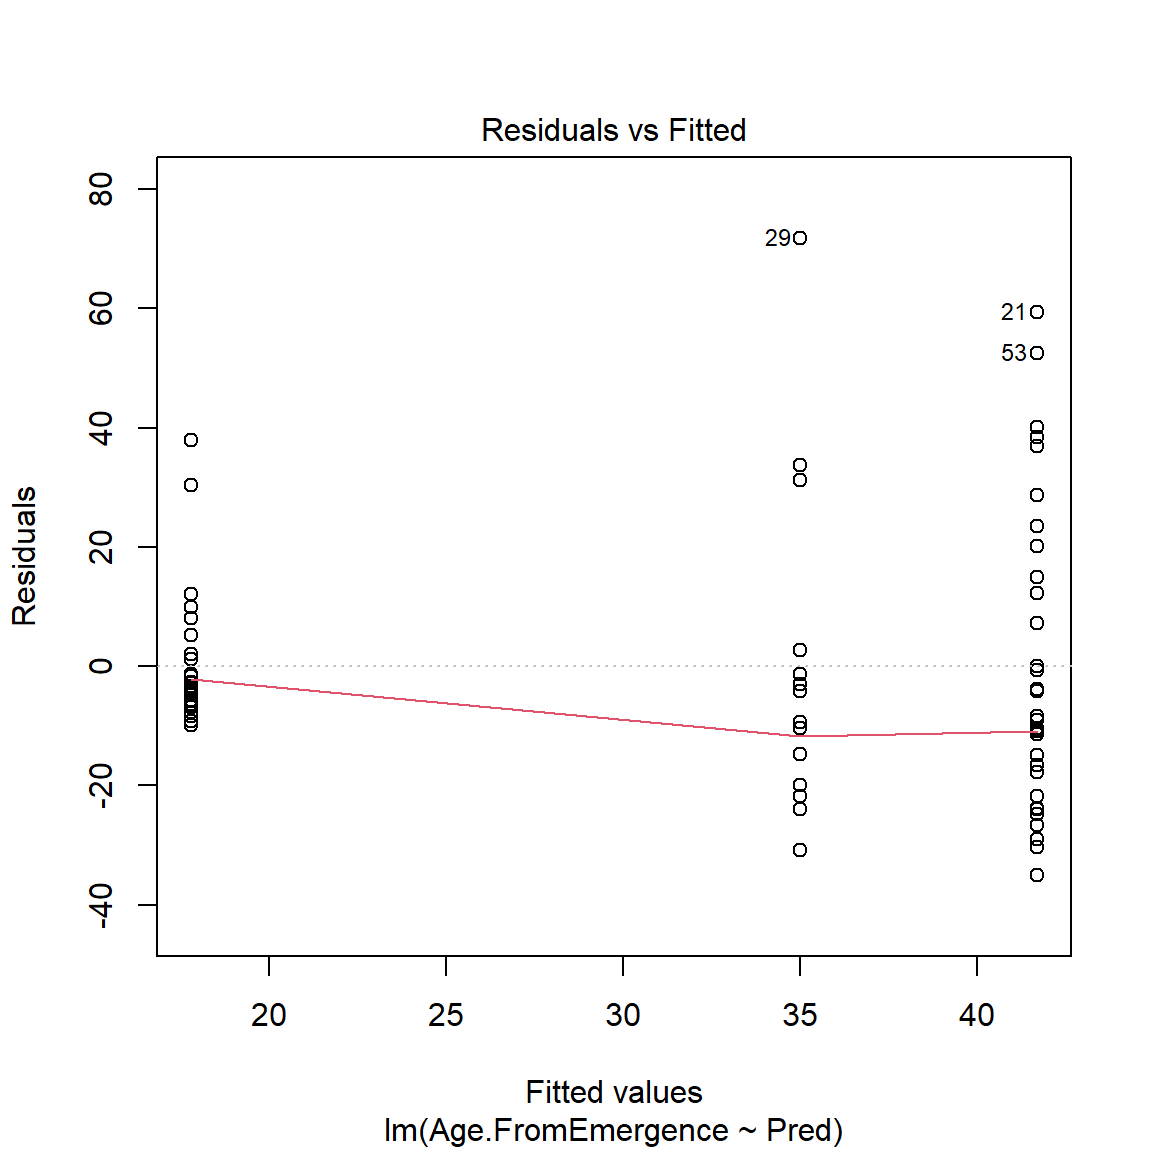
Residuos vs. Valores ajustados

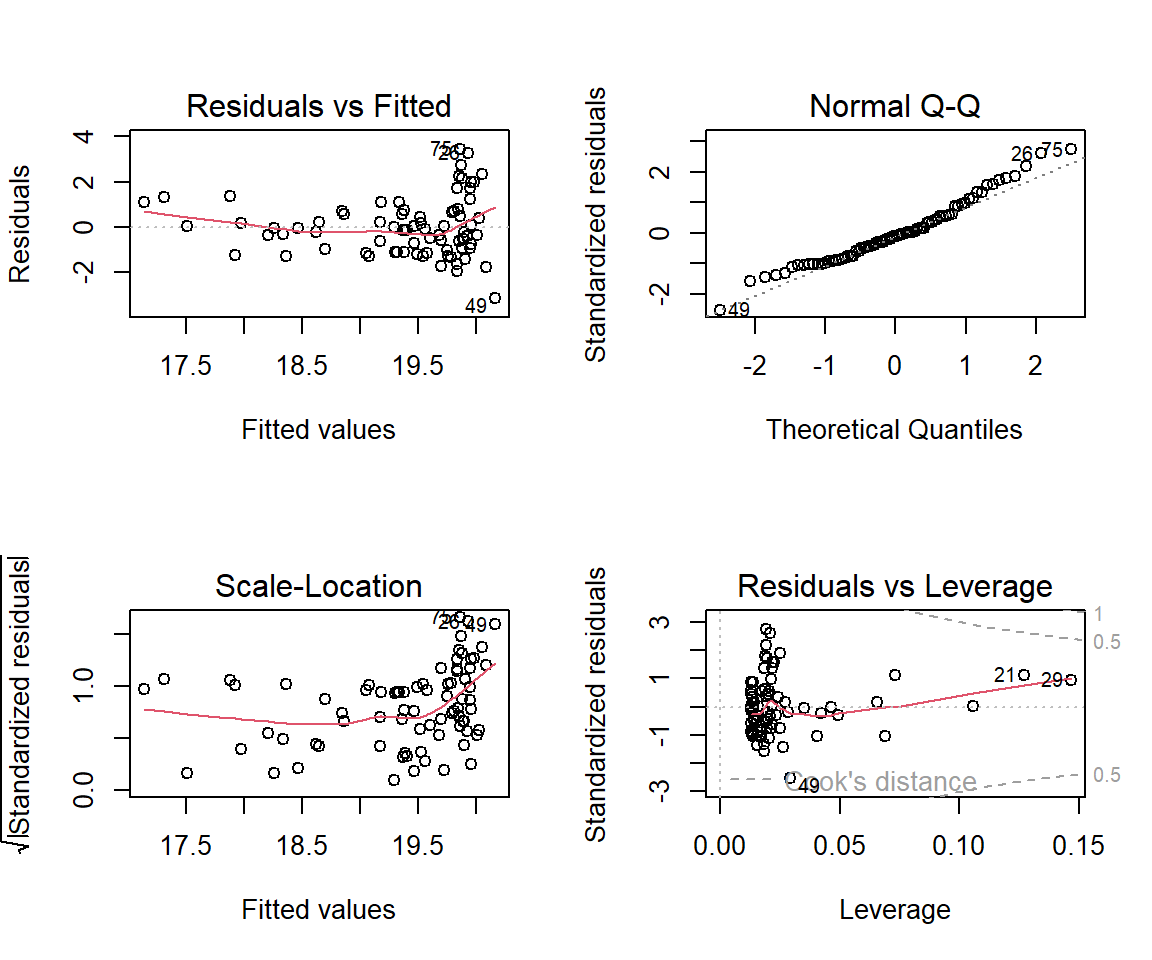
En este plot podemos evidenciar departuras del supuesto de la homocedasticidad. Idealmente, la línea roja que se muestra debería ir a lo largo de la horizontal en la coordenada cero del eje y (sobre la línea entrecortada).
Diagnósticos del ANOVA

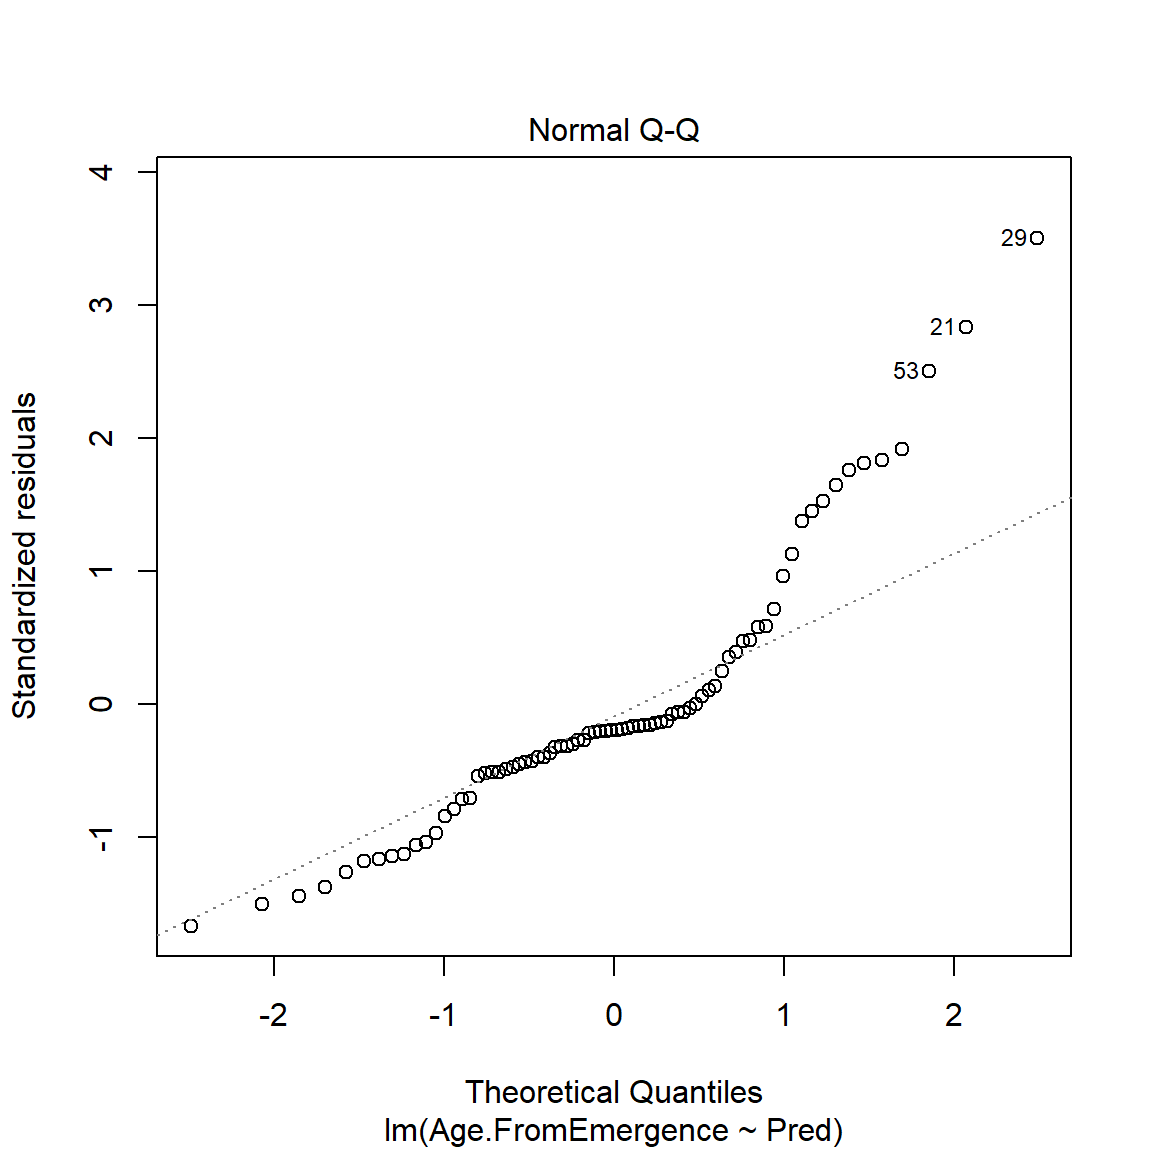
Gráfico Q-Q

A diferencia del gráfico Q-Q que vimos para las pruebas t, en el eje y de este mismo gráfico para el ANOVA (y regresión lineal) se representan los residuos estandarizados. La interpretación es la misma: idealmente los puntos deberían ir a lo largo de la diagonal. Cuando no es así, evidencia una violación del supuesto de la normalidad.
Diagnósticos del ANOVA

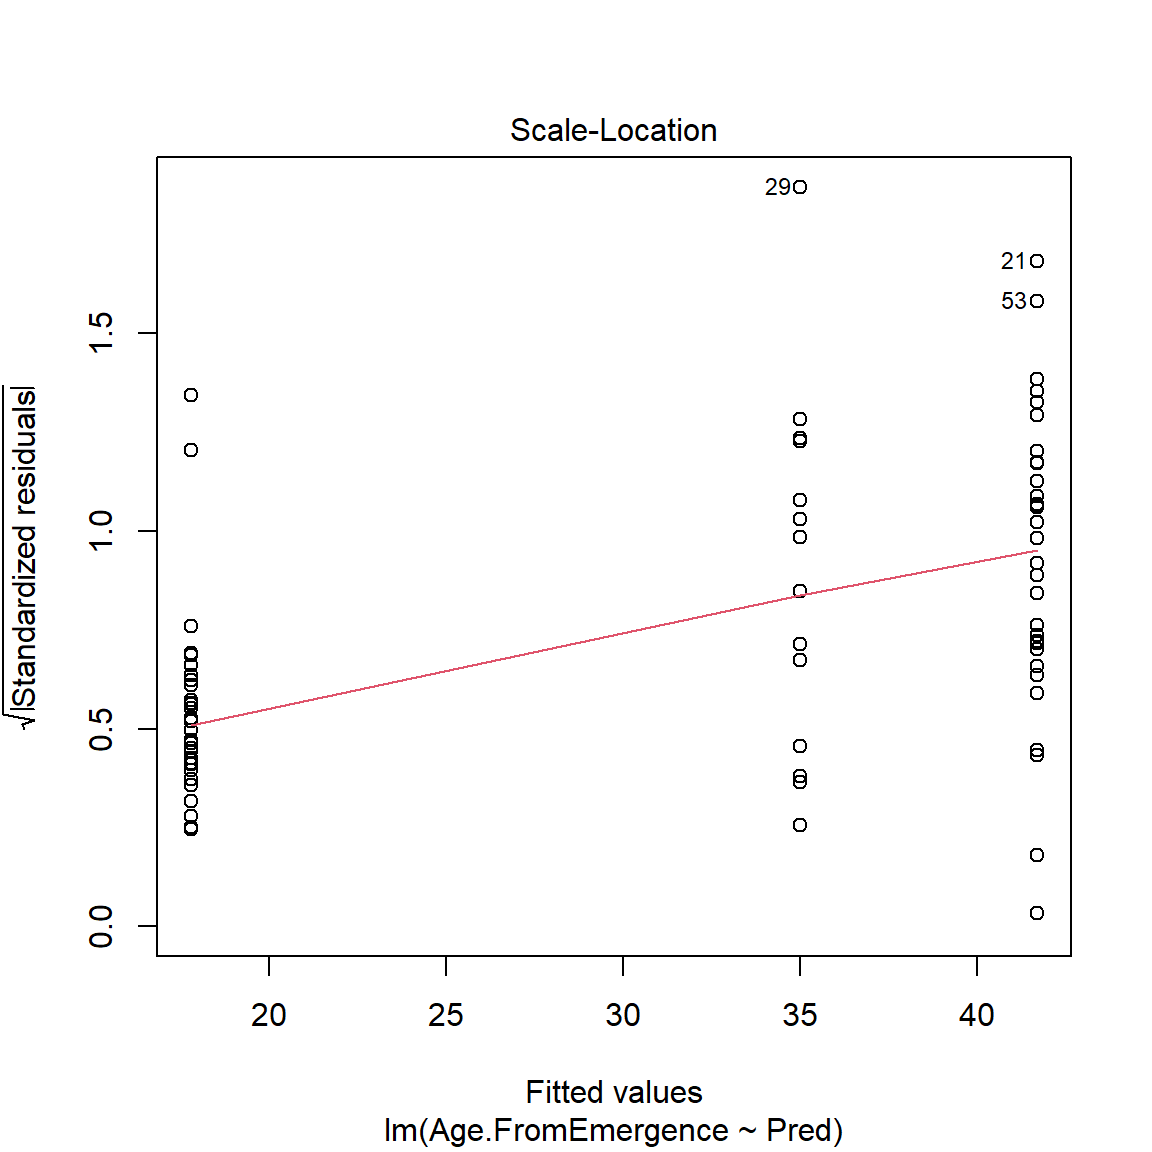
Raíz cuadrada de los residuos estandarizados vs. Valores ajustados

Similar al primer diagnóstico, en el caso del ANOVA, nos da una idea de posibles departuras de la homogeneidad de las varianzas. La línea roja idealmente debería ser completamente recta.
Diagnósticos del ANOVA

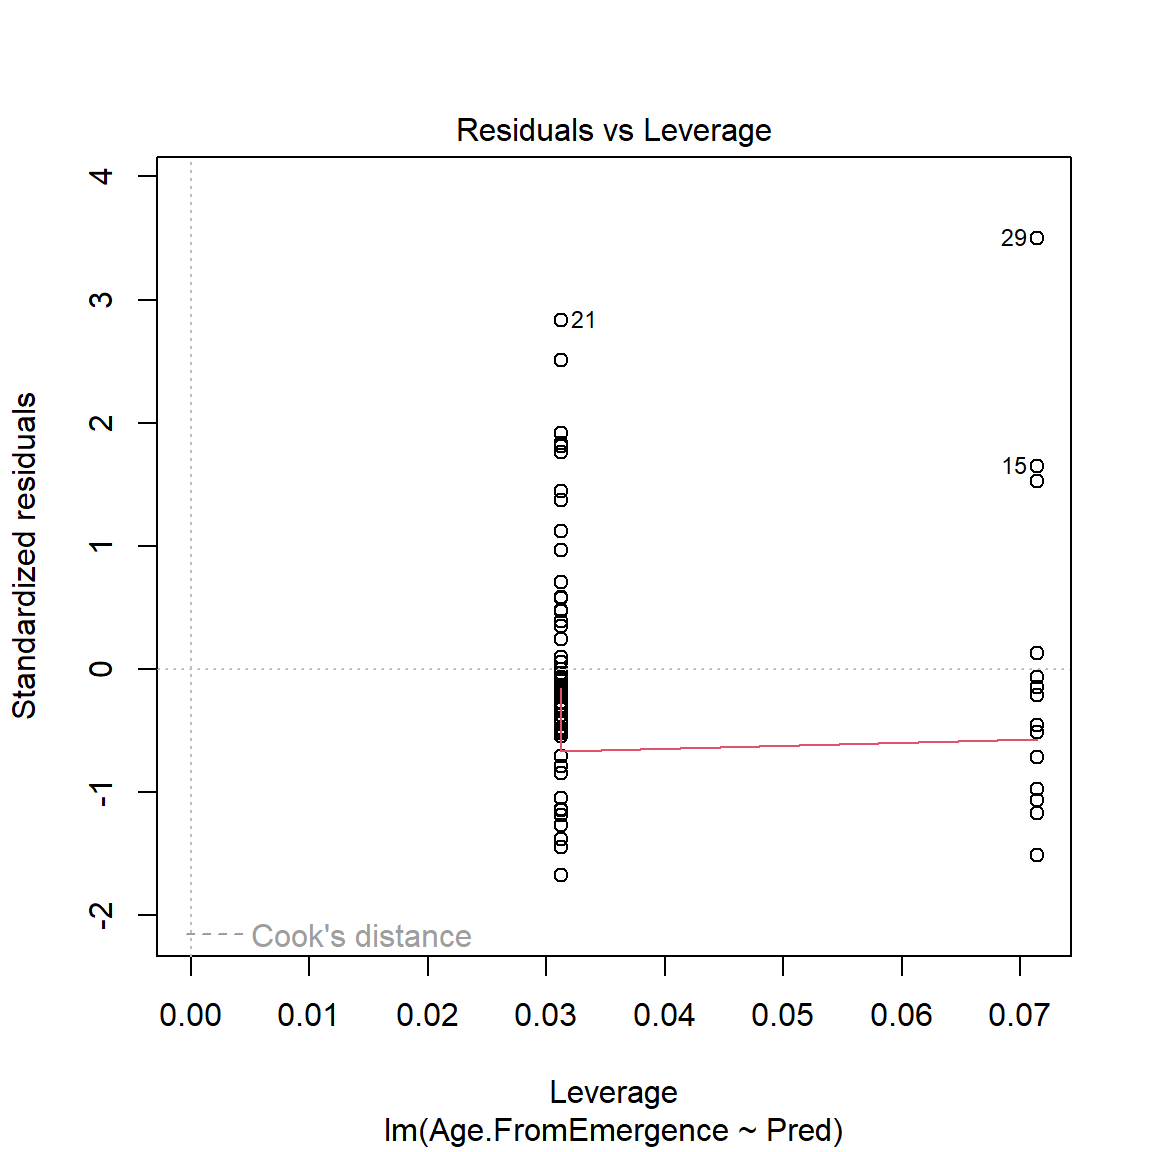
Residuos vs. Apalancamiento

Aquellos puntos que estén etiquetados con números son mostrados como posibles outliers bajo dos criterios:

  • Están por fuera de los límites de la regla del rango intercuartílico (IQR), y

  • Marcados como outliers con influencia de apalancamiento mediante la prueba de Cook (distancia de Cook).

El segundo criterio es un argumento sólido para remover outliers.

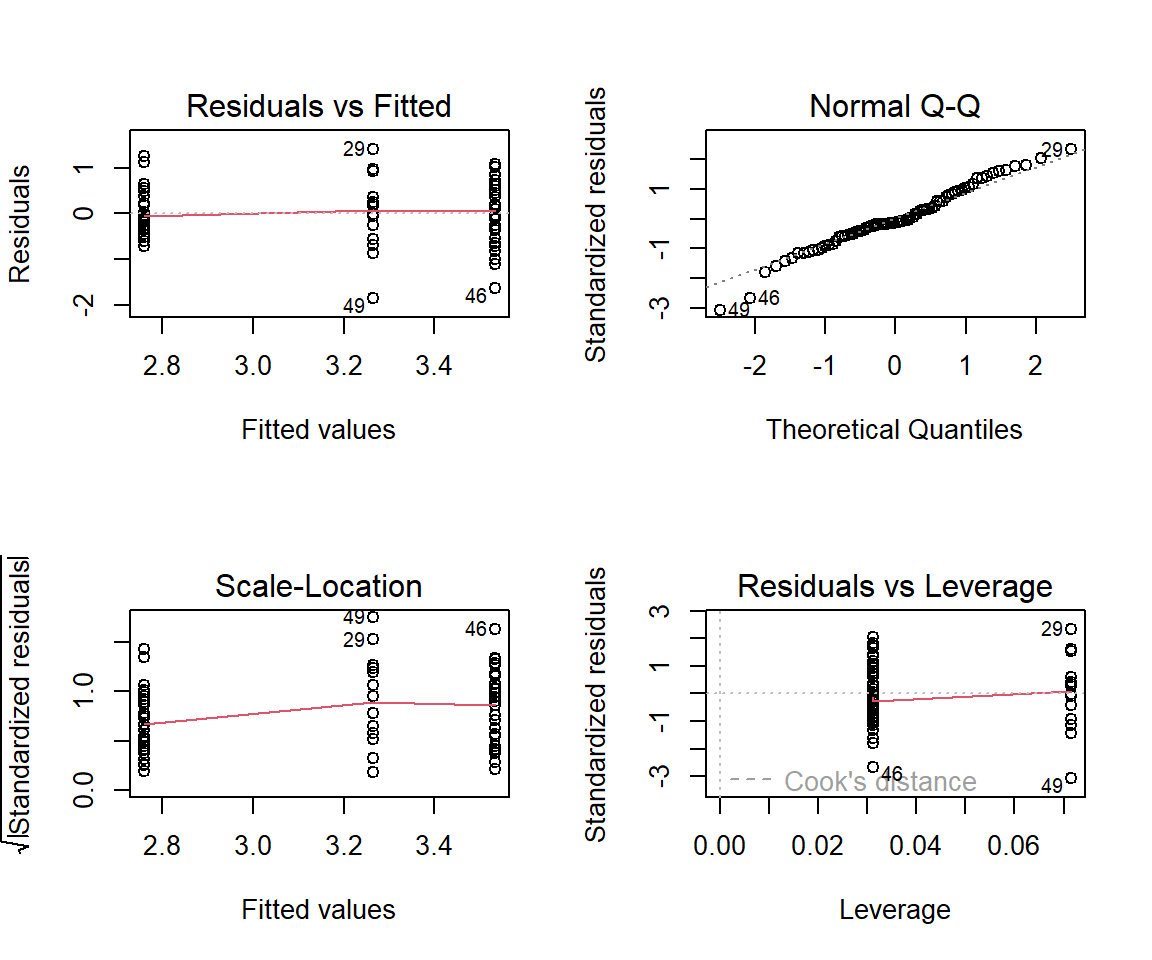
Transformaciones

lm2 <- lm(log(Age.FromEmergence) ~ Pred, data = ranas)
par(mfrow = c(2, 2))
plot(lm2)
par(mfrow = c(1, 1))

Transformaciones

Prueba formal de normalidad

  • Como vimos, después de aplicar la transformación logarítmica el gráfico Q-Q mejoró considerablemente.

  • Para estar seguros, podemos correr un test formal sobre los residuos del modelo con la ayuda de la librería olsrr mediante su función ols_test_normality.

library(olsrr)
ols_test_normality(lm2)
-----------------------------------------------
       Test             Statistic       pvalue  
-----------------------------------------------
Shapiro-Wilk              0.9802         0.2645 
Kolmogorov-Smirnov        0.0893         0.5625 
Cramer-von Mises          8.6738         0.0000 
Anderson-Darling          0.5447         0.1566 
-----------------------------------------------

Prueba formal de normalidad

  • O también podemos calcular la prueba de Shapiro-Wilk con funciones base de R
residuos <- resid(lm2)
shapiro.test(residuos)

    Shapiro-Wilk normality test

data:  residuos
W = 0.98017, p-value = 0.2645

Homogeneidad de las varianzas en ANOVA

  • La prueba más usada para chequear la homogeneidad de varianzas de un ANOVA es la de Levene.

  • Para ello utilizaremos la función leveneTest de la librería car. Podemos usar esta función directamente sobre los datos con la misma sintaxis de lm, o sobre el objeto lm2 en el que anteriormente almacenamos el resultado del modelo lineal con la transformación.

leveneTest(lm2, center = "mean")
Levene's Test for Homogeneity of Variance (center = "mean")
      Df F value  Pr(>F)  
group  2  3.0464 0.05345 .
      75                  
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

ANOVA de una vía en R (continuación)

  • Así, una vez que hemos transformado para obtener normalidad en los residuos y chequeado la homogeneidad de varianzas, es tiempo de hecharle un vistazo al resultado del ANOVA:
Anova(lm2)
Anova Table (Type II tests)

Response: log(Age.FromEmergence)
          Sum Sq Df F value    Pr(>F)    
Pred       9.710  2  12.389 2.244e-05 ***
Residuals 29.392 75                      
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
  • Por tanto, podemos concluir que al menos uno de los tratamientos es distinto (aceptamos la \(H_a\) y rechazamos la \(H_0\))

¿Qué tan distintos?

  • Preguntas naturales seguidas de estos resultados son: ¿qué tan distintos son los tratamientos entre sí?, ¿puedo acaso ordernarlos de mayor a menor?, ¿existen pares de tratamientos que son iguales?

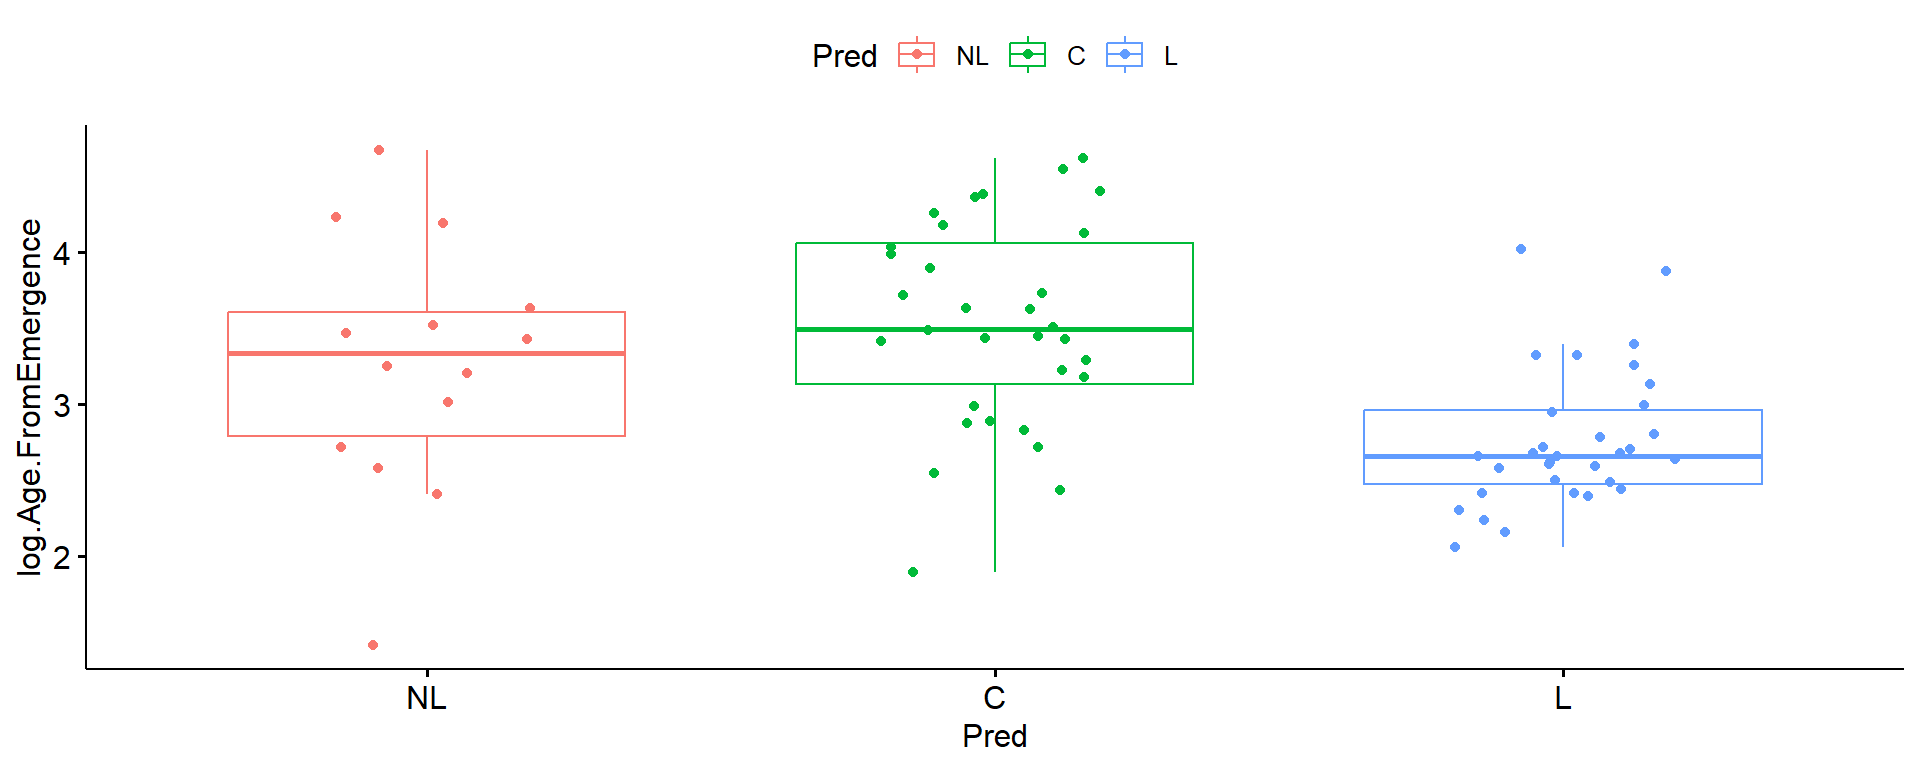
  • Podemos comenzar con una ayuda visual (ligeramente distinto a nuestro AED, usando la transformación logarítmica)

# usamos ggpubr nuevamente
ranas$log.Age.FromEmergence <- log(ranas$Age.FromEmergence)
ggboxplot(ranas,
          x = "Pred",
          y = "log.Age.FromEmergence",
          add = "jitter",
          color = "Pred")

Comparaciones múltiples

  • Los métodos de comparaciones múltiples y gráficos de interacción nos ayudan a responder estas preguntas.

  • En el caso de los gráficos de interacción para ANOVA de una vía, no tiene mucho sentido llevarlos a cabo ya que son más útiles para ANOVA de múltiples vías, así que los dejaremos para después.

  • Las comparaciones múltiples más usadas son:

    • HSD Tukey (Honestly significant difference): lleva a cabo todos los pares de comparaciones posibles entre los niveles de un factor.

    • Prueba de Dunnett: Compara los niveles únicamente con respecto al nivel control dentro del factor.

  • Son conocidas también como pruebas post-hoc.

  • En R, una manera de realizar comparaciones múltiples es mediante las librerías emmeans y multcomp (esta última depende de multcompView, así que no olvides instalarla también).

HSD Tukey

Calculamos las medias marginales a partir del modelo

library(emmeans)
ph1 <- emmeans(lm2, specs = "Pred", type = "response")
summary(ph1)

HSD Tukey

Calculamos las medias marginales a partir del modelo

library(emmeans)
ph1 <- emmeans(lm2, specs = "Pred", type = "response")
summary(ph1)
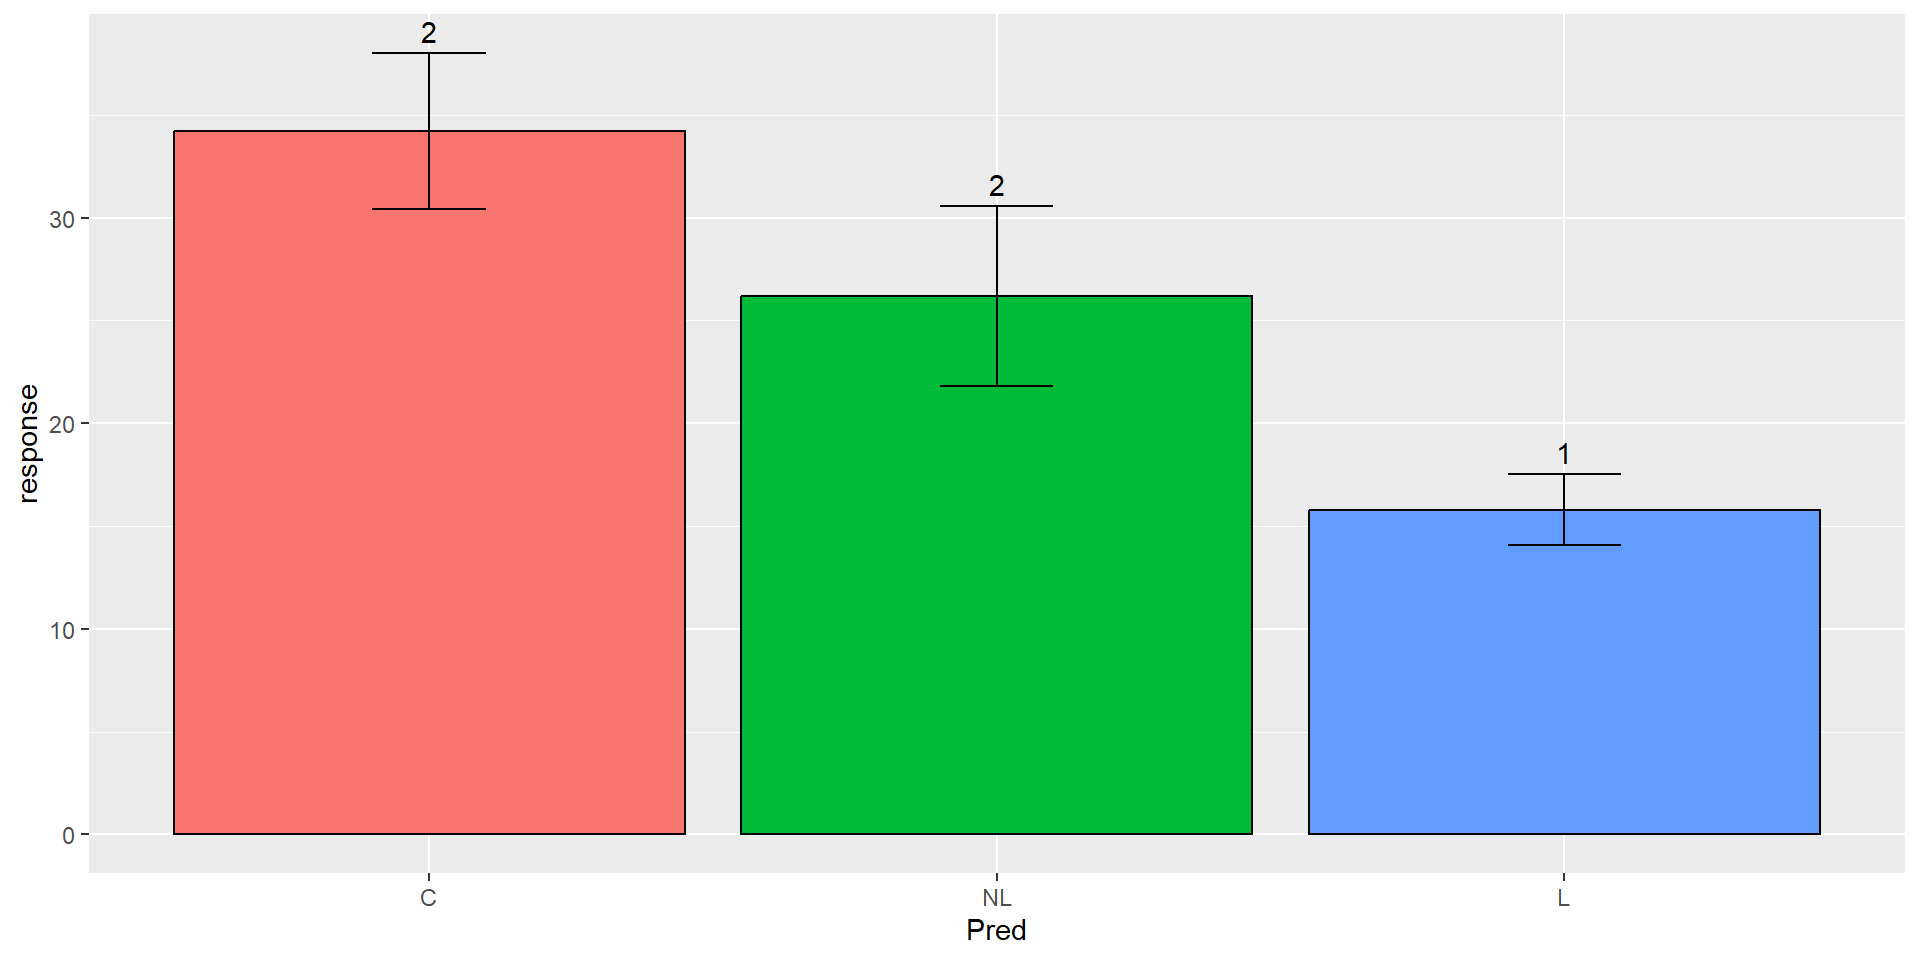
 Pred response   SE df lower.CL upper.CL
 C        34.2 3.79 75     27.4     42.6
 L        15.8 1.75 75     12.7     19.7
 NL       26.2 4.38 75     18.8     36.5

Confidence level used: 0.95 
Intervals are back-transformed from the log scale 
  • Ahora podemos calcular las comparaciones por pares de HSD Tukey
tukey_comp <- contrast(ph1, specs = "Pred", method = "tukey")
tukey_comp
 contrast ratio    SE df null t.ratio p.value
 C / L    2.165 0.339 75    1   4.936  <.0001
 C / NL   1.307 0.262 75    1   1.335  0.3806
 L / NL   0.604 0.121 75    1  -2.516  0.0368

P value adjustment: tukey method for comparing a family of 3 estimates 
Tests are performed on the log scale 

Prueba de Dunnett

  • Para Dunnett, es importante el establecer el grupo control
dunnett_comp <- contrast(ph1, specs = "Pred", method = "dunnett", ref = "C")
dunnett_comp
 contrast ratio     SE df null t.ratio p.value
 L / C    0.462 0.0723 75    1  -4.936  <.0001
 NL / C   0.765 0.1535 75    1  -1.335  0.3177

P value adjustment: dunnettx method for 2 tests 
Tests are performed on the log scale 
  • Finalmente, otra tabla de resumen de las comparaciones múltiples es la de agrupar las medias aritméticas marginales con números (o letras) de acuerdo a si estas son estadísticamente distintas o no entre si. Para ello podemos usar la librería multcomp:
# multcomp necesita una librería extra llamada multcompView
# No olvides instalar multcompView antes de correr este código
library(multcomp)
medias_marginales <- cld(ph1)
medias_marginales
 Pred response   SE df lower.CL upper.CL .group
 L        15.8 1.75 75     12.7     19.7  1    
 NL       26.2 4.38 75     18.8     36.5   2   
 C        34.2 3.79 75     27.4     42.6   2   

Confidence level used: 0.95 
Intervals are back-transformed from the log scale 
P value adjustment: tukey method for comparing a family of 3 estimates 
Tests are performed on the log scale 
significance level used: alpha = 0.05 
NOTE: If two or more means share the same grouping symbol,
      then we cannot show them to be different.
      But we also did not show them to be the same. 

Antes de continuar

  • En este punto, antes de continuar hagamos uso nuevamente de la librería flextable para exportar nuestras tablas a Word.
library(flextable)
tabla_tukey <- colformat_double(flextable(as.data.frame(tukey_comp)), digits = 3, j = c(2, 3, 6, 7))
tabla_dunnett <- colformat_double(flextable(as.data.frame(dunnett_comp)), digits = 3, j = c(2, 3, 6, 7))
tabla_marginal <- colformat_double(flextable(medias_marginales), digits = 3, j = c(2, 3, 5, 6))

contrast

ratio

SE

df

null

t.ratio

p.value

C / L

2.165

0.339

75

1

4.936

0.000

C / NL

1.307

0.262

75

1

1.335

0.381

L / NL

0.604

0.121

75

1

-2.516

0.037

contrast

ratio

SE

df

null

t.ratio

p.value

L / C

0.462

0.072

75

1

-4.936

0.000

NL / C

0.765

0.153

75

1

-1.335

0.318

Pred

response

SE

df

lower.CL

upper.CL

.group

L

15.799

1.748

75

12.673

19.695

1

NL

26.172

4.379

75

18.754

36.525

2

C

34.208

3.786

75

27.440

42.645

2

Antes de continuar

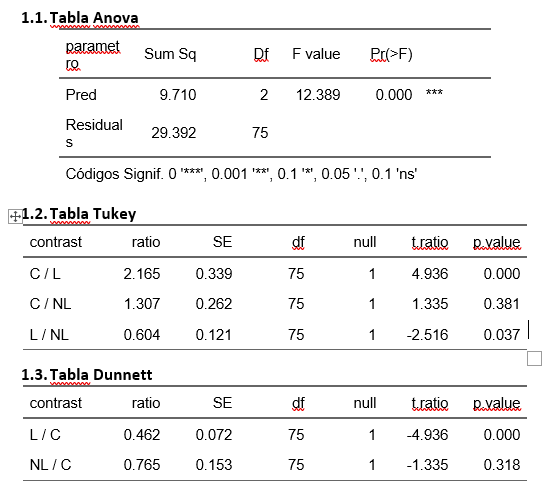
  • La tabla del ANOVA requiere un poquito más de preparación y para ello nos ayudaremos de la librería rstatix para agregar los asteriscos de significancia.
library(rstatix)
tabla_anova <- as.data.frame(Anova(lm2))
tabla_anova <- cbind(parametro = row.names(tabla_anova), tabla_anova)
tabla_anova <- add_significance(tabla_anova, 
                 p.col = "Pr(>F)", 
                 output.col = " ",
                 cutpoints = c(0, 0.001, 0.01, 0.05, 0.1, 1),
                 symbols = c("***", "**", "*", ".", "ns"))
tabla_anova <- colformat_double(flextable(tabla_anova), digits = 3, j = c(2, 4, 5))
tabla_anova <- add_footer_lines(tabla_anova, "Códigos Signif. 0 '***', 0.001 '**', 0.1 '*', 0.05 '.', 0.1 'ns'")

Antes de continuar

  • La tabla del ANOVA requiere un poquito más de preparación y para ello nos ayudaremos de la librería rstatix para agregar los códigos de significancia.
library(rstatix)
tabla_anova <- as.data.frame(Anova(lm2))
tabla_anova <- cbind(parametro = row.names(tabla_anova), tabla_anova)
tabla_anova <- add_significance(tabla_anova, 
                 p.col = "Pr(>F)", 
                 output.col = " ",
                 cutpoints = c(0, 0.001, 0.01, 0.05, 0.1, 1),
                 symbols = c("***", "**", "*", ".", "ns"))
tabla_anova <- colformat_double(flextable(tabla_anova), digits = 3, j = c(2, 4, 5))
tabla_anova <- add_footer_lines(tabla_anova, "Códigos Signif. 0 '***', 0.001 '**', 0.1 '*', 0.05 '.', 0.1 'ns'")
tabla_anova

parametro

Sum Sq

Df

F value

Pr(>F)

Pred

9.710

2

12.389

0.000

***

Residuals

29.392

75

Códigos Signif. 0 '***', 0.001 '**', 0.1 '*', 0.05 '.', 0.1 'ns'

Antes de continuar

save_as_docx("Tabla Anova" = tabla_anova, "Tabla Tukey" = tabla_tukey, "Tabla Dunnett" = tabla_dunnett,
             "Tabla Medias Marginales Esperadas" = tabla_marginal,
             path = "C:/Users/mmore/Documents/cursos_uce_2023/modulos/uce2023-modulo4/anova.docx")

Gráficos de comparaciones múltiples

  • Hay personas que prefieren tener representaciones visuales de las comparaciones múltiples.

  • Realizar este tipo de gráficos sin embargo solía demandar buena experiencia ya sea en gráficos base o ggplot2.

  • Afortunadamente, rstatix nos brinda la posibilidad de llevarlos a cabo de una manera relativamente sencilla.

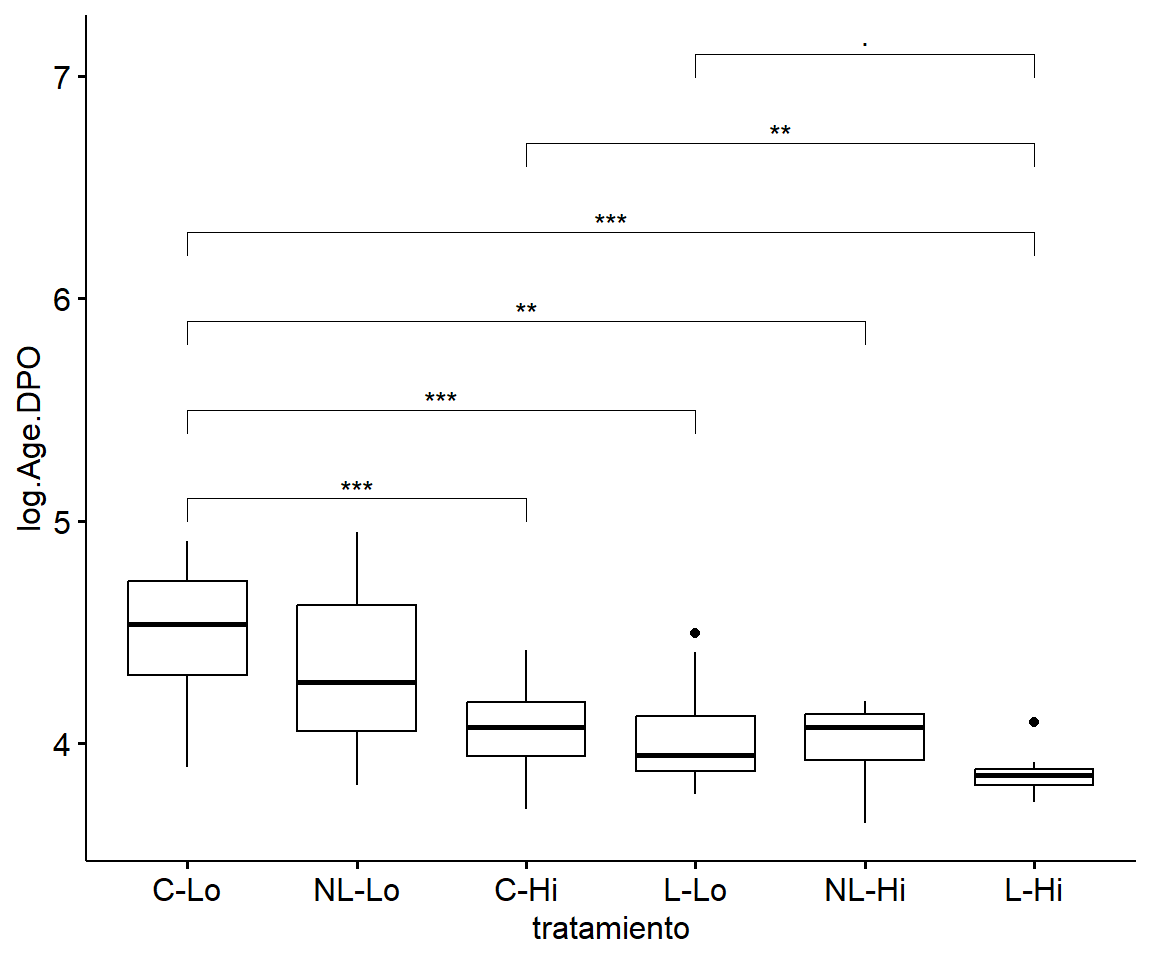
  • La idea es generar un gráfico con las medias marginales observadas de la variable de interés y posicionar sobre este los resultados de las comparaciones múltiples con sus códigos de significancia (o valores p).

  • Las desventajas de esta visualización son:

    • Tienen mayor sentido realizarlas con HSD Tukey

    • Cuando el número de pares de comparaciones es muy grande, el gráfico se vuelve más difícil de interpretar que las tablas.

    • rstatix no tiene manera de directamente volver a retransformar variables a sus unidades originales.

  • Otro gráfico de cierta popularidad es el de los grupos de Tukey de las medias marginales (gráficos de barras con los números/letras sobre cada categoría). Para esto utilizaremos además la librería stringr

Gráficos de comparaciones múltiples

ranas$Pred <- factor(ranas$Pred, levels = c("C", "NL", "L"))
bxplot <- ggboxplot(ranas, x = "Pred", 
                    y = "Age.FromEmergence", 
                    color = "Pred")
hsdvals <- emmeans_test(log.Age.FromEmergence ~ Pred, 
                        data = ranas, 
                        p.adjust.method = "mvt")
hsdvals <- add_significance(hsdvals, 
                            p.col = "p.adj", 
                            output.col = "p.adj.signif",
                            cutpoints = c(0, 0.001, 0.01, 0.05, 0.1, 1),
                            symbols = c("***", "**", "*", ".", "ns"))
hsdvals <- hsdvals %>% add_xy_position(x = "Pred")
bxplot + stat_pvalue_manual(hsdvals, y.position = c(120, 130, 140))
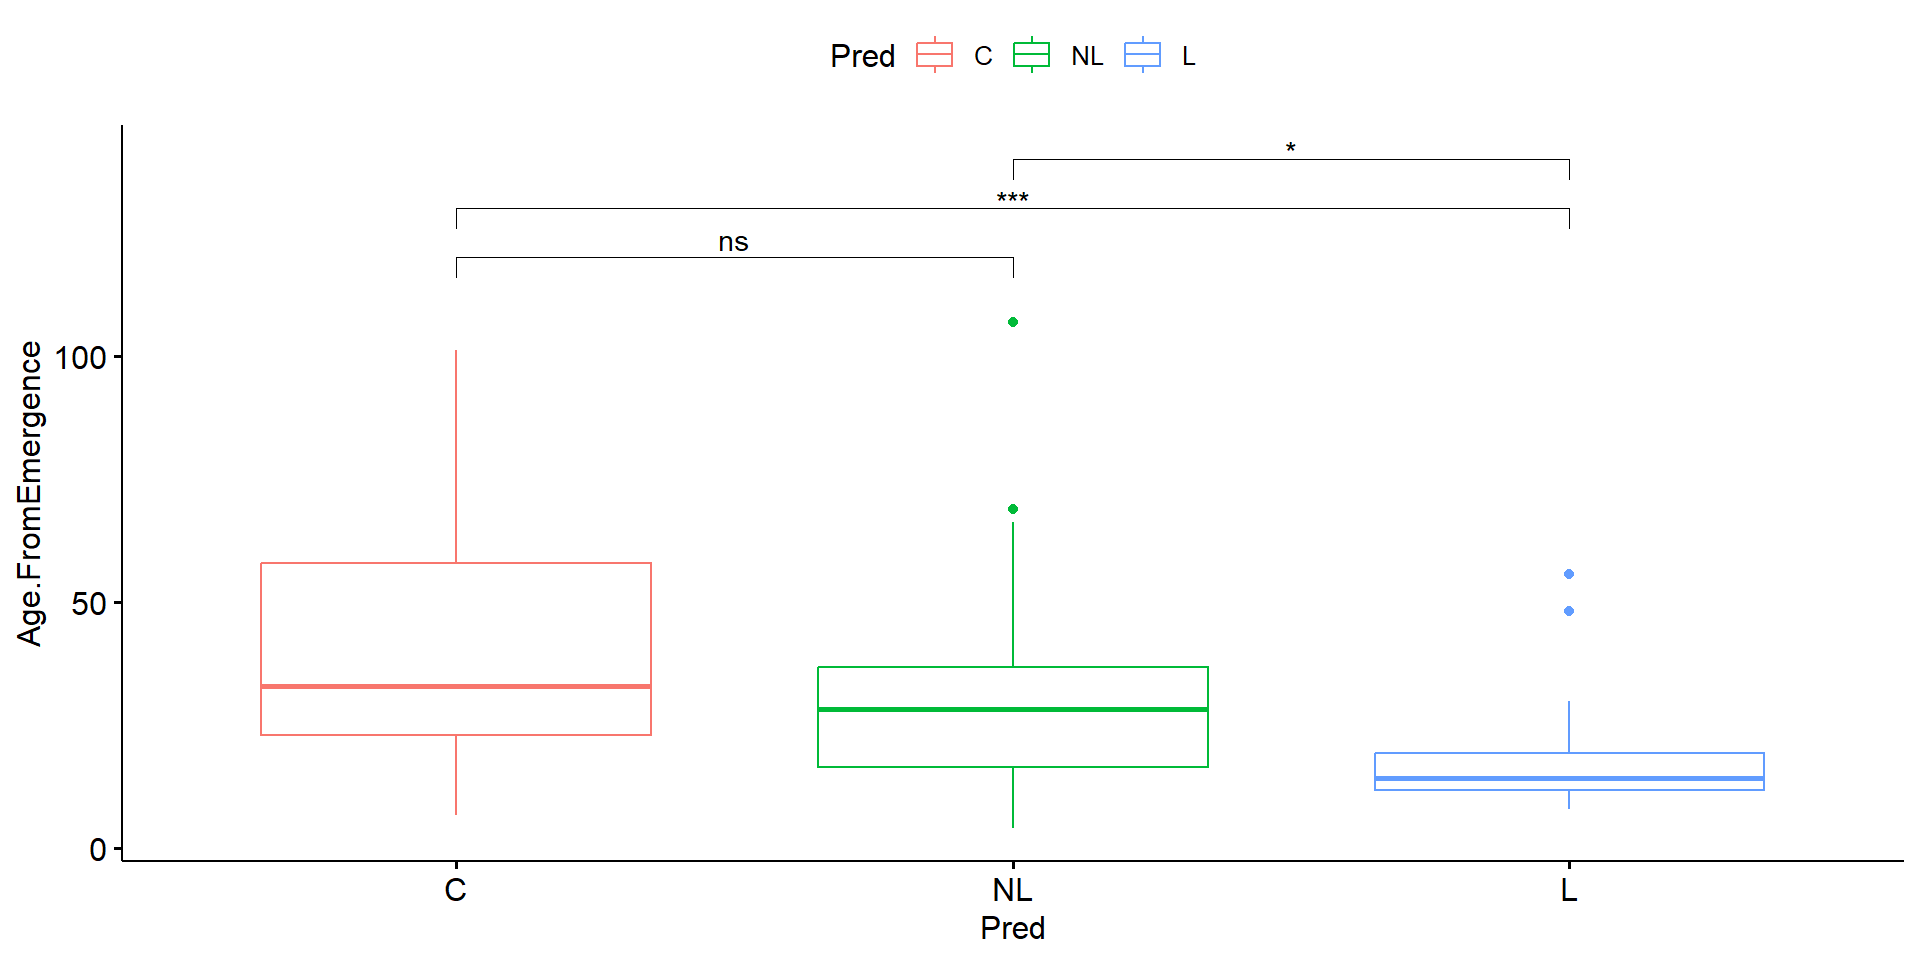
Gráficos de comparaciones múltiples

library(stringr)
gruposvals <- as.data.frame(cld(ph1))
gruposvals$Pred <- factor(gruposvals$Pred, levels = c("C", "NL", "L"))
ggplot(gruposvals,
       aes(x = Pred, 
           y = response, 
           fill = Pred)) +
  geom_bar(stat = "identity", 
           show.legend = F, 
           color = "black")+
  geom_errorbar(aes(ymin = response - SE, 
                    ymax = response + SE), 
                width=0.2)+
  geom_text(aes(label=str_trim(.group), 
                y = response+SE, vjust=-0.5))
ANOVA de un diseño desbalanceado

  • Recordemos que 18 tanques con predadores no letales fueron descartados debido al brote de una enfermedad.

  • El diseño original de Touchon era balanceado. Al perderse unidades experimentales, el diseño se le puede denominar como desbalanceado. En otras palabras, el desbalance es la pérdida de observaciones.

  • La mayoría de métodos estadísticos requieren ser corregidos ante observaciones perdidas para poder tener la certeza de que los estimados que obtenemos no sean sesgados.

  • Sin adentrarnos en mayor detalle, uno de los componentes de la tabla de ANOVA es la suma de cuadrados. Existen tres tipos de suma de cuadrados: I, II y III.

  • En breve, las sumas II y III se aconseja sean usadas cuando existen interacciones en el ANOVA.

  • En R, la función aov calcula la suma de cuadrados tipo I. Este tipo de suma no es conveniente ante la presencia de desbalance de los datos.

  • En cambio, la función Anova de la librería car, usa por default el tipo II que es precisamente el recomendado usar ante la presencia de desbalance.

  • En resumen, sí. Hemos utilizado hasta el momento la corrección adecuada para estos datos.

Ejercicio 4.9

  • Lleva a cabo un ANOVA con todos sus pasos para la variable Resorb.days de los datos de Touchon

Prueba de Kruskal-Wallis

  • La prueba de Kruskal-Wallis es la alternativa no paramétrica al ANOVA de una vía.

  • Puede extenderse al ANOVA de múltiples vías reorganizando el diseño experimental.

  • Similar a las pruebas de Wilcoxon, se basa en encontrar diferencias de las medianas en lugar de las medias y su poder ese menor.

  • Para ilustrar este ejemplo, tomemos la variable Age.DPO del estudio de Touchon y veamos si existen diferencias con respecto al tratamiento de predador Pred. Age.DPO sin transformaciones no cumple con los supuestos del ANOVA.

kruskal.test(Age.DPO ~ Pred, data = ranas)

    Kruskal-Wallis rank sum test

data:  Age.DPO by Pred
Kruskal-Wallis chi-squared = 22.255, df = 2, p-value = 1.47e-05

Comparaciones múltiples con Kruskal-Wallis

  • Con KW también podemos hacer comparaciones múltiples.

  • En R base contamos con la función pairwise.wilcox.test que lleva a cabo comparaciones por pares mediante el método de Wilcoxon.

pairwise.wilcox.test(ranas$Age.DPO, ranas$Pred, p.adjust.method = "BH")

    Pairwise comparisons using Wilcoxon rank sum exact test 

data:  ranas$Age.DPO and ranas$Pred 

   C       NL   
NL 0.303   -    
L  9.8e-06 0.019

P value adjustment method: BH 

Ejercicio 4.10

  • Encuentra si existen diferencias en la longitud nariz-cloaca al emerger (SVL.initial) con respecto a los predadores Pred en los datos de Touchon. ¿Qué método es factible usar?, ¿ANOVA de una vía o Kruskal-Wallis?

Antes de continuar

  • Con respecto a los DDE que vimos en el módulo 2, el ANOVA de una vía corresponde directamente al análisis que llevaríamos a cabo para un DCA.

  • Para extender el modelo a un DBCA de una vía basta el incorporar otro efecto principal en el modelo:

lm3 <- lm(log(Age.FromEmergence) ~ Pred + as.factor(Block), data = ranas)
Anova(lm3)
Anova Table (Type II tests)

Response: log(Age.FromEmergence)
                  Sum Sq Df F value    Pr(>F)    
Pred              9.8369  2 13.9265 8.526e-06 ***
as.factor(Block)  5.3760  7  2.1746   0.04728 *  
Residuals        24.0158 68                      
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
  • La interpretación de este tipo de ANOVA se enfoca en el valor p de los tratamientos.

  • No tiene mucho sentido el interpretar el valor p del factor de bloque ya que está ahí para controlar fuentes de variación.

  • De manera similar, cuando extendamos el ANOVA a más factores, el análisis del DBCA factorial se consigue añadiendo un efecto principal para el bloque.

Antes de continuar

  • Para las pruebas de comparaciones múltiples, seguimos el mismo procedimiento que describimos anteriormente ignorando el efecto del bloque.
ph_dbca <- emmeans(lm3, specs = "Pred", type = "response")
contrast(ph_dbca, specs = "Pred", method = "tukey")
 contrast ratio    SE df null t.ratio p.value
 C / NL    1.24 0.255 68    1   1.036  0.5572
 C / L     2.17 0.322 68    1   5.200  <.0001
 NL / L    1.75 0.360 68    1   2.720  0.0223

Results are averaged over the levels of: Block 
P value adjustment: tukey method for comparing a family of 3 estimates 
Tests are performed on the log scale 

ANOVA de múltiples vías

  • El ANOVA puede extenderse para analizar dos o más factores a la vez. Su nombre entonces varía dependiendo de cuántos factores analicemos, así: ANOVA de dos vías (2 factores), ANOVA de tres vías (3 factores) …

  • En la práctica es recomendable diseñar experimentos hasta máximo 3 factores:

    • A más factores, más costosa la investigación

    • A más factores, sus interacciones son más difíciles de interpretar

    • Es posible inclusive que tengamos resultados sin sentido (interacciones innecesarias)

  • ¿Qué son las interacciones?

    • Una interacción se refiere cuando los niveles de un factor podrían depender de los niveles de otro.

    • Por ejemplo, con los datos de las ranas, podríamos imaginar que en la ausencia de predadores, tener recursos altos o bajos podría influenciar el tiempo que tomaron los renacuajos en culminar la metamorfosis. Es decir, si hay predadores presentes, podría darse el caso de que las presas se escondan y coman menos influenciando así ese tiempo.

    • Así, podríamos saber si el effecto de los recursos son influenciados ante la presencia de predadores

ANOVA de múltiples vías en R

  • Vamos a usar nuevamente los datos de Touchon, la variable de respuesta es la edad de metamorfosis Age.DPO y los factores la presencia de predadores Pred y los recursos Res.

  • Para un ANOVA de múltiples vías en R podemos usar la siguiente sintaxis: Factor1*Factor2

  • Para ahorrarnos tiempo, supóngamos que ya corrimos un primer ANOVA, y encontramos que usando el logaritmo de Age.DPO podemos normalizar los residuos. Pero nos encontramos con esto:

lm4 <- lm(log(Age.DPO) ~ Pred*Res, data = ranas)
leveneTest(lm4, center = "mean")
Levene's Test for Homogeneity of Variance (center = "mean")
      Df F value    Pr(>F)    
group  5  6.0253 0.0001033 ***
      72                      
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
  • ¡La homogeneidad de las varianzas no se cumple! 😱

  • ¡Ninguna otra transformación funciona!

ANOVA de múltiples vías en R

ANOVA de múltiples vías en R

  • A parte de reir, en este tipo de situaciones (que son bastante comunes), tenemos dos alternativas:

    1. Realizar pruebas no paramétricas, o

    2. Calcular ANOVAs con correcciones para heterodasticidad.

  • Pero como acuñó el Ec. y estadístico Milton Friedman: “No existe tal cosa como un almuerzo gratis”, usar la segunda opción no es tan fácil como hemos venido viendo.

  • En R, tenemos estos caminos (de peor a mejor opción):

    1. Realizar el ANOVA usando la corrección de White-Huber disponible en la librería car, pero al costo de conducir comparaciones múltiples posiblemente sesgadas (siguiendo la lógica de realizarlas con emmeans).

    2. Utilizar rstatix para un ANOVA con la corrección de Welch, seguido de comparaciones múltiples con la corrección de Games-Howell y poder todavía realizar sus gráficos al costo de romper la secuencia de aprendizaje que hemos venido llevando para el ANOVA.

    3. Utilizar las librerías nlme para reparametrizar el modelo en forma de un modelo lineal generalizado, y posteriormente usar car y emmeans para el ANOVA y las comparaciones múltiples, respectivamente. Pero al costo de no poder graficarlas con rstatix sino desde 0.

  • A continuación entonces iremos en este orden de las opciones: 2, 3 y 1 (la última para ejemplificar cuál sería el camino suponiendo que la homocedasticidad se hubiese cumplido).

ANOVA de múltiples vías en R. Opc. 2

  • El inconveniente de usar la corrección de Welch es que esta se puede aplicar solo a ANOVAs de una vía.

  • Entonces, de manera similar a lo hicimos para poder analizar por Kruskall-Wallis un diseño factorial, tenemos que crear una variable dummy combinando los dos factores para correr un ANOVA de una vía.

  • Debemos tener en cuenta que al realizar esto, reducimos poder de la prueba estadística.

ranas$log.Age.DPO <- log(ranas$Age.DPO)
ranas$tratamiento <- paste(ranas$Pred, ranas$Res, sep = "-")
anova_op2 <- ranas %>%
  welch_anova_test(log.Age.DPO ~ tratamiento)

ANOVA de múltiples vías en R. Opc. 2

  • El inconveniente de usar la corrección de Welch es que esta se puede aplicar solo a ANOVAs de una vía.

  • Entonces, de manera similar a lo hicimos para poder analizar por Kruskall-Wallis un diseño factorial, tenemos que crear una variable dummy combinando los dos factores para correr un ANOVA de una vía.

  • Debemos tener en cuenta que al realizar esto, reducimos poder de la prueba estadística.

ranas$log.Age.DPO <- log(ranas$Age.DPO)
ranas$tratamiento <- paste(ranas$Pred, ranas$Res, sep = "-")
ranas$tratamiento <- factor(ranas$tratamiento, levels = c("C-Lo", "NL-Lo", "C-Hi", "L-Lo", "NL-Hi", "L-Hi"))
anova_op2 <- ranas %>%
  welch_anova_test(log.Age.DPO ~ tratamiento)
anova_op2
# A tibble: 1 × 7
  .y.             n statistic   DFn   DFd           p method     
* <chr>       <int>     <dbl> <dbl> <dbl>       <dbl> <chr>      
1 log.Age.DPO    78      17.2     5  24.0 0.000000305 Welch ANOVA
  • Ahora podemos realizar las comparaciones de HSD Tukey (con corrección de Games-Howell)
games_comp <- ranas %>% games_howell_test(log.Age.DPO ~ tratamiento)
games_comp <- add_significance(games_comp, 
                                p.col = "p.adj", 
                                output.col = "p.adj.signif",
                                cutpoints = c(0, 0.001, 0.01, 0.05, 0.1, 1),
                                symbols = c("***", "**", "*", ".", "ns"))
games_comp
# A tibble: 15 × 8
   .y.         group1 group2 estimate conf.low conf.high      p.adj p.adj.signif
   <chr>       <chr>  <chr>     <dbl>    <dbl>     <dbl>      <dbl> <chr>       
 1 log.Age.DPO C-Lo   NL-Lo  -0.155     -0.772    0.462  0.936      ns          
 2 log.Age.DPO C-Lo   C-Hi   -0.440     -0.700   -0.180  0.000261   ***         
 3 log.Age.DPO C-Lo   L-Lo   -0.485     -0.754   -0.217  0.0000932  ***         
 4 log.Age.DPO C-Lo   NL-Hi  -0.493     -0.821   -0.166  0.002      **          
 5 log.Age.DPO C-Lo   L-Hi   -0.643     -0.877   -0.408  0.00000114 ***         
 6 log.Age.DPO NL-Lo  C-Hi   -0.285     -0.902    0.331  0.545      ns          
 7 log.Age.DPO NL-Lo  L-Lo   -0.331     -0.947    0.286  0.419      ns          
 8 log.Age.DPO NL-Lo  NL-Hi  -0.339     -0.961    0.284  0.433      ns          
 9 log.Age.DPO NL-Lo  L-Hi   -0.488     -1.11     0.133  0.129      ns          
10 log.Age.DPO C-Hi   L-Lo   -0.0452    -0.258    0.168  0.986      ns          
11 log.Age.DPO C-Hi   NL-Hi  -0.0531    -0.351    0.244  0.988      ns          
12 log.Age.DPO C-Hi   L-Hi   -0.202     -0.362   -0.0425 0.008      **          
13 log.Age.DPO L-Lo   NL-Hi  -0.00797   -0.310    0.294  1          ns          
14 log.Age.DPO L-Lo   L-Hi   -0.157     -0.334    0.0196 0.099      .           
15 log.Age.DPO NL-Hi  L-Hi   -0.149     -0.440    0.142  0.448      ns          
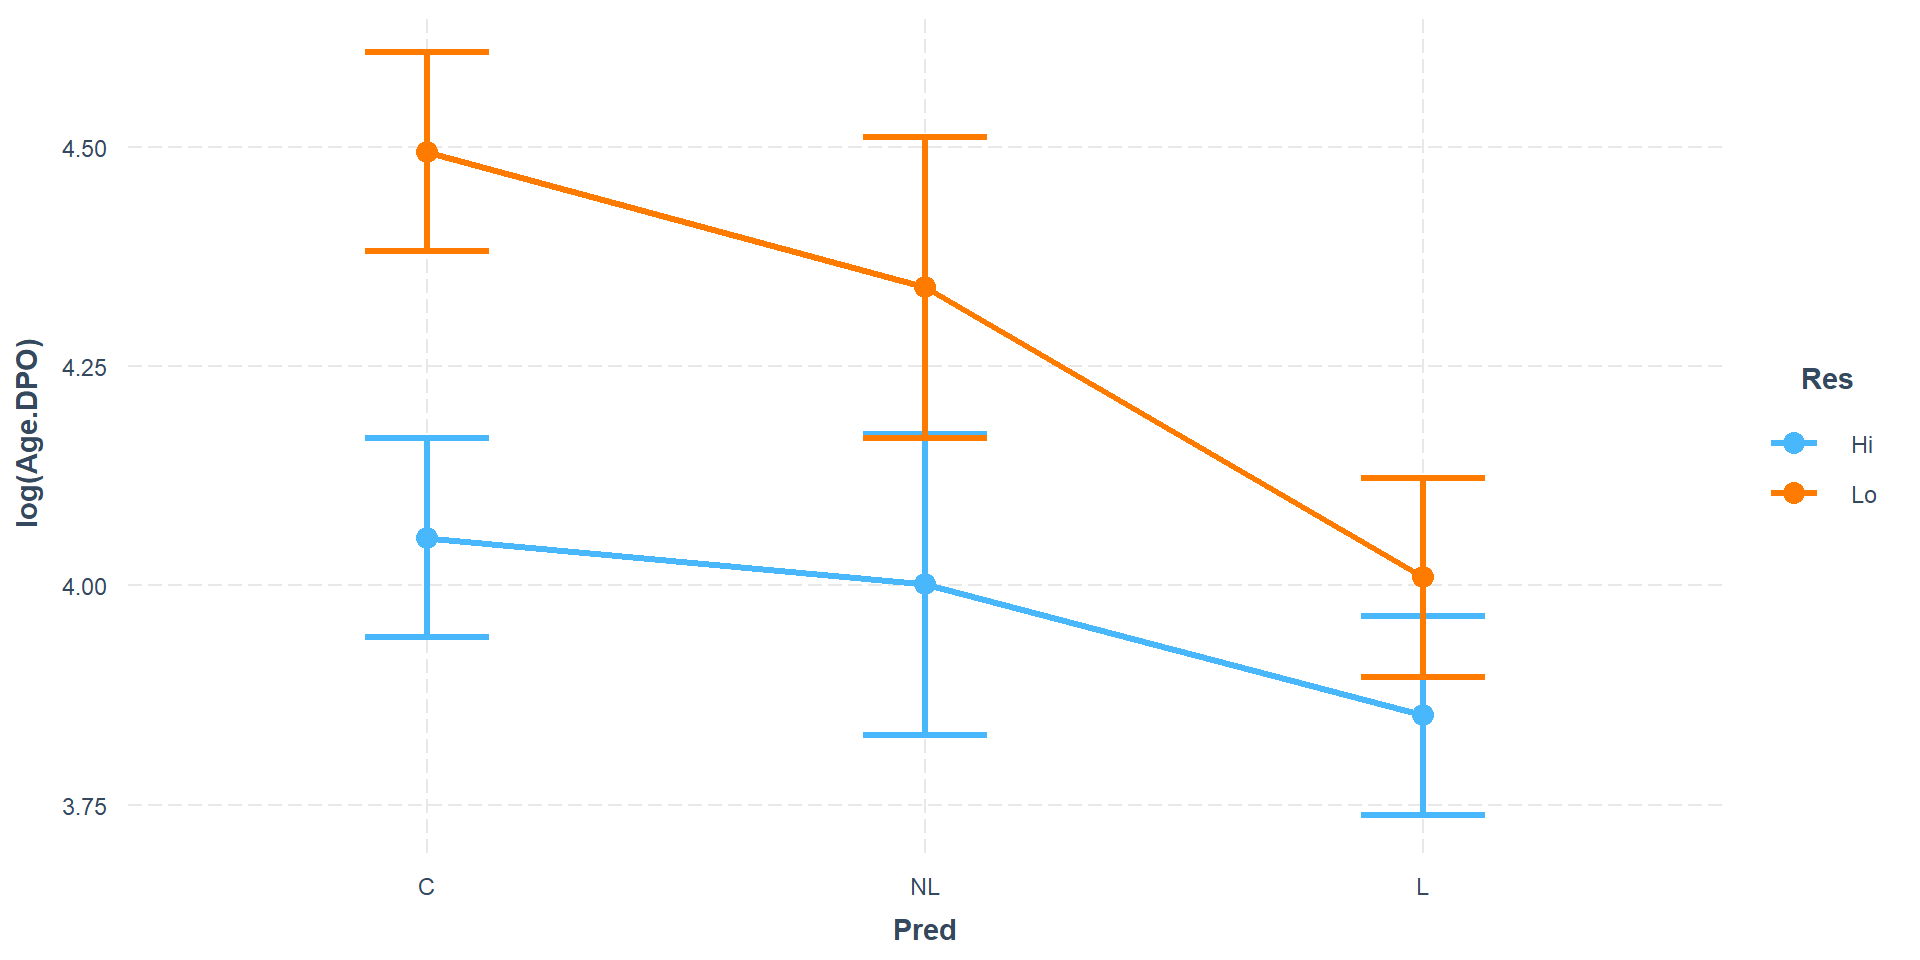
  • Finalizamos con el gráfico de estas
games_comp <- games_comp %>% 
  add_xy_position(x = "tratamiento", step.increase = 1)
ggboxplot(ranas,
          x = "tratamiento",
          y = "log.Age.DPO") + 
  stat_pvalue_manual(games_comp, 
                     hide.ns = T,
                     y.position = c(5.1,5.5,5.9,6.3,6.7,7.1))

ANOVA de múltiples vías en R. Opc. 3

  • La tercera opción involucra el reparametrizar el modelo para poder analizarlo como un modelo lineal generalizado.

  • En breve, una de las ventajas de los modelos lineales generalizados es que pueden asumir varianzas distintas a través de modelar directamente la heterodasticidad.

  • Para su implementación usaremos la librería nlme

library(nlme)
anova_op3 <- gls(log(Age.DPO) ~ Pred*Res,
                 data = ranas,
                 weights = varIdent(form = ~1|Pred*Res)) 
  • Mediante la librería car podemos obtener la tabla del ANOVA (o especificamente llamada Analisis de Desviación)
Anova(anova_op3)
Analysis of Deviance Table (Type II tests)

Response: log(Age.DPO)
         Df   Chisq Pr(>Chisq)    
Pred      2 41.5704  9.400e-10 ***
Res       1 30.6580  3.078e-08 ***
Pred:Res  2  8.0607    0.01777 *  
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
  • Ahora, usando emmeans podemos calcular el HSD de Tukey directamente sin necesidad de correcciones. Una consideración importante es que, cuando tenemos dos factores debemos hacer las comparaciones de cada factor a la vez a lo largo de los niveles del otro.
tukey_comp_pred <- emmeans(anova_op3, specs = "Pred", by = "Res", method = "tukey") # medias marginales esperadas
contrast(tukey_comp_pred, specs = "Pred", by = "Res", method = "tukey")
Res = Hi:
 contrast estimate     SE    df t.ratio p.value
 C - NL     0.0531 0.0873 14.09   0.608  0.8179
 C - L      0.2022 0.0509 20.74   3.971  0.0020
 NL - L     0.1491 0.0765  9.54   1.949  0.1779

Res = Lo:
 contrast estimate     SE    df t.ratio p.value
 C - NL     0.1548 0.1717  8.55   0.901  0.6536
 C - L      0.4854 0.0879 27.66   5.526  <.0001
 NL - L     0.3306 0.1650  7.37   2.004  0.1783

Degrees-of-freedom method: satterthwaite 
Results are given on the log (not the response) scale. 
P value adjustment: tukey method for comparing a family of 3 estimates 
tukey_comp_res <- emmeans(anova_op3, specs = "Res", by = "Pred", method = "tukey") # medias marginales esperadas
contrast(tukey_comp_res, specs = "Res", by = "Pred", method = "tukey")
Pred = C:
 contrast estimate     SE    df t.ratio p.value
 Hi - Lo    -0.440 0.0847 26.13  -5.199  <.0001

Pred = NL:
 contrast estimate     SE    df t.ratio p.value
 Hi - Lo    -0.339 0.1730  8.64  -1.957  0.0834

Pred = L:
 contrast estimate     SE    df t.ratio p.value
 Hi - Lo    -0.157 0.0560 19.63  -2.803  0.0111

Degrees-of-freedom method: satterthwaite 
Results are given on the log (not the response) scale. 
  • Para graficar estas comparaciones mediante esta opción es necesario el empezar de cero con ggplot2. La razón es que rstatix no tiene las capacidades de lidiar con interacciones provenientes de emmeans (no es compatible con la sintaxis de los comandos contrast de arriba) por lo que dejaremos esta opción hasta aquí.

ANOVA de múltiples vías en R. Opc. 1

  • Finalmente, asumamos que no tuvimos el problema de heterodasticidad y pudimos haber seguido el curso normal para realizar las comparaciones múltiples usando solamente car, emmeans y multcomp.

  • Este es el transcurso normal de tópicos en el aprendizaje del ANOVA de múltiples vías:

  • Tabla del ANOVA con car (mencionamos que car es capaz de llevar a cabo una corrección de heterodasticidad, esta se consigue agregando el argumento white.adjust = T dentro de la función Anova)
Anova(lm4)
Anova Table (Type II tests)

Response: log(Age.DPO)
          Sum Sq Df F value    Pr(>F)    
Pred      1.9446  2 18.7561 2.775e-07 ***
Res       1.8241  1 35.1871 9.576e-08 ***
Pred:Res  0.3254  2  3.1384   0.04934 *  
Residuals 3.7324 72                      
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
  • Al igual que en la opción 3, calculamos las comparaciones múltiples viendo a cada factor a la vez a lo largo de los niveles del otro.
tukey_comp_pred1 <- emmeans(lm4, specs = "Pred", by = "Res", type = "response")
contrast(tukey_comp_pred1, specs = "Pred", method = "tukey")
Res = Hi:
 contrast ratio     SE df null t.ratio p.value
 C / NL    1.05 0.1088 72    1   0.515  0.8644
 C / L     1.22 0.0985 72    1   2.512  0.0374
 NL / L    1.16 0.1198 72    1   1.445  0.3234

Res = Lo:
 contrast ratio     SE df null t.ratio p.value
 C / NL    1.17 0.1205 72    1   1.500  0.2968
 C / L     1.62 0.1308 72    1   6.030  <.0001
 NL / L    1.39 0.1436 72    1   3.204  0.0057

P value adjustment: tukey method for comparing a family of 3 estimates 
Tests are performed on the log scale 
tukey_comp_res1 <- emmeans(lm4, specs = "Res", by = "Pred", type = "response")
contrast(tukey_comp_res1, specs = "Pred", method = "tukey", adjust = "holm")
Pred = C:
 contrast ratio     SE df null t.ratio p.value
 Hi / Lo  0.644 0.0518 72    1  -5.470  <.0001

Pred = NL:
 contrast ratio     SE df null t.ratio p.value
 Hi / Lo  0.713 0.0867 72    1  -2.782  0.0069

Pred = L:
 contrast ratio     SE df null t.ratio p.value
 Hi / Lo  0.855 0.0688 72    1  -1.951  0.0549

Tests are performed on the log scale 

Antes de continuar

  • Muchas personas gustan de las tablas de grupos de Tukey para las medias marginales esperadas en diseños experimentales factoriales al estilo que usamos para poder conducir la opción 2 anteriormente descrita.

  • Esta práctica es innecesaria si el investigador es capaz de hacer buenas inferencias basándose en las comparaciones por factor a lo largo de los niveles del otro.

  • No tienen ningún problema operacional ya que a la final es una reparametrización válida del modelo.

  • Sin embargo, cuando el modelo sobre el cual son aplicadas es incorrecto, son más susceptibles de reflejar valores p que concluyen con inferencias falaces.

  • En el largo ejemplo de las opciones a mano para lidiar con heterodasticidad, podemos con seguridad afirmar que del peor al mejor modelo su orden sería: Opción 1 < Opción 2 < Opción 3.

  • Para ilustrar esto, con la variable dummy que creamos en la opción 2, calculemos los grupos Tukey de las medias marginales esperadas en las opciones 1 y 3 para su comparación.

Antes de continuar

  • Grupos Tukey de las medias marginales esperadas en la opción 1
lm_op1 <- lm(log(Age.DPO) ~ tratamiento, data = ranas)
emm_op1 <- emmeans(lm_op1, specs = "tratamiento", type = "response")
t_grupos_op1 <- contrast(emm_op1, specs = "tratamiento", method = "tukey")
t_grupos_op1 <- add_significance(as.data.frame(t_grupos_op1), 
                                p.col = "p.value", 
                                output.col = "p.adj.signif.op1",
                                cutpoints = c(0, 0.001, 0.01, 0.05, 0.1, 1),
                                symbols = c("***", "**", "*", ".", "ns"))
  • Grupos Tukey de las medias marginales esperadas en la opción 3
lm_op3 <- gls(log(Age.DPO) ~ tratamiento,
                 data = ranas,
                 weights = varIdent(form = ~1|tratamiento)) 
emm_op3 <- emmeans(lm_op3, specs = "tratamiento", type = "response")
t_grupos_op3 <- contrast(emm_op3, specs = "tratamiento", method = "tukey")
t_grupos_op3 <- add_significance(as.data.frame(t_grupos_op3), 
                                p.col = "p.value", 
                                output.col = "p.adj.signif.op3",
                                cutpoints = c(0, 0.001, 0.01, 0.05, 0.1, 1),
                                symbols = c("***", "**", "*", ".", "ns"))
  • Un poco de carpintería
colnames(games_comp)[c(7,8)] <- c("p.value.op2", "p.adj.signif.op2")
colnames(t_grupos_op3)[7] <- "p.value.op3"
colnames(t_grupos_op1)[7] <- "p.value.op1"

comp_table <- cbind(t_grupos_op3[,1],
                    t_grupos_op1[,c(7, 8)],
                    games_comp[,c(7, 8)],
                    t_grupos_op3[,c(7, 8)])

comp_table <- flextable(comp_table)
final_comp_table <- colformat_double(comp_table, j = c(2, 4, 6), digits = 3)
final_comp_table

t_grupos_op3[, 1]

p.value.op1

p.adj.signif.op1

p.value.op2

p.adj.signif.op2

p.value.op3

p.adj.signif.op3

(C-Lo) / (NL-Lo)

0.665

ns

0.936

ns

0.936

ns

(C-Lo) / (C-Hi)

0.000

***

0.000

***

0.000

***

(C-Lo) / (L-Lo)

0.000

***

0.000

***

0.000

***

(C-Lo) / (NL-Hi)

0.000

***

0.002

**

0.001

**

(C-Lo) / (L-Hi)

0.000

***

0.000

***

0.000

***

(NL-Lo) / (C-Hi)

0.075

.

0.545

ns

0.545

ns

(NL-Lo) / (L-Lo)

0.024

*

0.419

ns

0.419

ns

(NL-Lo) / (NL-Hi)

0.072

.

0.433

ns

0.433

ns

(NL-Lo) / (L-Hi)

0.000

***

0.129

ns

0.129

ns

(C-Hi) / (L-Lo)

0.993

ns

0.986

ns

0.987

ns

(C-Hi) / (NL-Hi)

0.995

ns

0.988

ns

0.988

ns

(C-Hi) / (L-Hi)

0.134

ns

0.008

**

0.008

**

(L-Lo) / (NL-Hi)

1.000

ns

1.000

ns

1.000

ns

(L-Lo) / (L-Hi)

0.380

ns

0.099

.

0.101

ns

(NL-Hi) / (L-Hi)

0.699

ns

0.448

ns

0.435

ns

Gráficos de interacción

  • Es una forma de representar las predicciones lineales de un modelo con respecto a los niveles de sus factores.

  • Es recomendable usarlos con factores de hasta 3 niveles y en ANOVAS de dos factores así como también con las medias marginales esperadas.

  • Existen diversas formas de realizarlos en R:

    • Librería base de R (solo puede hacerlo con medias marginales observadas… al menos hasta donde tengo conocimiento)

    • Construirlos desde cero con ggplot2 (para las opciones 2 y 3).

    • Usar librerías accesorias de ggplot2 como interactions. (Esta alternativa solo es válida para la primera opción que presentamos)

Gráficos de interacción en R

library(interactions)
graf_inter1 <- cat_plot(
  lm4,
  pred = Pred,
  modx = Res,
  geom = "line",
  data = ranas
)
graf_inter1

library(interactions)
graf_inter2 <- cat_plot(
  lm4,
  pred = Res,
  modx = Pred,
  geom = "line",
  data = ranas
)
graf_inter2

Ejercicios 4.11

  • Lleva a cabo un ANOVA de dos vías para las variables Resorb.days y los factores Pred y Res. La pregunta a investigar es saber si existe una interacción entre la presencia de predadores a distintos niveles de recursos que afecte el tiempo de reabsorción de la cola en los renacuajos de ranas arbóreas de ojos rojos.

  • A pesar de que el modelo para Resorb.day que acabas de hacer cumple con los supuestos del ANOVA, solo por aprendizaje, conduce una prueba de Kruskal-Wallis usando los mismos factores.

  • ¿Cómo implementarías un DBCA factorial con estos datos?

Regresión lineal

Introducción

  • Otro modelo estadístico ampliamente usado es la regresión lineal.

  • Se diferencia del ANOVA al considerar un predictor continuo (no un factor categórico).

  • Los supuestos de la regresión lineal son:

    • Existencia de una relación lineal entre las variables continuas objeto de la regresión

    • Normalidad de los residuos

    • Que no exista multicolinearidad (en el caso de regresión múltiple)

    • Que no exista auto correlación (que las observaciones no dependan una de otra dentro de una misma variable)

    • Homogeneidad de la varianza de los residuos

  • Contrario al ANOVA, no existen correcciones o métodos alternativos cuando las transformaciones fallan.

  • Por esto, lo que se recomienda hacer es mencionar todos los detalles de la conducción del modelo. Cosa que rara vez pasa.

  • En regresión lineal es quizá en el método que más se abusa del remover outliers.

Regresión lineal en R

  • Usando los datos de Touchon, podríamos preguntarnos si el tamaño de las ranas al final de la metamorfosis SVL.final está influenciado por la edad en finalizar la metamorfosis Age.DPO.

  • Esta regresión lineal sería de la siguiente forma:

lm6 <- lm(SVL.final ~ Age.DPO, data = ranas)
summary(lm6)

Call:
lm(formula = SVL.final ~ Age.DPO, data = ranas)

Residuals:
    Min      1Q  Median      3Q     Max 
-3.1414 -0.9521 -0.1297  0.6842  3.4349 

Coefficients:
             Estimate Std. Error t value Pr(>|t|)    
(Intercept) 21.285436   0.416763  51.073  < 2e-16 ***
Age.DPO     -0.029437   0.006052  -4.864 6.08e-06 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 1.262 on 76 degrees of freedom
Multiple R-squared:  0.2374,    Adjusted R-squared:  0.2273 
F-statistic: 23.65 on 1 and 76 DF,  p-value: 6.081e-06
  • Pero antes de cualquier inferencia, vamos a darle un vistazo a los diagnósticos de la regresión lineal

Diagnósticos de la regresión lineal

par(mfrow = c(2, 2))
plot(lm6)
par(mfrow = c(1, 1))

Diagnósticos de la regresión lineal

Diagnósticos de la regresión lineal

Residuos vs. Valores ajustados

En el ANOVA vimos como este plot sugería departuras de la homocedasticidad. En el caso de la regresión lineal, los residuos al no estar agrupados en categorías presentan mayor información sobre este supuesto. Adicionalmente, curvaturas en la línea roja evidencian también departuras de la linearidad. Esto quiere decir que la relación entre las variables no es completamente lineal. A veces esto puede corregirse con transformaciones.
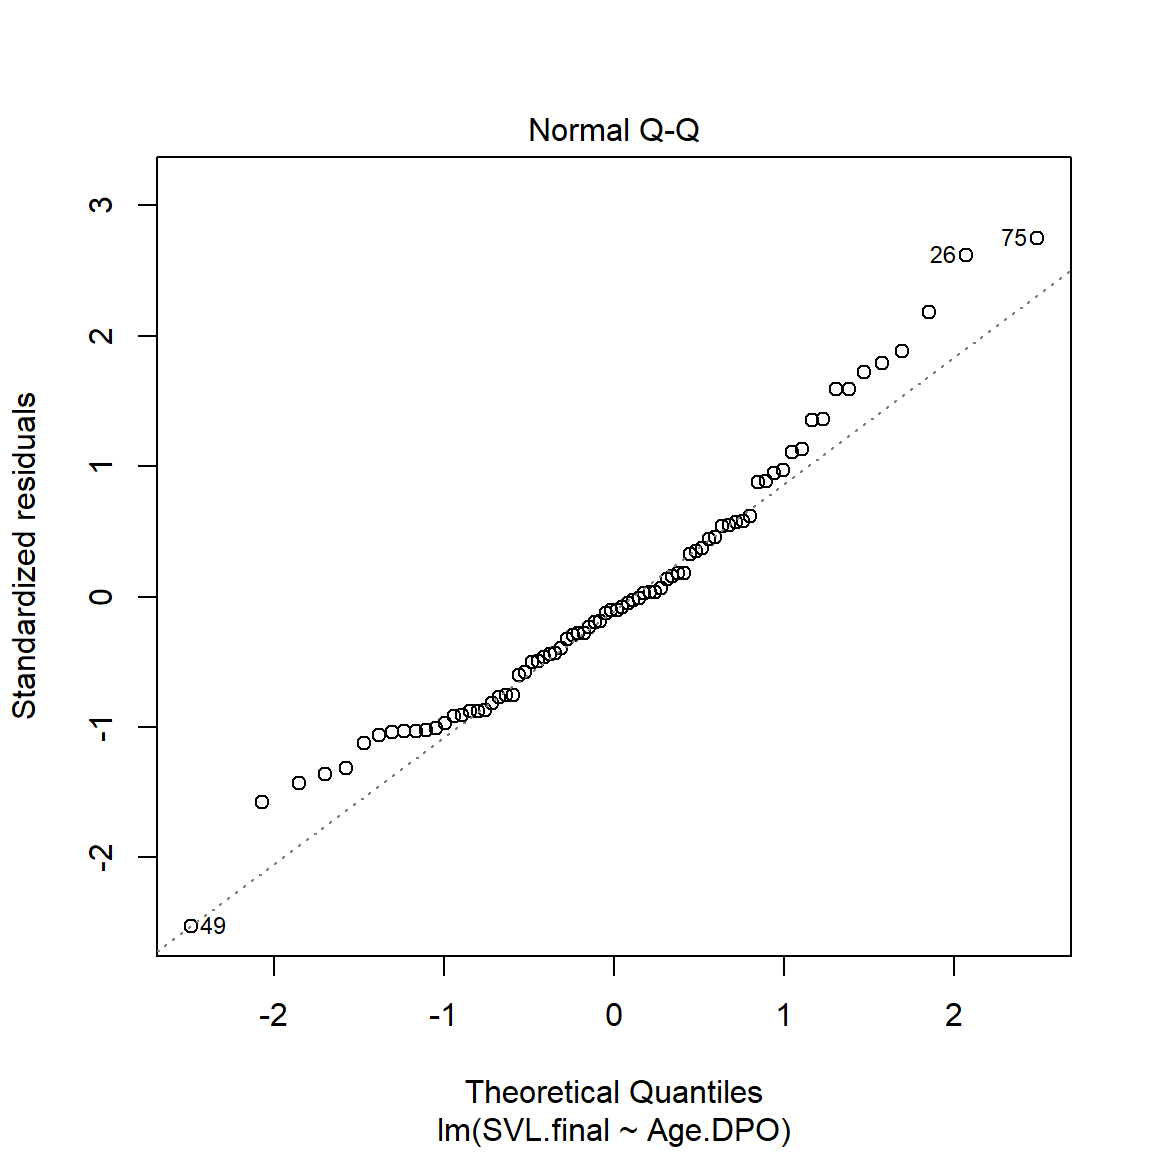
Diagnósticos de la regresión lineal

  1. Es ideal. (b) Es indicativo de no linearidad. (c) Evidencia de heterodasticidad. (d) Evidencia de una tendencia temporal

Diagnósticos de la regresión lineal

Gráfico Q-Q

Misma explicación que antes
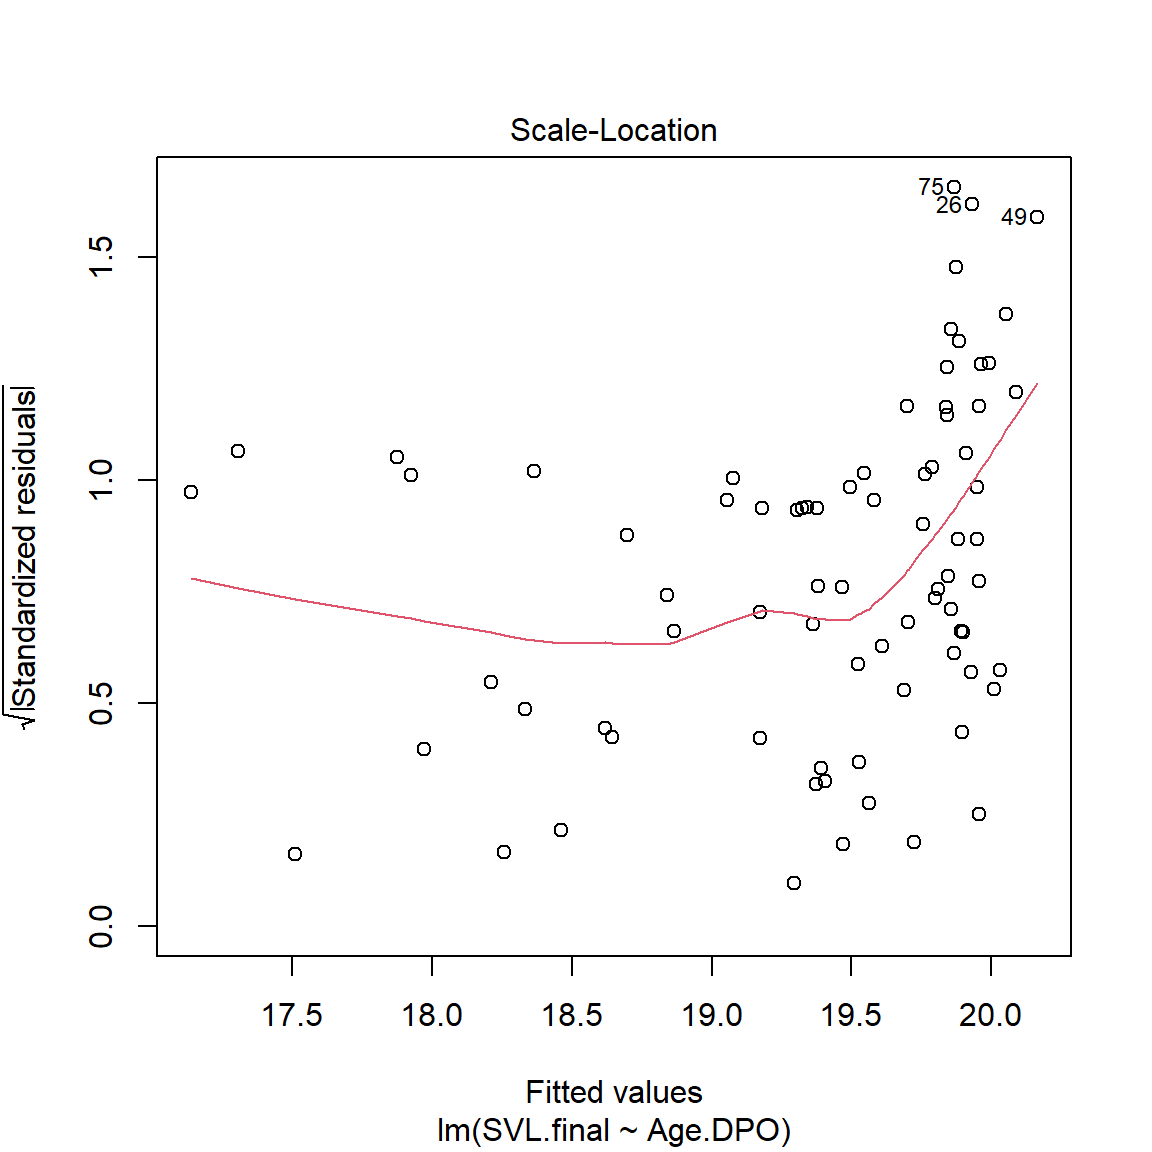
Diagnósticos de la regresión lineal

Raíz cuadrada de los residuos estandarizados vs. Valores ajustados

Misma explicación que antes
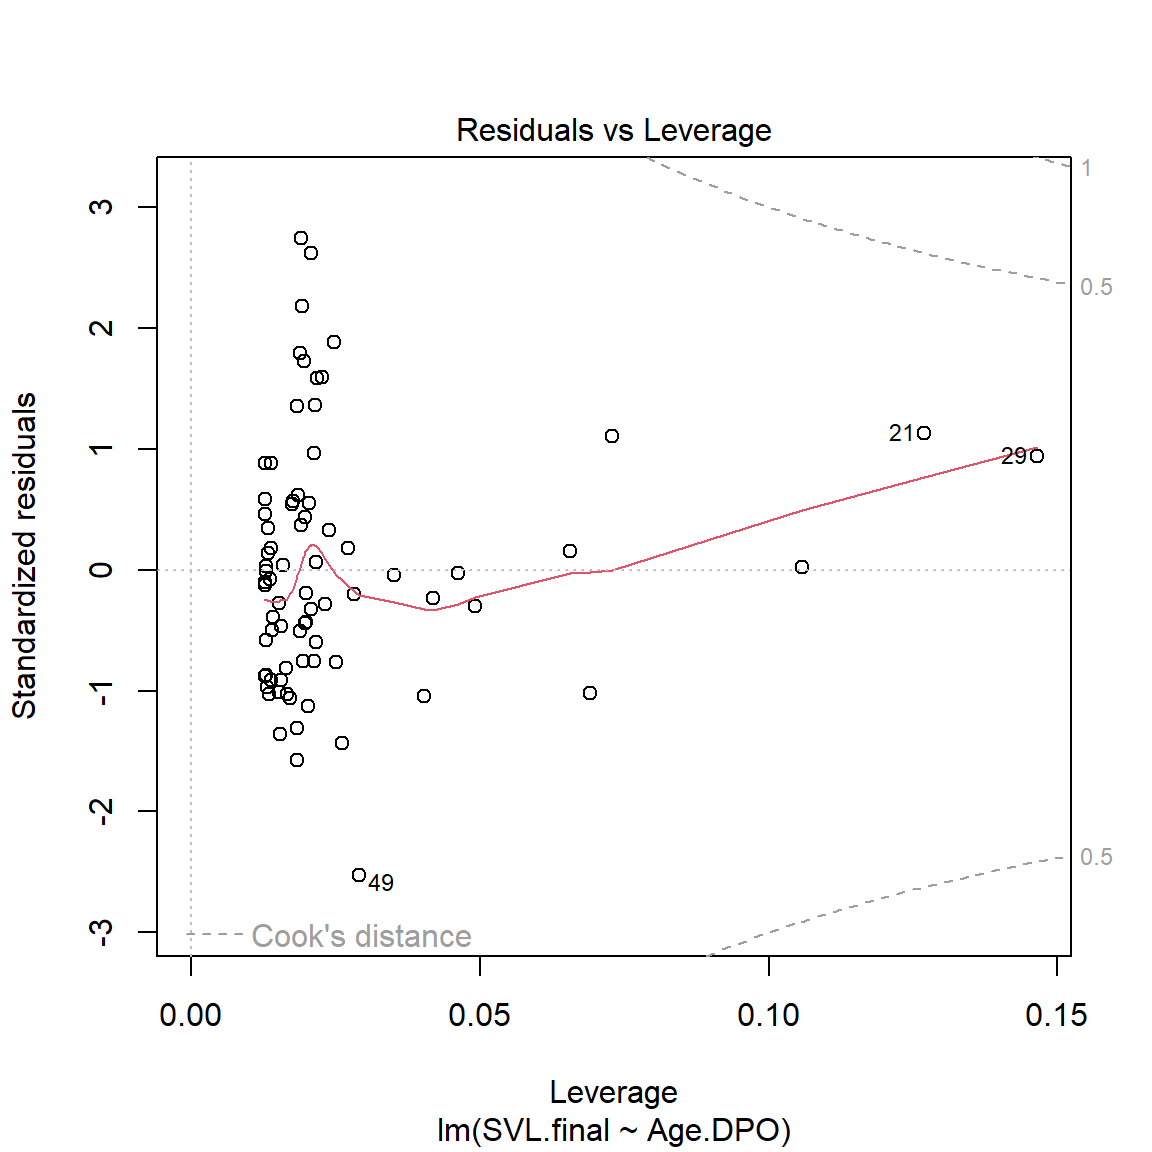
Diagnósticos de la regresión lineal

Residuos vs. Apalancamiento

Aquellos puntos que estén etiquetados con números son mostrados como posibles outliers bajo dos criterios:

  • Están por fuera de los límites de la regla del rango intercuartílico (IQR), y

  • Marcados como outliers con influencia de apalancamiento mediante la prueba de Cook (distancia de Cook).

El segundo criterio es un argumento sólido para remover outliers.

Pruebas formales de los supuestos

  • Como vimos, los supuestos de la regresión lineal son más que para el ANOVA.

  • Existen varias pruebas formales para chequear cada uno de sus supuestos, sin embargo rara vez son empleadas.

  • La razón yace en que si los aplicáramos todo el tiempo, no haríamos regresiones lineales ni el 10% de las veces.

  • Si tienes curiosidad en estas pruebas puedes visitar este enlace.

  • De alguna manera podemos decir que de hecho, los estadísticos somos más laxos con la regresión lineal, sin embargo esto es bajo el supuesto no estadístico de que estas departuras de los supuestos fueran debidamente documentadas y plasmadas en los trabajos científicos, lo cual lamentablemente no pasa muy a menudo.

  • Existen por supuesto métodos que no dependen de todos estos supuestos (por ejemplo: regresiones lineales Bayesianas, modelos lineales generalizados correctamente parametrizados) pero no son parte de este curso.

Transformación de datos

  • Al igual que en el ANOVA, podemos recurrir a transformaciones de datos que nos permitan aliviar varios de los supuestos no cumplidos de la regresión lineal.

  • En el presente caso, esto lo logramos al utilizar el logaritmo natural de las dos variables del modelo
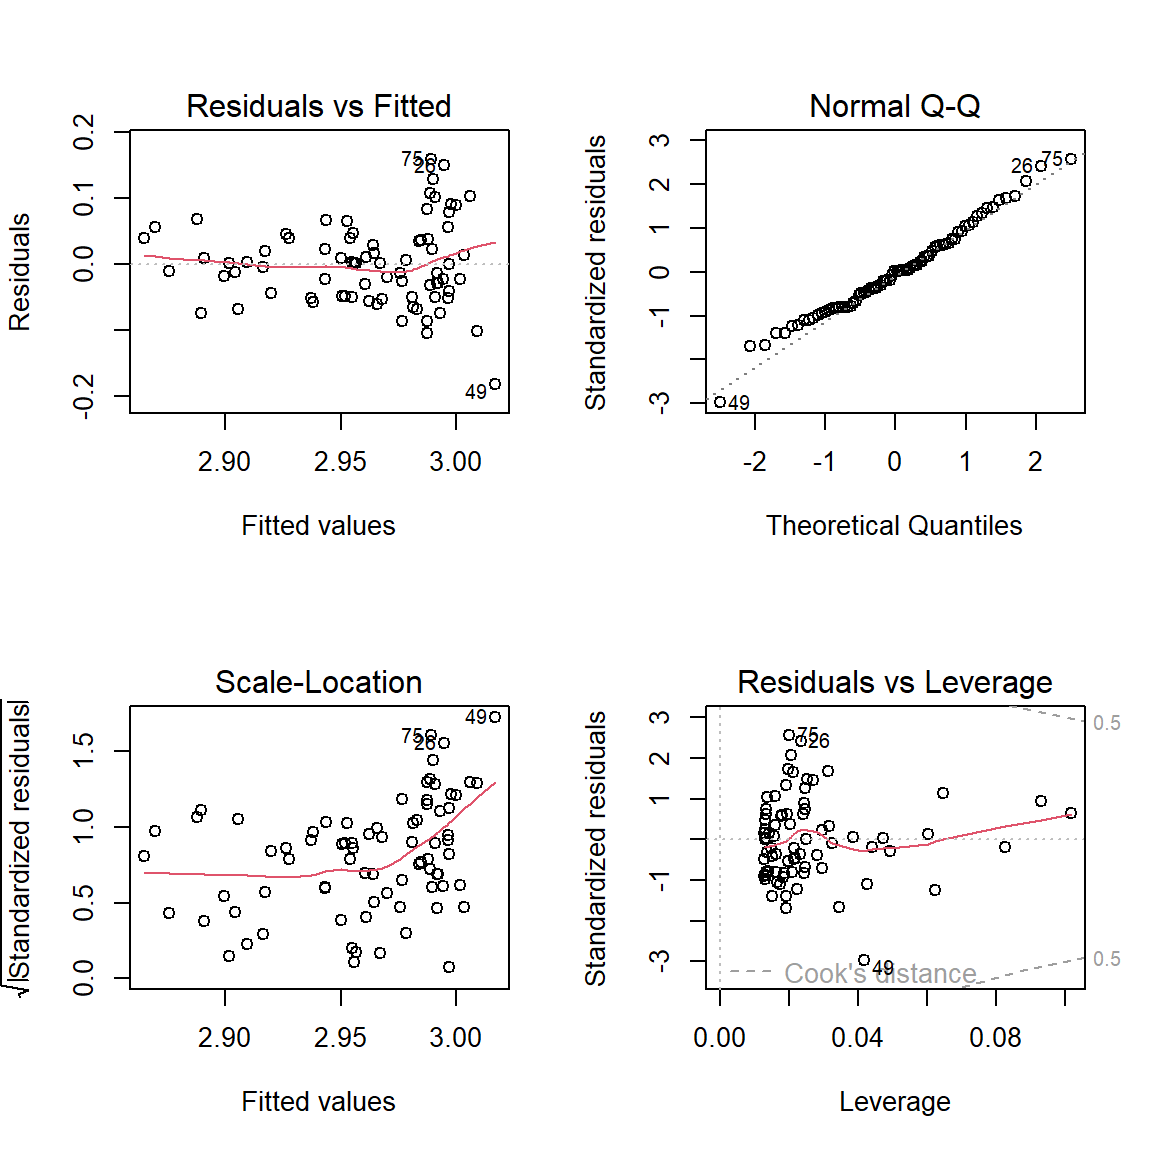
lm6 <- lm(log(SVL.final) ~ log(Age.DPO), data = ranas)
par(mfrow = c(2, 2))
plot(lm6)

par(mfrow = c(1, 1))
summary(lm6)

Call:
lm(formula = log(SVL.final) ~ log(Age.DPO), data = ranas)

Residuals:
      Min        1Q    Median        3Q       Max 
-0.182298 -0.049070  0.000516  0.038342  0.159057 

Coefficients:
             Estimate Std. Error t value Pr(>|t|)    
(Intercept)   3.44001    0.09211  37.345  < 2e-16 ***
log(Age.DPO) -0.11624    0.02232  -5.208 1.58e-06 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 0.06244 on 76 degrees of freedom
Multiple R-squared:  0.263, Adjusted R-squared:  0.2533 
F-statistic: 27.12 on 1 and 76 DF,  p-value: 1.581e-06

Interpretación de la regresión lineal

\[ y = mx + b \]


Call:
lm(formula = log(SVL.final) ~ log(Age.DPO), data = ranas)

Residuals:
      Min        1Q    Median        3Q       Max 
-0.182298 -0.049070  0.000516  0.038342  0.159057 

Coefficients:
             Estimate Std. Error t value Pr(>|t|)    
(Intercept)   3.44001    0.09211  37.345  < 2e-16 ***
log(Age.DPO) -0.11624    0.02232  -5.208 1.58e-06 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 0.06244 on 76 degrees of freedom
Multiple R-squared:  0.263, Adjusted R-squared:  0.2533 
F-statistic: 27.12 on 1 and 76 DF,  p-value: 1.581e-06
  • Por cada incremento en una unidad del logaritmo de Age.DPO, tenemos una unidad en descenso del logaritmo de SVL.final
ggplot(ranas, aes(x = log(Age.DPO), y = log(SVL.final))) +
  geom_point()+
  geom_smooth(method = "lm")

Interpretación de la regresión lineal

  • Sin embargo una interpretación en la escala logarítmica no es completamente entendible, al menos para alguien ajeno al análisis que realizamos.

  • Podríamos hacer la retransformación de las variables a sus unidades originales y generar un gráfico de las predicciones. A la final se reduce a matemática básica.

  • Afortunadamente la librería ggeffects nos salva de ese dilema!

library(ggeffects)
predicciones <- ggpredict(lm6)
predicciones
$Age.DPO
# Predicted values of SVL.final

Age.DPO | Predicted |         95% CI
------------------------------------
     35 |     20.63 | [20.05, 21.23]
     50 |     19.79 | [19.46, 20.13]
     60 |     19.38 | [19.11, 19.65]
     75 |     18.88 | [18.57, 19.20]
     90 |     18.48 | [18.08, 18.90]
    105 |     18.16 | [17.66, 18.67]
    120 |     17.88 | [17.30, 18.48]
    145 |     17.49 | [16.79, 18.22]

attr(,"class")
[1] "ggalleffects" "list"        
attr(,"model.name")
[1] "lm6"
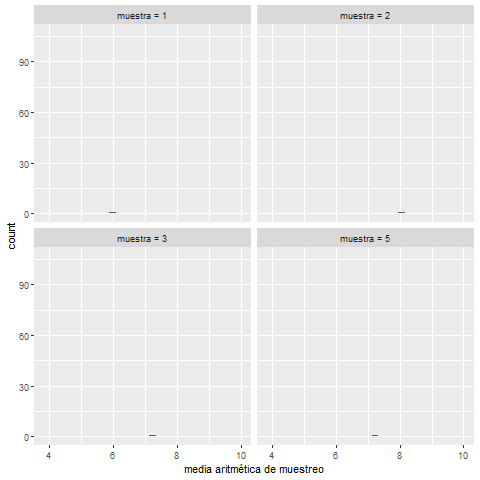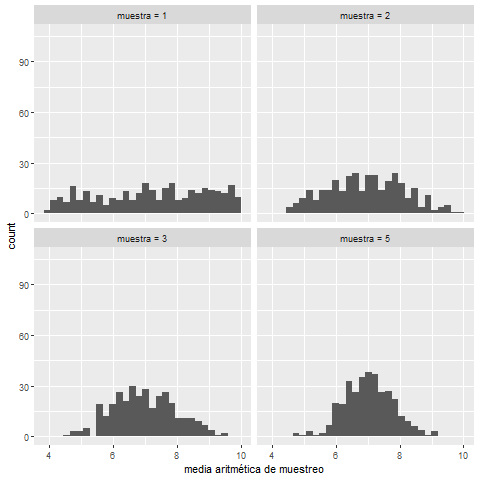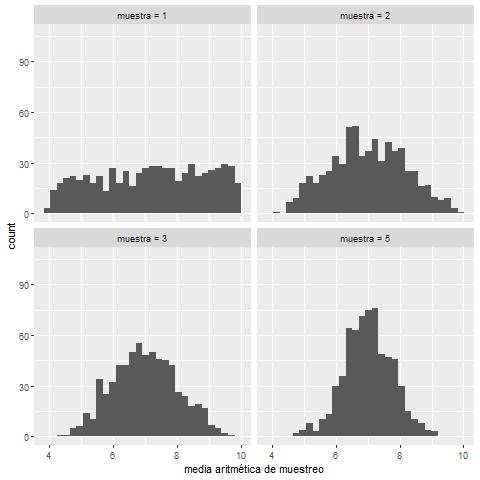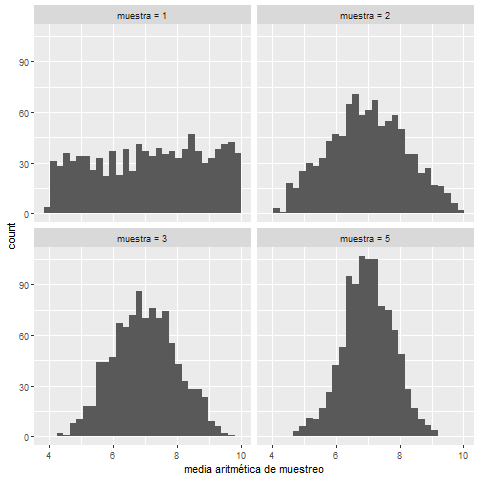
  • Y finalmente el gráfico de predicciones
plot(predicciones)
$Age.DPO

¡Antes de terminar!

El mágico \(R^2\)

El mágico \(R^2\)

  • Quizá muchos hayan escuchado que un \(R^2\) cercano a 1 es “ideal” cuando realizamos una regresión lineal.

  • Recuerdo incluso haber sido indoctrinado acerca de márgenes para un buen \(R^2\) (algo así como que por encima del 80% es “bueno”, mayor al 90% es excelente y 100% es el Nirvana).

  • En breve, \(R^2\) NO ES NINGUNA DE LAS SIGUIENTES COSAS:

    • Una métrica de bondad de ajuste: no nos dice si el modelo se ajusta bien a los datos.

    • Una métrica del error de predicción: no mide para nada que tan bueno es el modelo para predecir futuras observaciones.

    • Una métrica que permita comparar modelos usando variables transformadas: es común jugar a transformar los datos para ver de que manera se puede inflarlo hacia el santo grial.

    • Una métrica que permita que tan bien una variable explica otra: en el ejemplo que vimos, y en toda regresión lineal, si cambiamos el predictor por respuesta y viceversa, tendremos exactamente el mismo \(R^2\)

  • \(R^2\) es simplemente una medida de la cantidad de variación que un modelo específico explica. ¿Tiene alguna utilidad práctica? no lo sé, en 10 años como estadístico no lo he usado nunca, al menos no, voluntariamente…

El mágico \(R^2\)

¡Gracias!