Módulo 3: Análisis Exploratorio de Datos e introducción a ggplot2
El análisis exploratorio de datos (AED) es una herramienta bastante útil pero a menudo olvidada.
Entre los muchos objetivos del AED, están:
Obtener una idea de la distribución de los datos
Llevar a cabo un control de la calidad de los datos (valores anómalos u outliers, errores)
Identificar observaciones perdidas y su severidad
Identificar correlaciones entre variables
El AED es mayoritariamente visual. Por ello aprovecharemos esta oportunidad para llevar a cabo una introducción a la librería ggplot2 y también haremos uso de los gráficos base de R cuando amerite el caso.
Utilizaremos dos tablas de datos, los pingüinos de Palmer (librería palmerpenguins) y rotXLS, que utilizamos brevemente en el primer módulo.
Utilizaremos librerías adicionales a lo largo de este módulo que serán debidamente descritas.
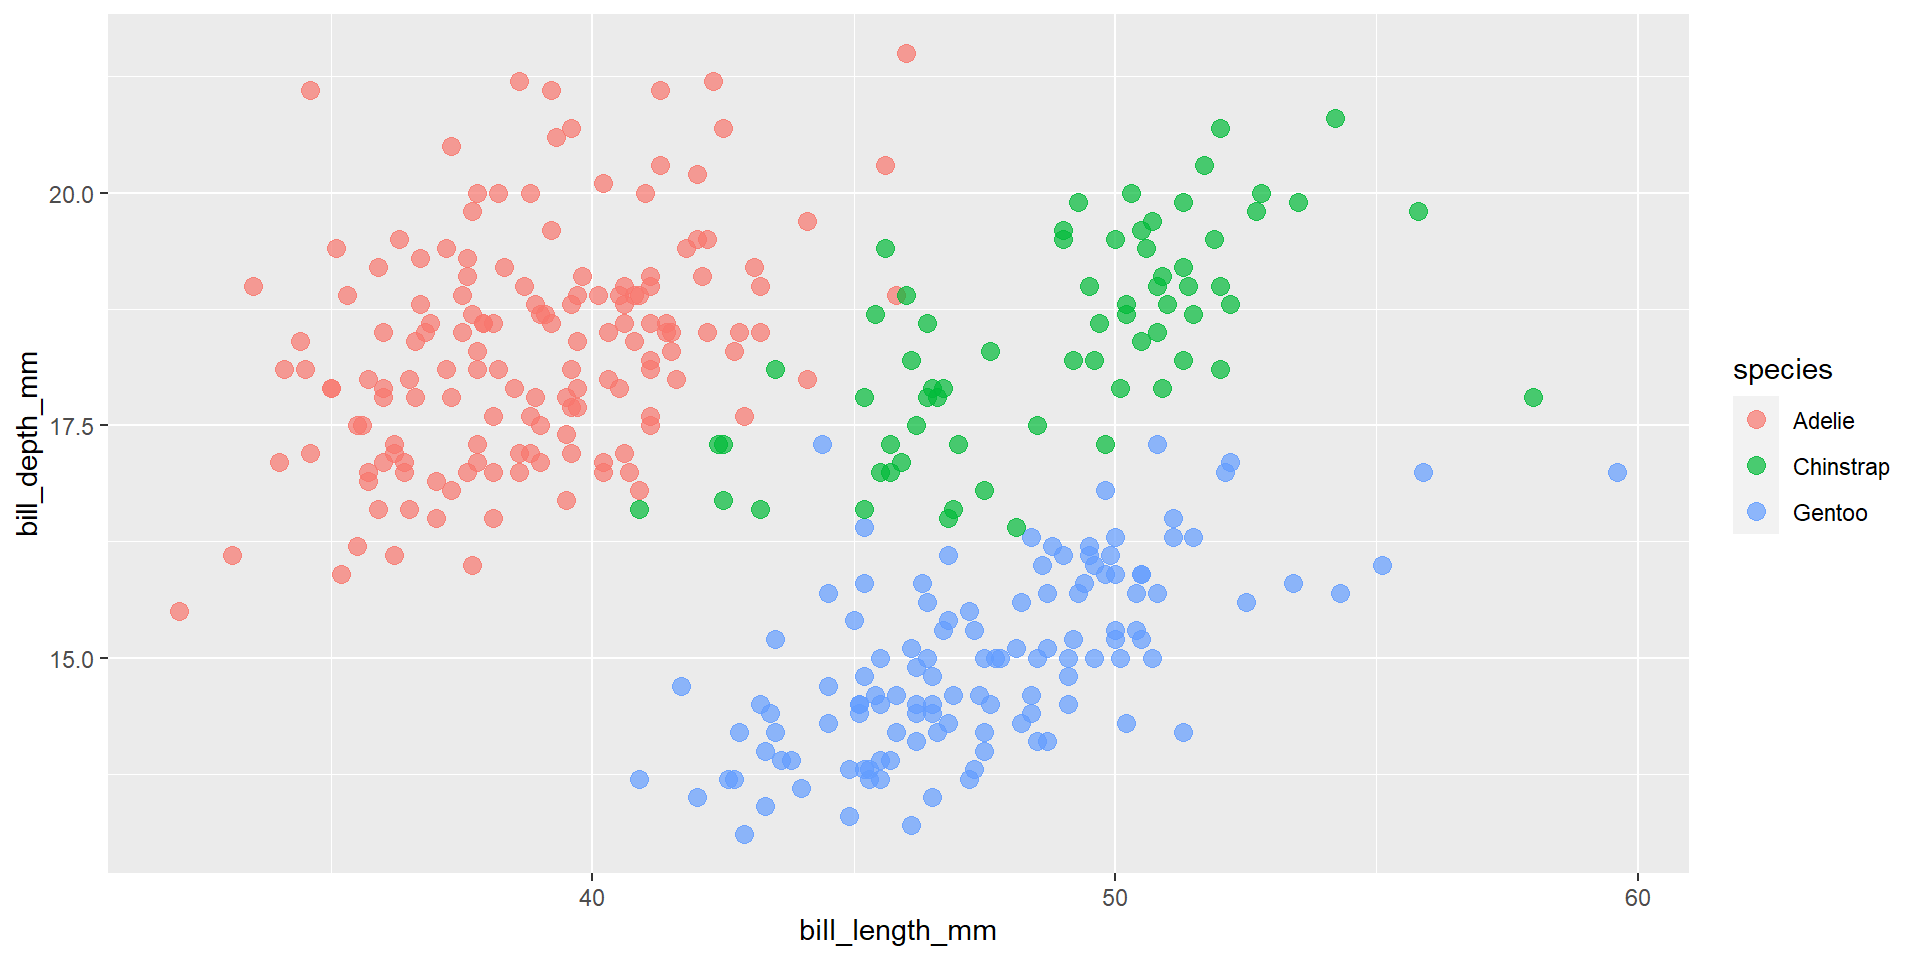
ggplot2ggplot2ggplot2 es una librería de gráficos de R creada por Hadley Wickham en 2005 como una opción alternativa a los gráficos base de R.
Su funcionamiento se basa en añadir elementos a un gráfico capa por capa.
Presenta varias ventajas, entre ellas:
Mayor versatilidad al integrar funciones predeterminadas que permiten cambiar entre tipos de gráficos fácil y rápidamente.
Amplia variedad de paletas de color y estilos (útiles para crear gráficos profesionales y listos para publicación).
Basta cantidad de librerías accesorias para gráficos especializados.
Existen varias geometrías útiles para diversos tipos de gráficos
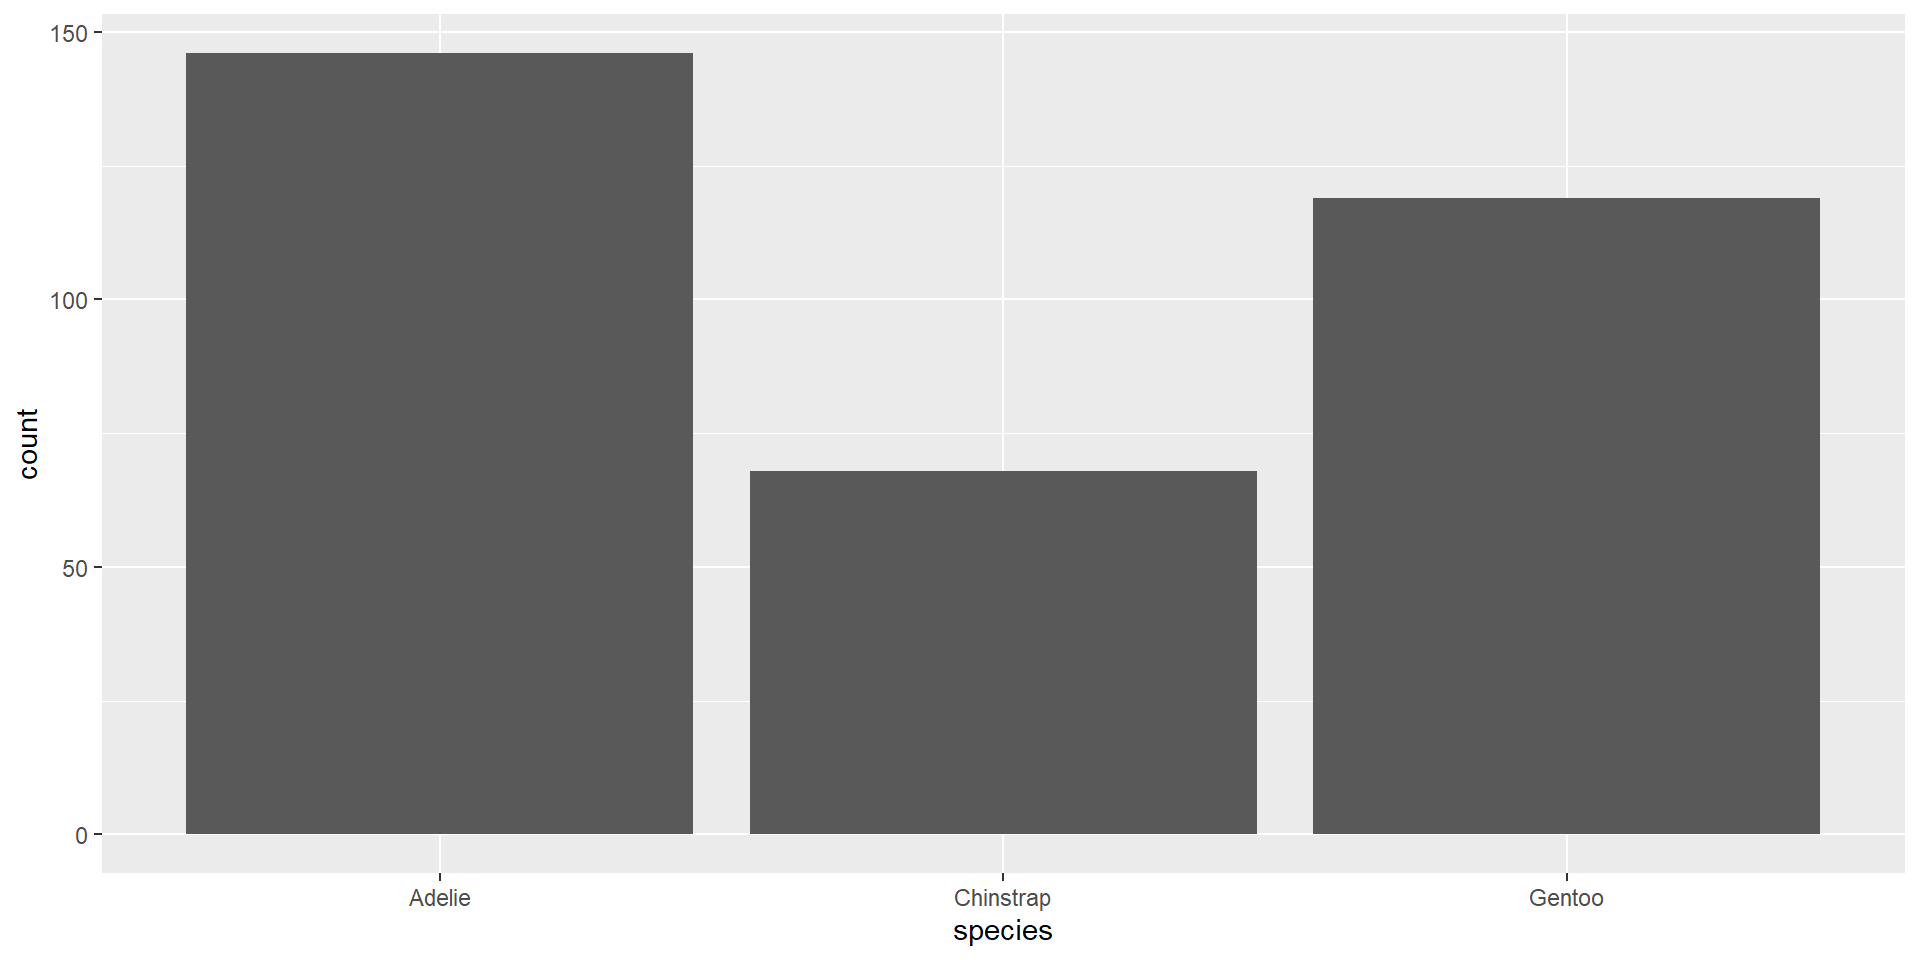
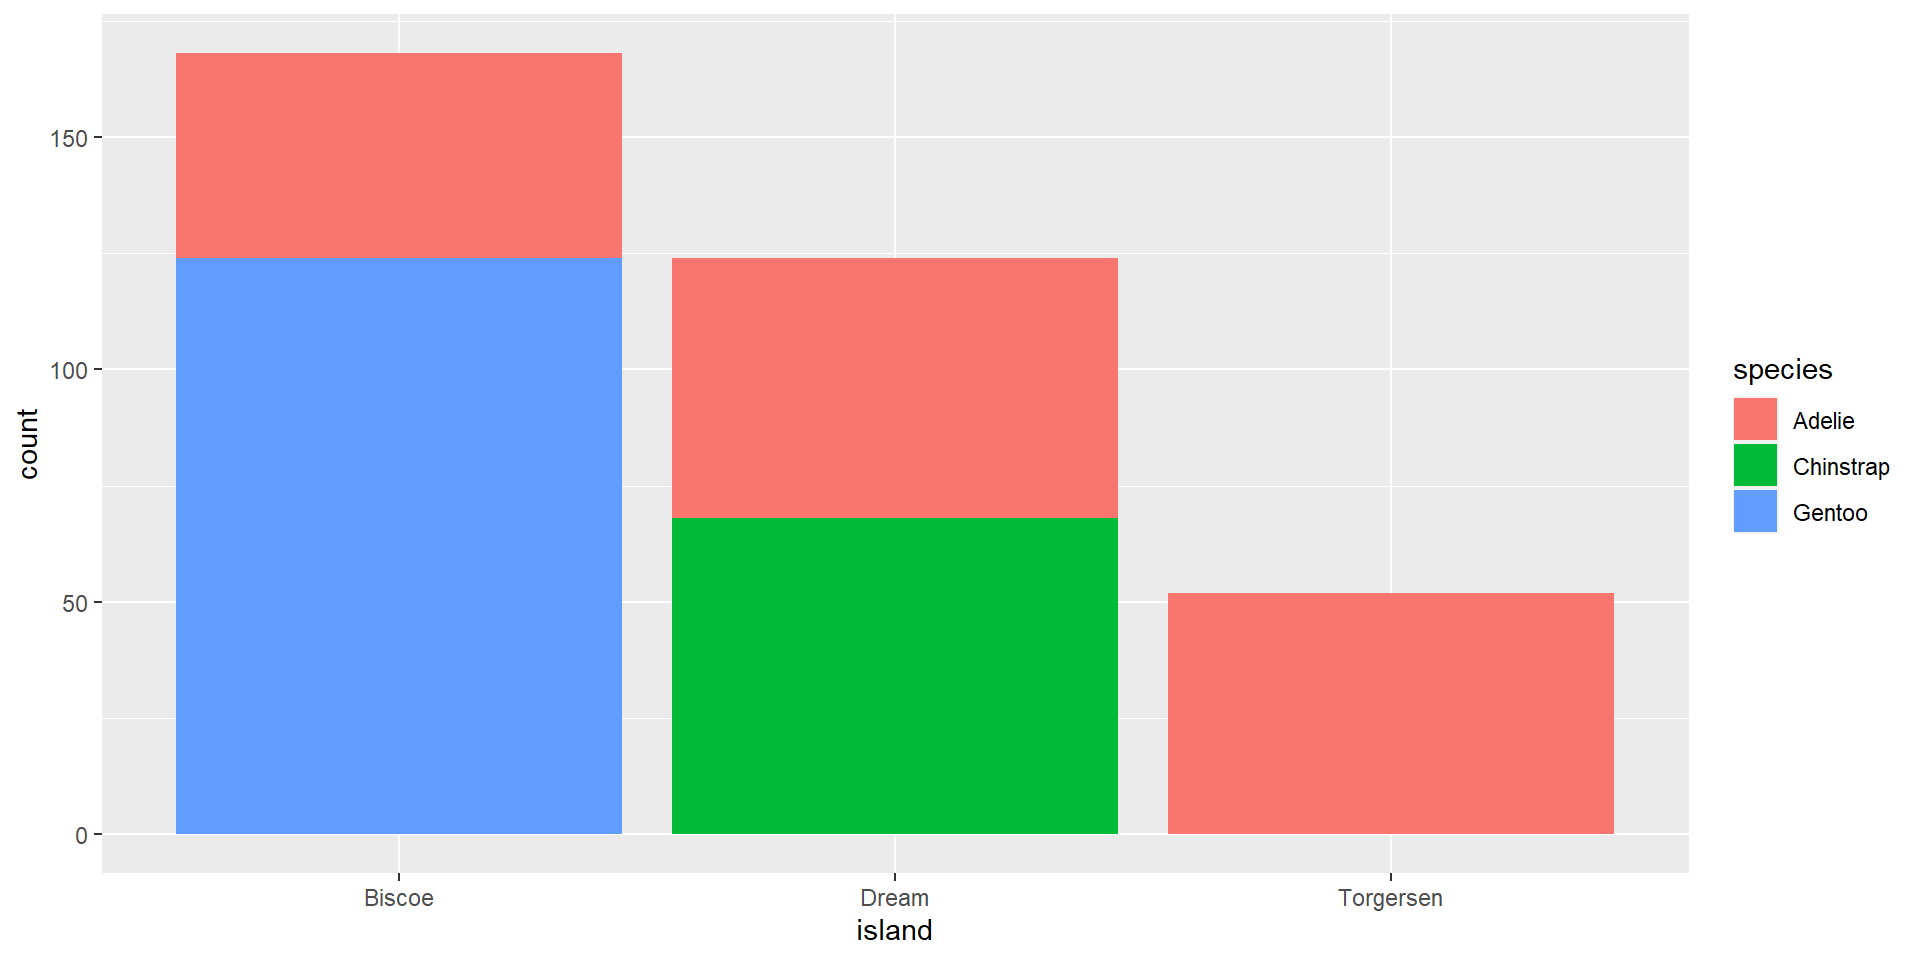
geom_bar para gráficos de barras
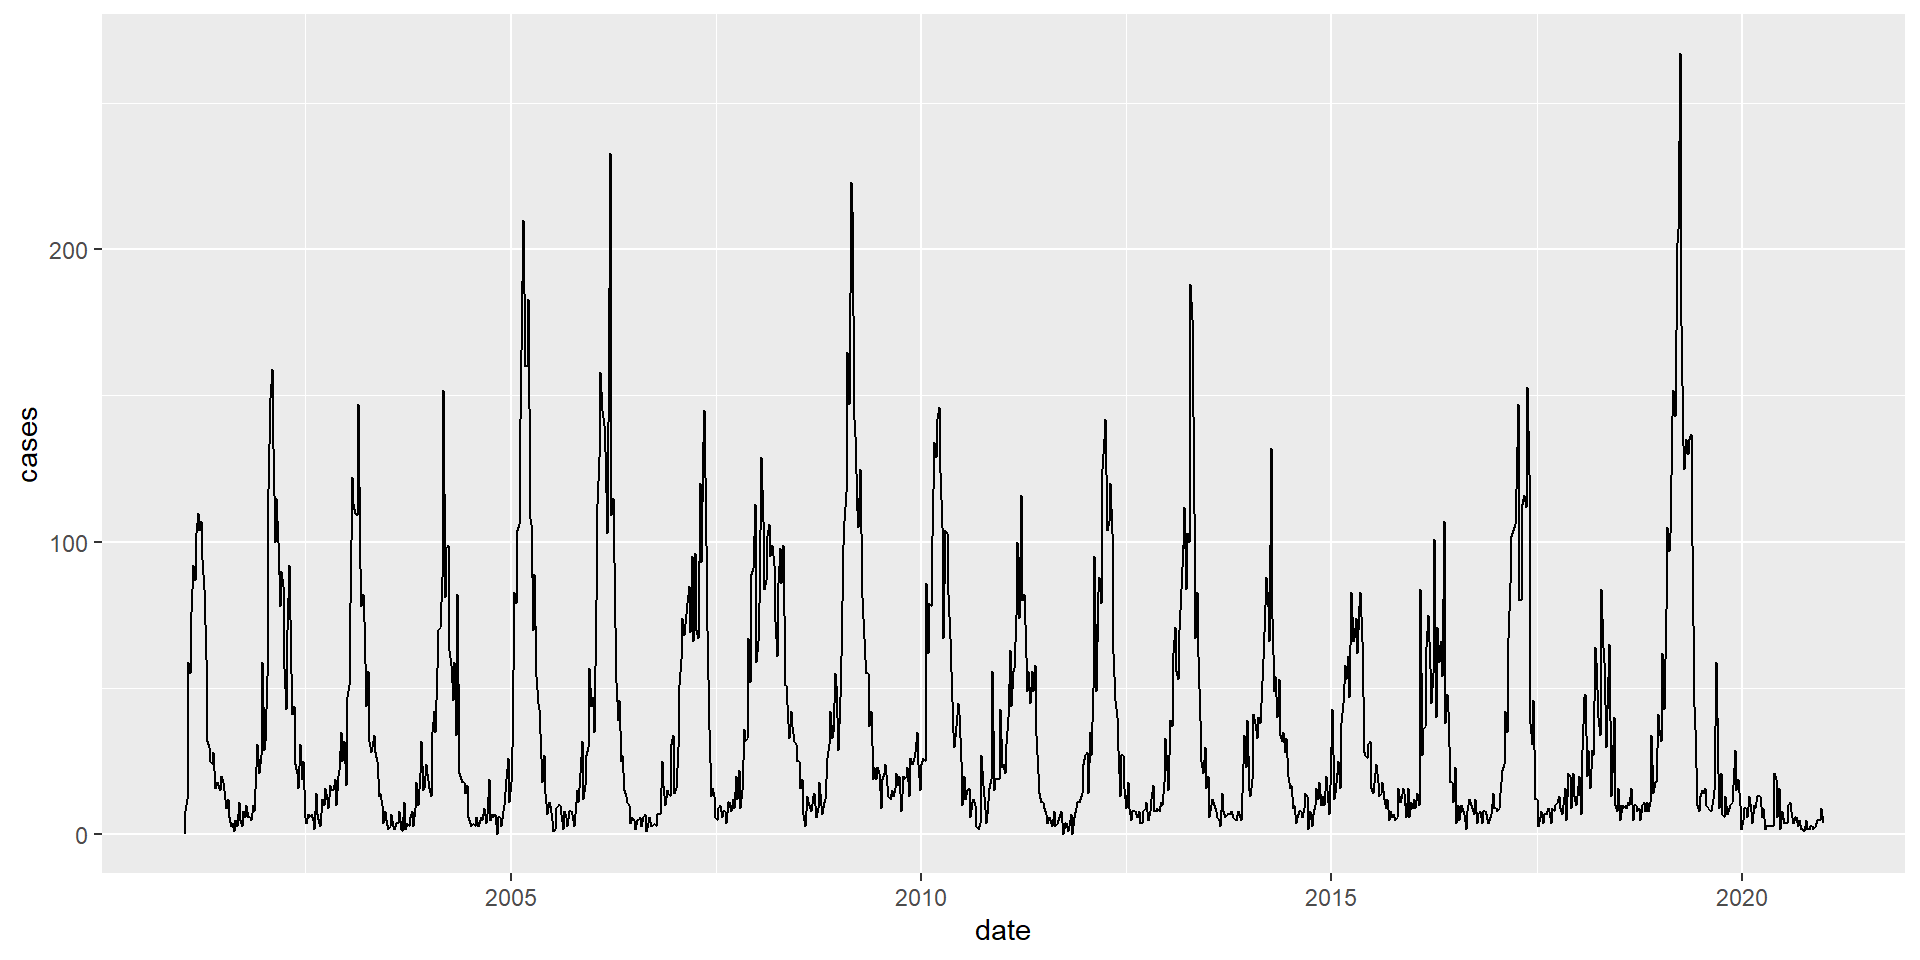
geom_line para gráficos de lineas
geom_boxplot para gráficos de caja y bigote
geom_histogram para histogramas
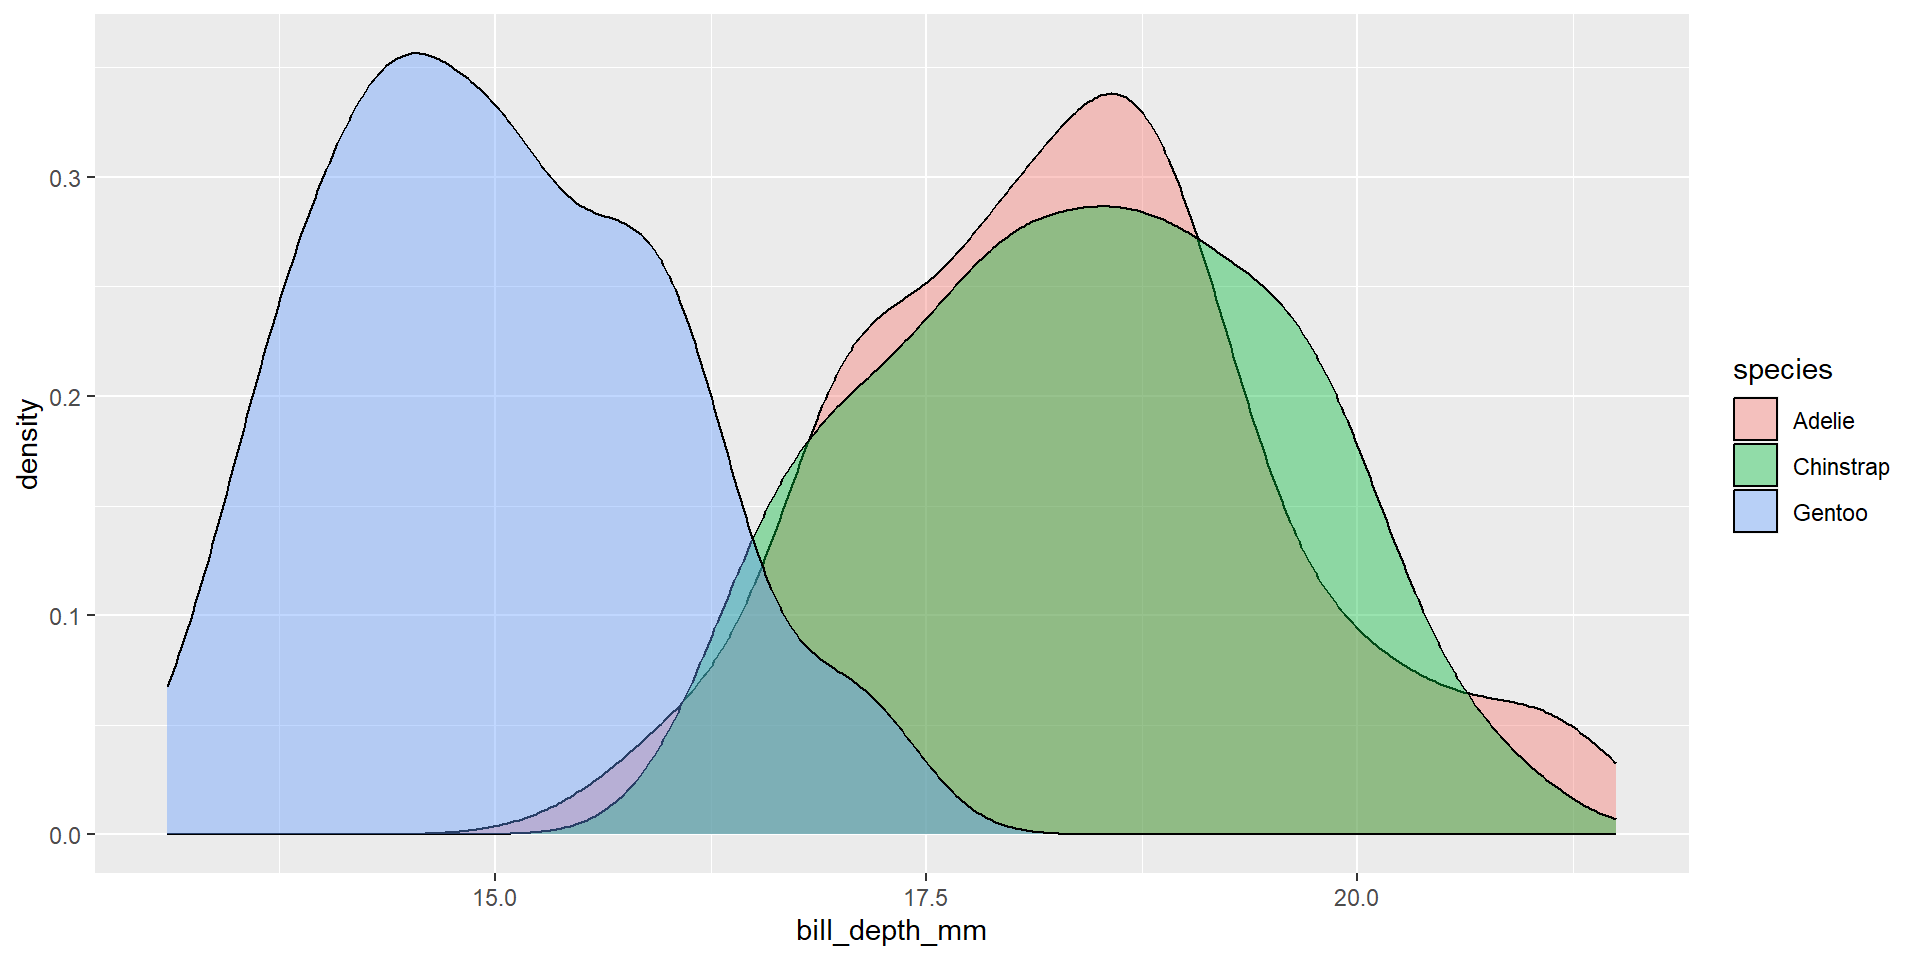
geom_density para densidades
y muchas más, entre ellas, geometrías estadísticas
Una de las razones por las cuales ggplot2 es tan popular, es la relativa sencillez de usar distintas paletas de color.
Al no ser un curso dedicado a visualización de datos, nos limitaremos a explorar la oferta de mis dos librerías preferidas para paletas de color con ggplot2.
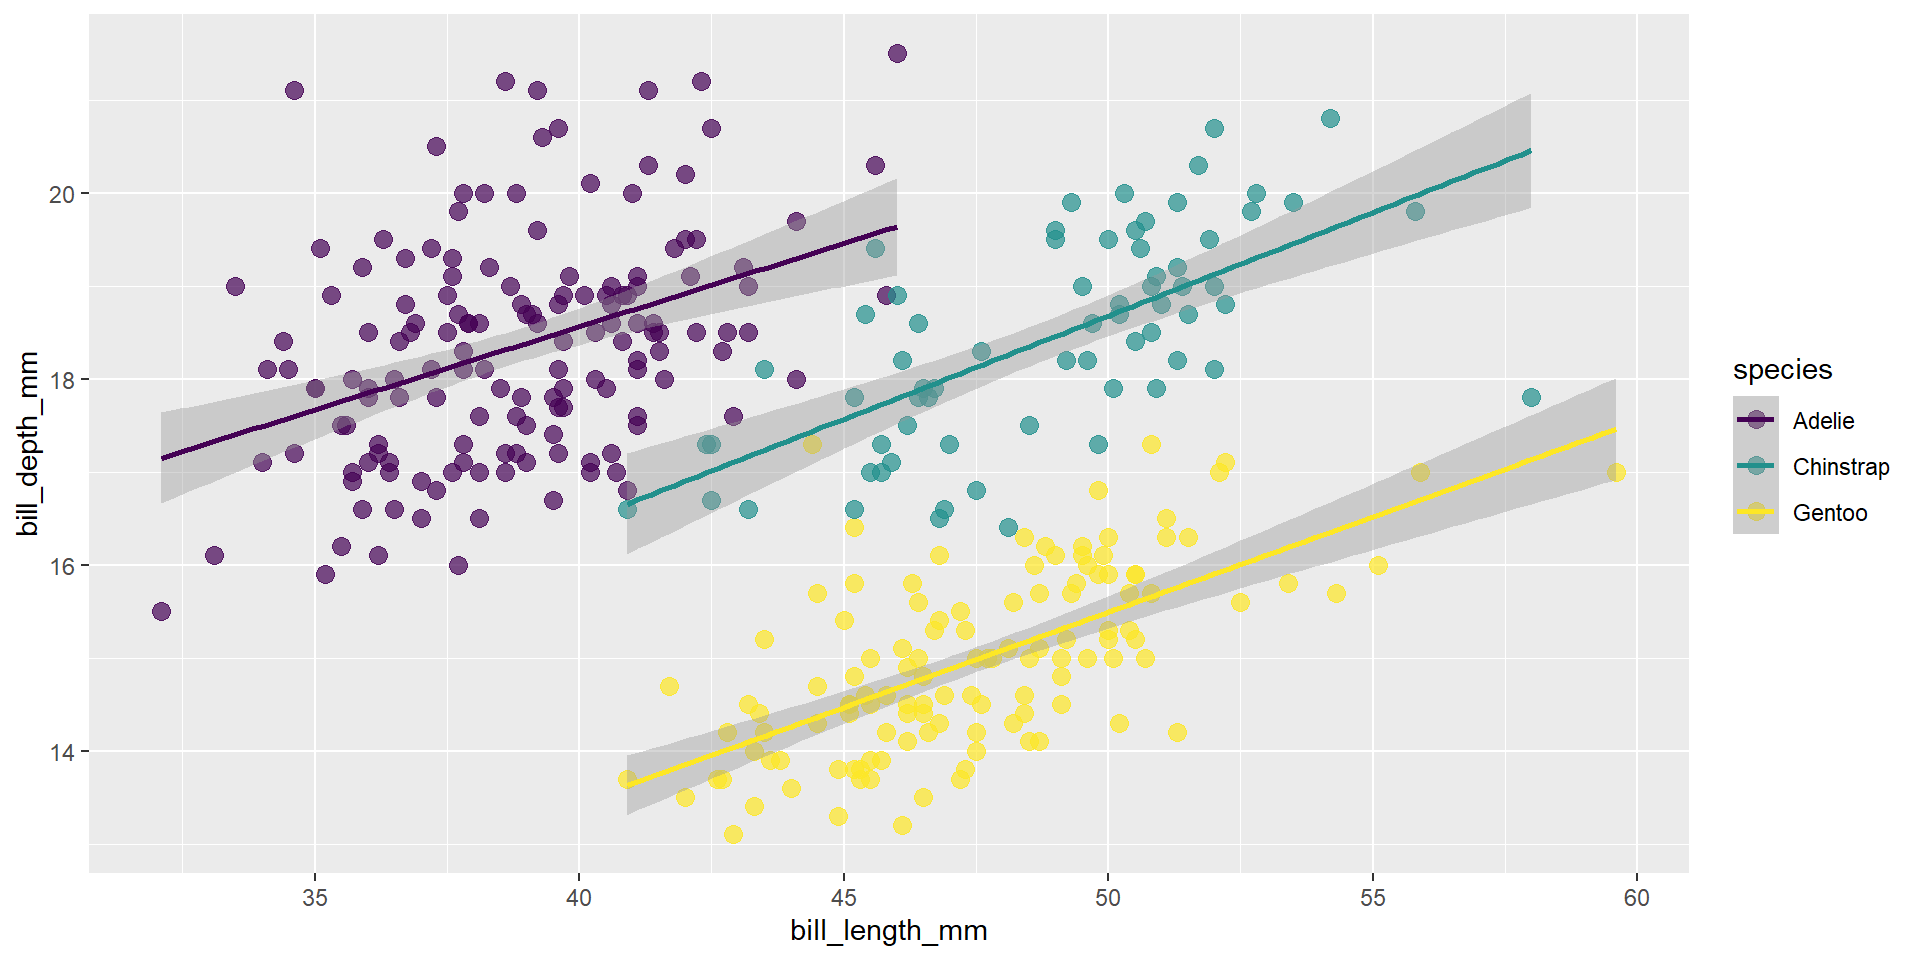
viridis ofrece 8 paletas de color basadas en secuencias de azul y amarillo que evitan en la medida de lo posible el color rojo. Es recomendada por ciertos Journals al ser amigable con personas daltónicas.
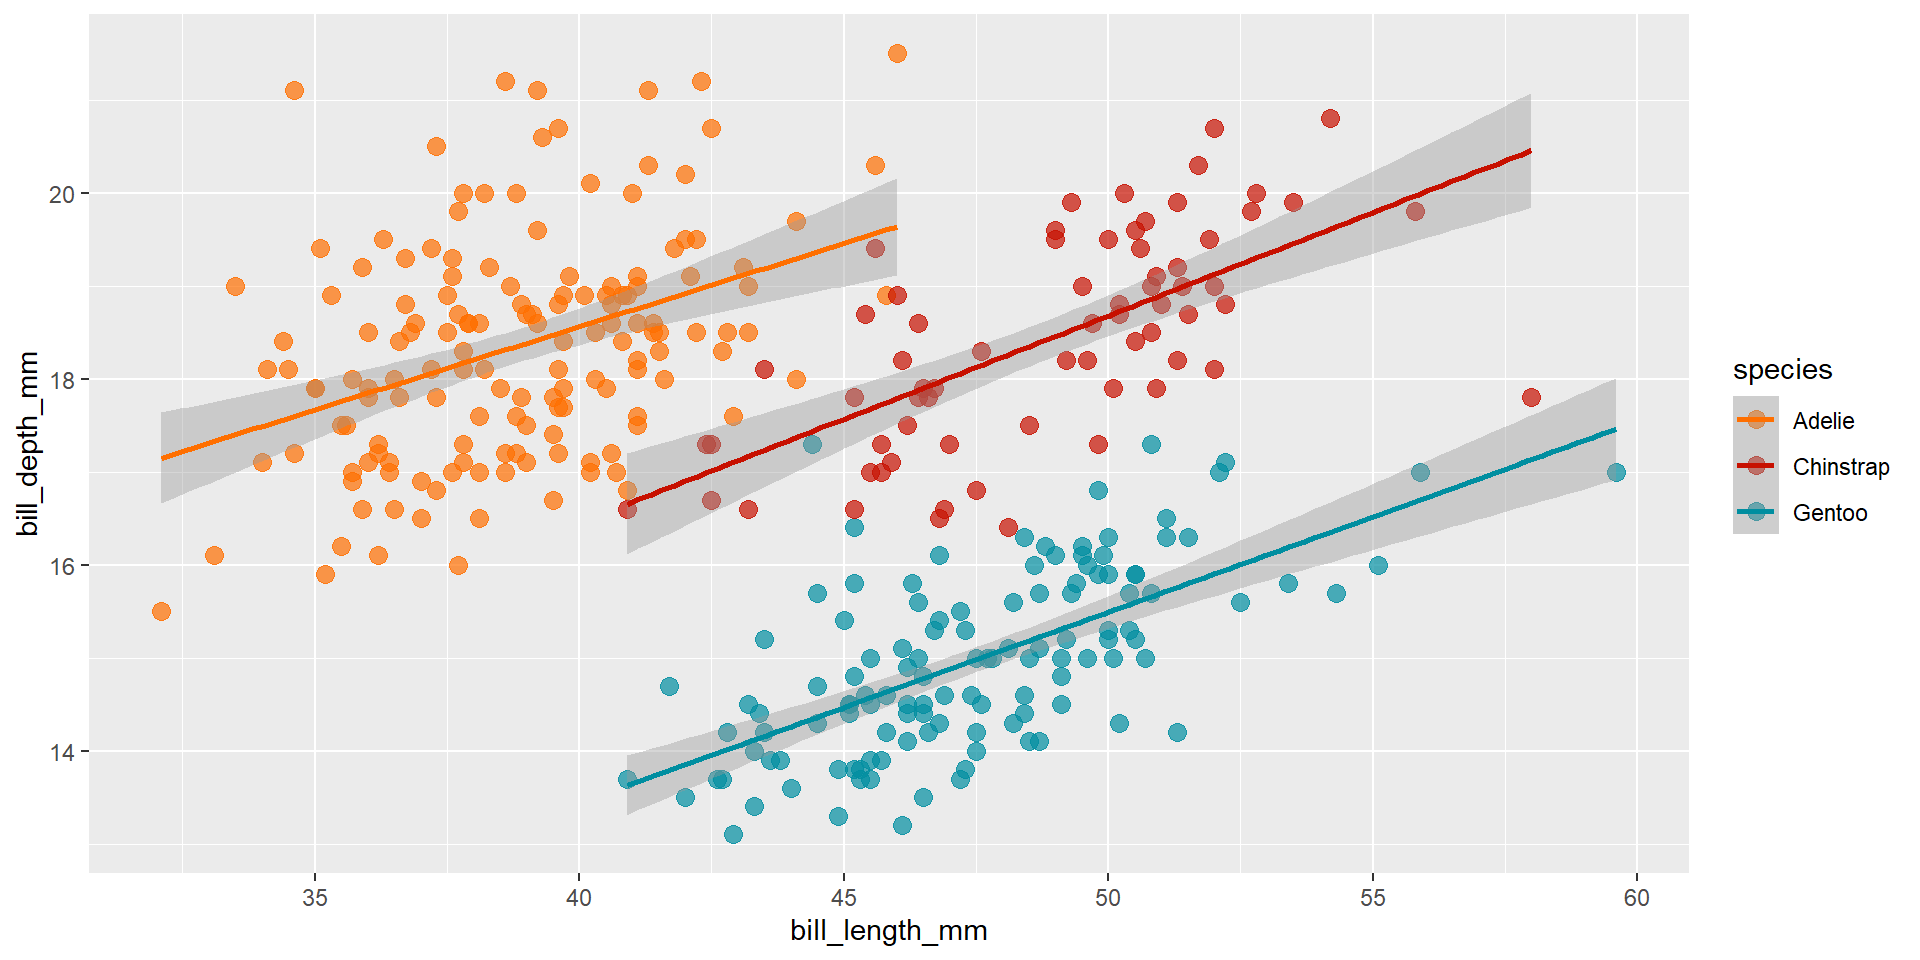
ggsci ofrece varias paletas de color inspiradas en los colores usados por distintos journals (por ejemplo: Nature, Lancet entre otros), además de paletas inspiradas en series de televisión (por ejemplo: Futurama, Rick & Morty entre otros).
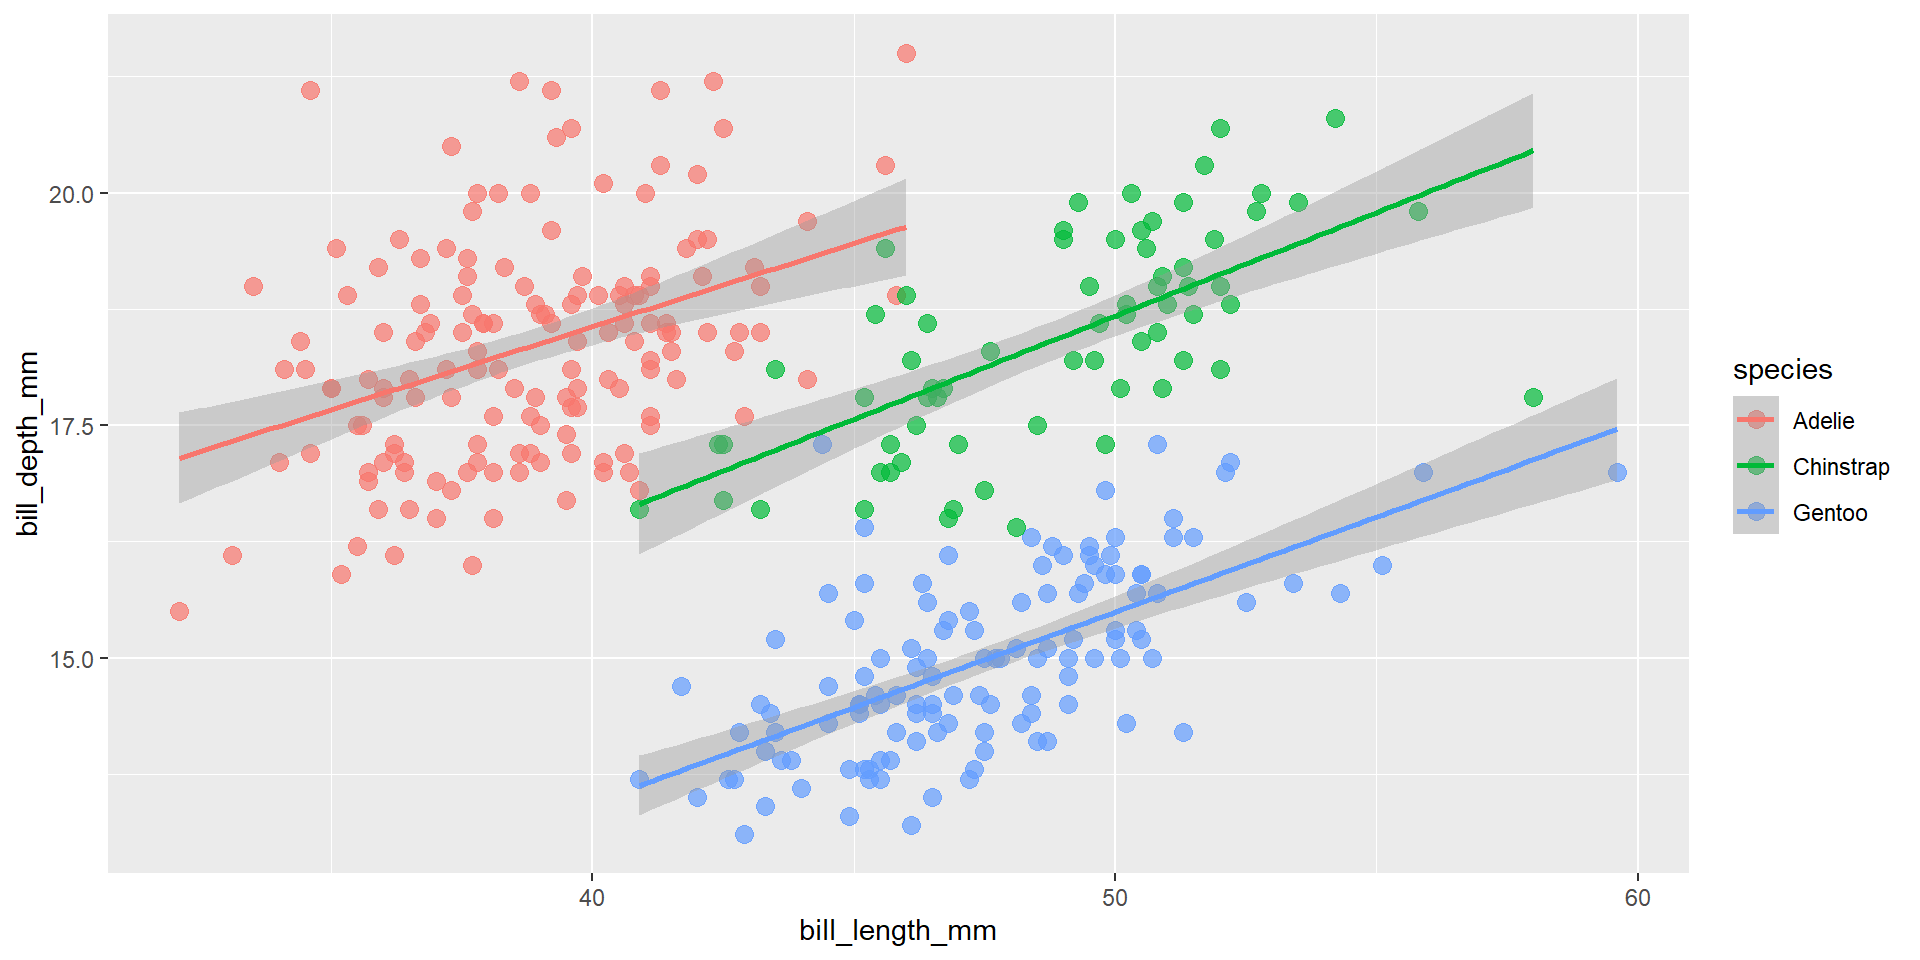
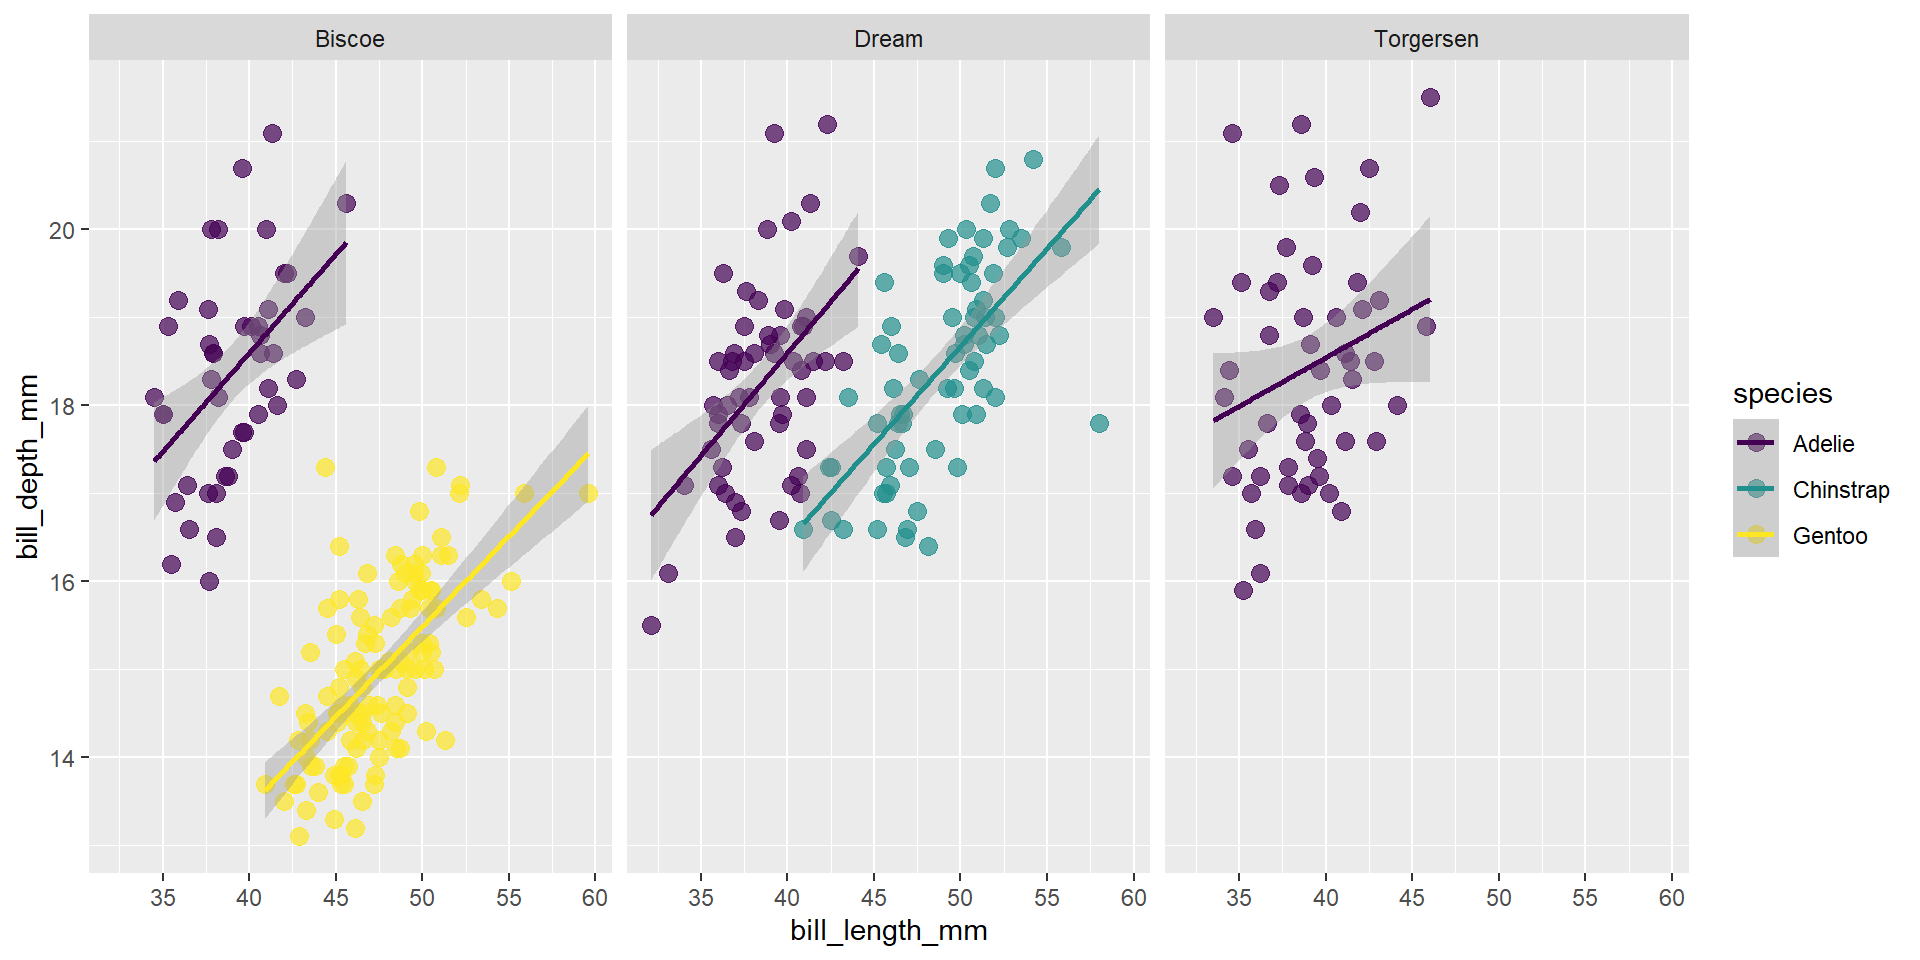
ggplot(penguins,
aes(x = bill_length_mm, y = bill_depth_mm, colour = species)) +
geom_point(alpha = 0.7,
size = 3) +
geom_smooth(method = "lm") +
scale_x_continuous(breaks = seq(30, 60, 5)) +
scale_y_continuous(breaks = seq(10, 24, 2)) +
scale_color_viridis(discrete = T) +
facet_wrap(~island) +
labs(title = "Largo de pico vs. Profundidad de pico",
subtitle = "Pingüinos de Palmer",
caption = "Gráfica propia",
x = "Largo del pico",
y = "Profundidad del pico",
color = "Especie")
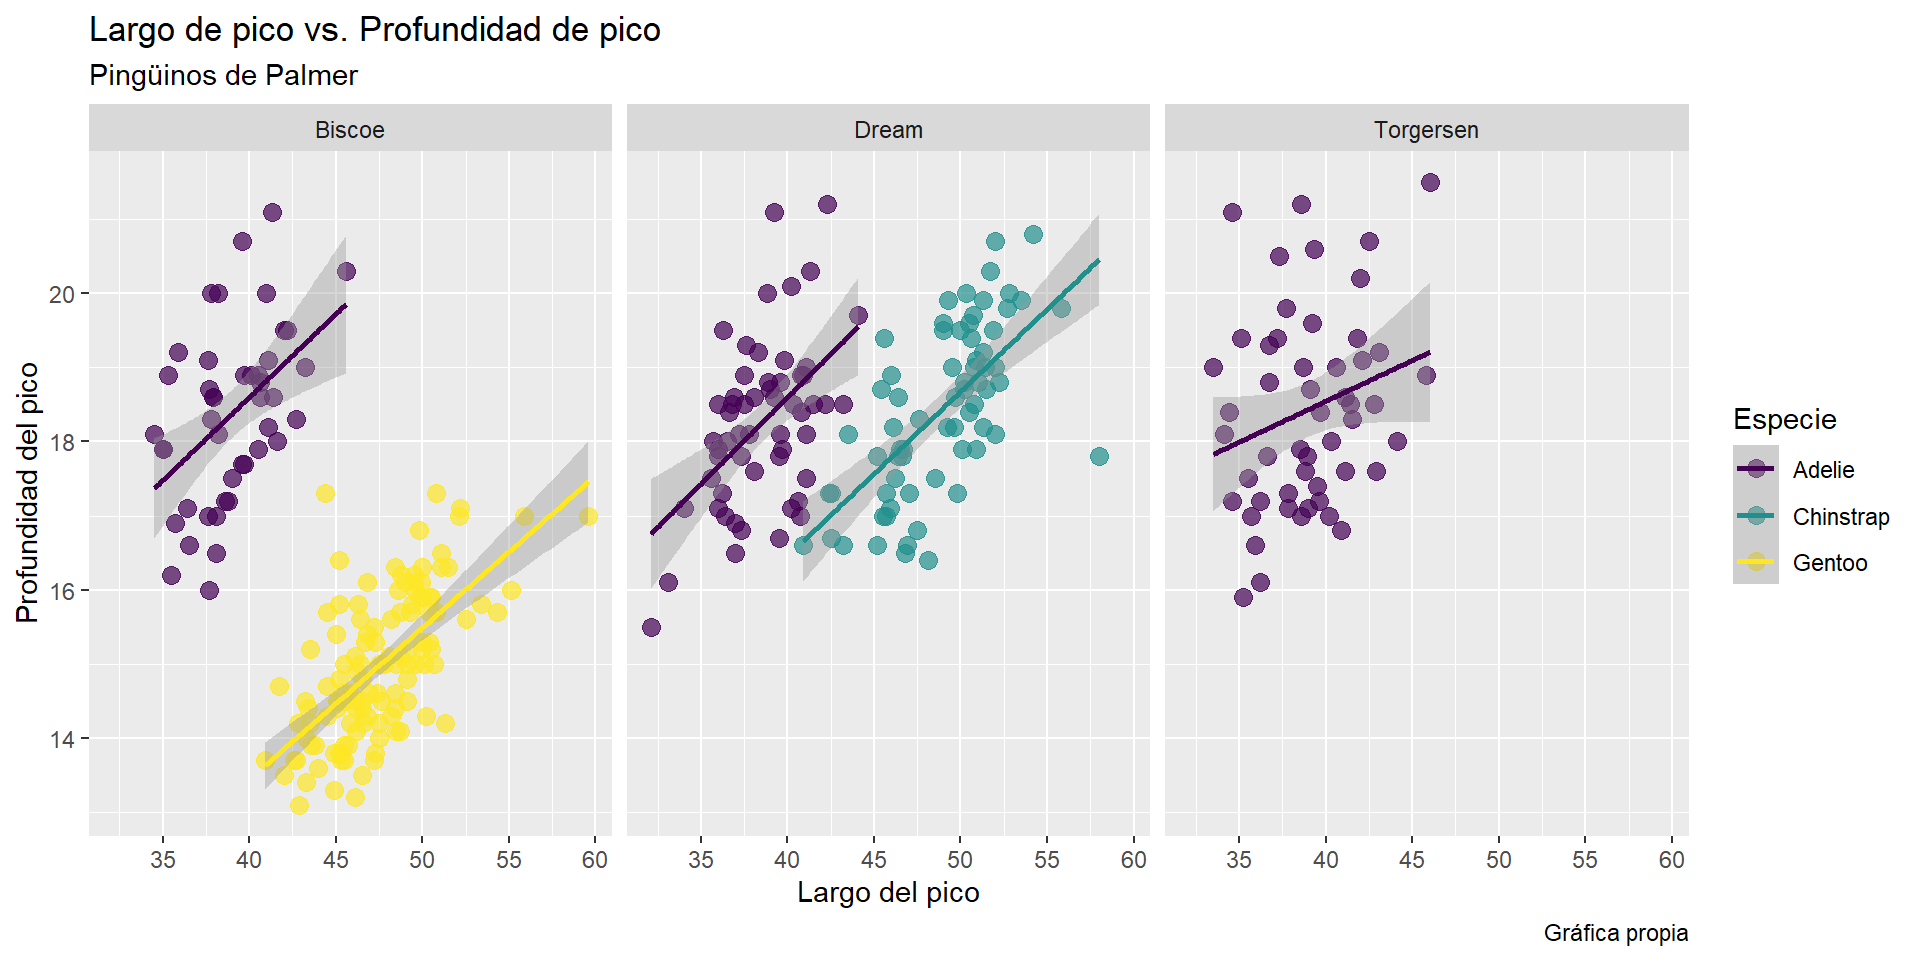
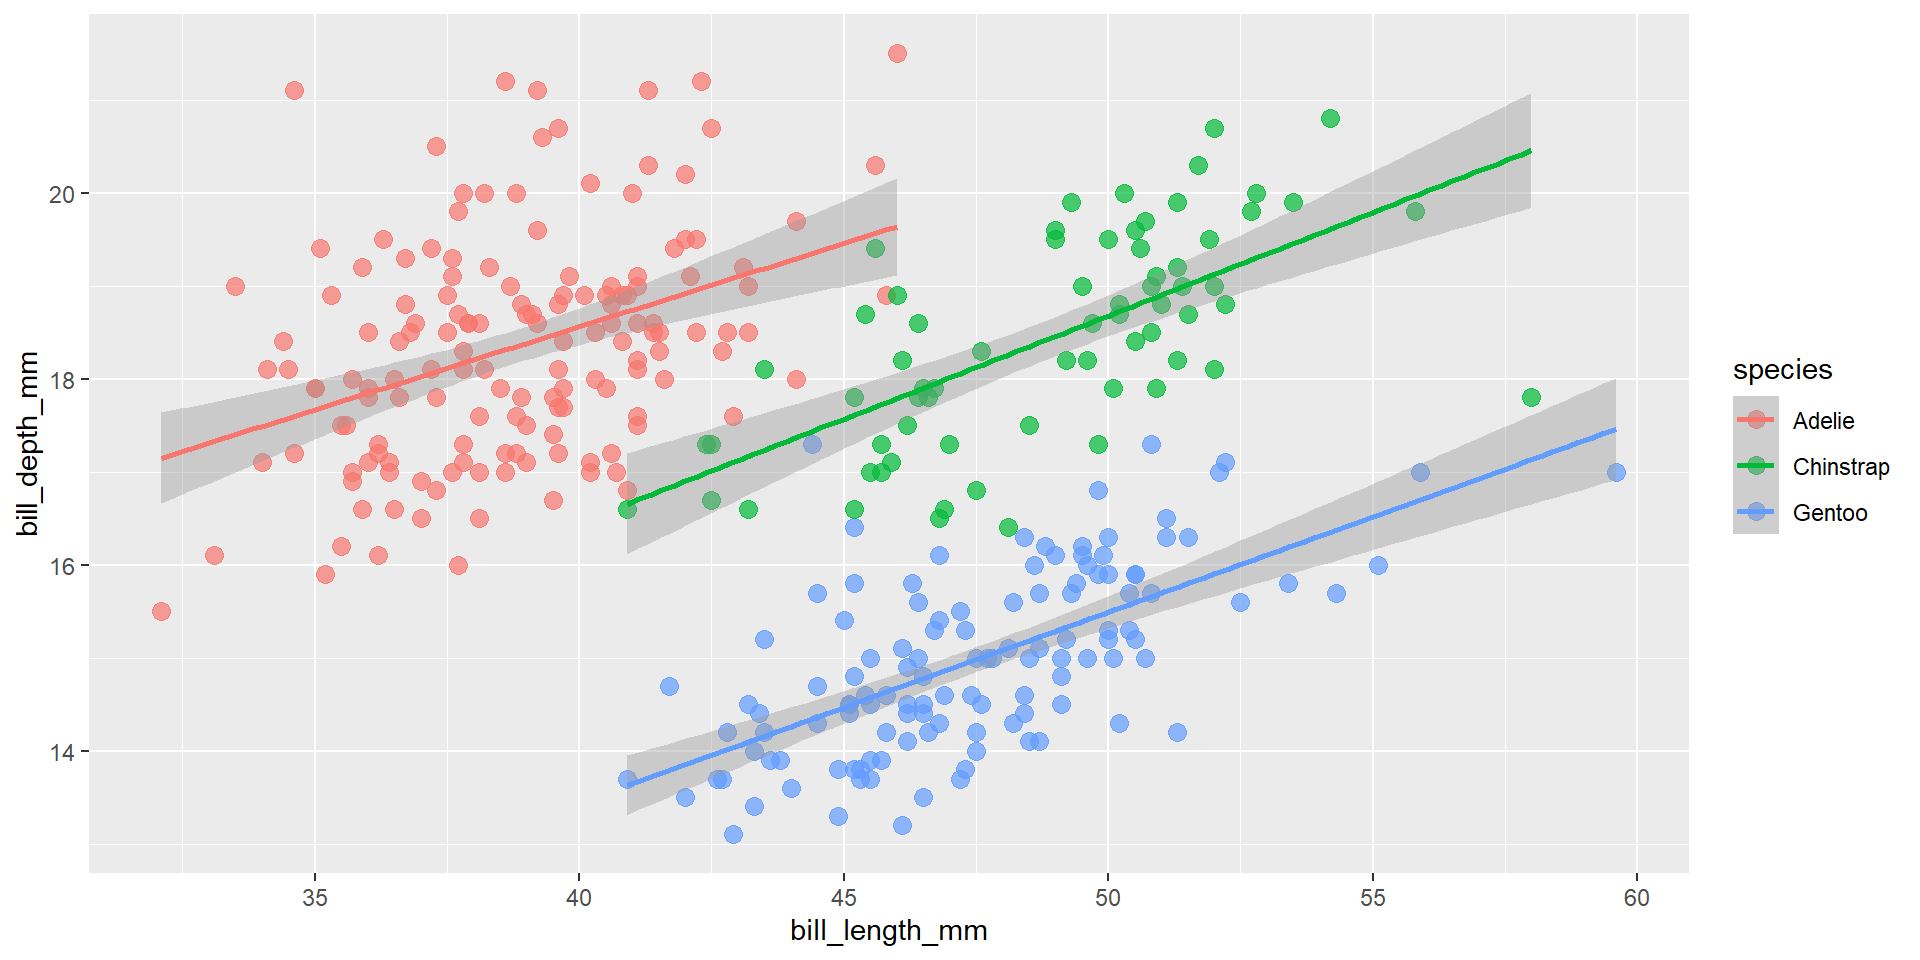
ggplot(penguins,
aes(x = bill_length_mm, y = bill_depth_mm, colour = species)) +
geom_point(alpha = 0.7,
size = 3) +
geom_smooth(method = "lm") +
scale_x_continuous(breaks = seq(30, 60, 5)) +
scale_y_continuous(breaks = seq(10, 24, 2)) +
scale_color_viridis(discrete = T) +
facet_wrap(~island) +
labs(title = "Largo de pico vs. Profundidad de pico",
subtitle = "Pingüinos de Palmer",
caption = "Gráfica propia",
x = "Largo del pico",
y = "Profundidad del pico",
color = "Especie") +
theme_bw()
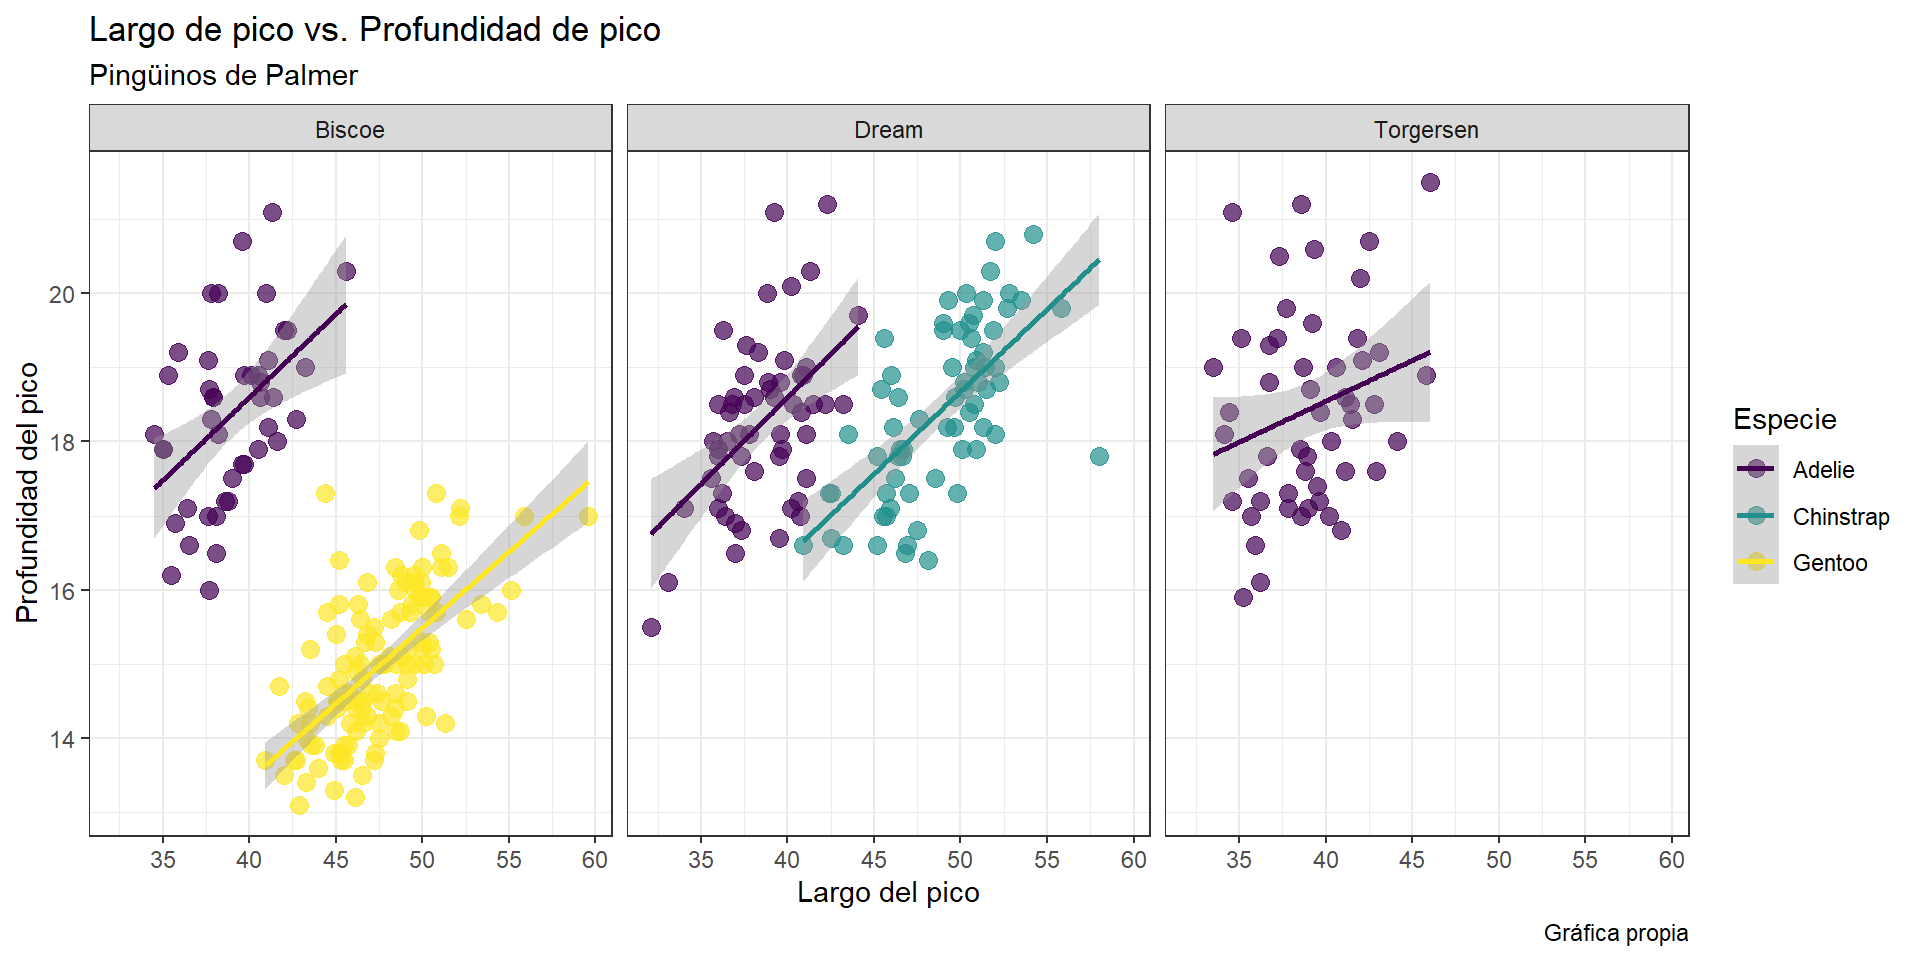
grafico1 <- ggplot(penguins,
aes(x = bill_length_mm, y = bill_depth_mm, colour = species)) +
geom_point(alpha = 0.7,
size = 3) +
geom_smooth(method = "lm") +
scale_x_continuous(breaks = seq(30, 60, 5)) +
scale_y_continuous(breaks = seq(10, 24, 2)) +
scale_color_viridis(discrete = T) +
facet_wrap(~island) +
labs(title = "Largo de pico vs. Profundidad de pico",
subtitle = "Pingüinos de Palmer",
caption = "Gráfica propia",
x = "Largo del pico",
y = "Profundidad del pico",
color = "Especie") +
theme_bw()
grafico2 <- grafico1 + theme_classic()
grafico2
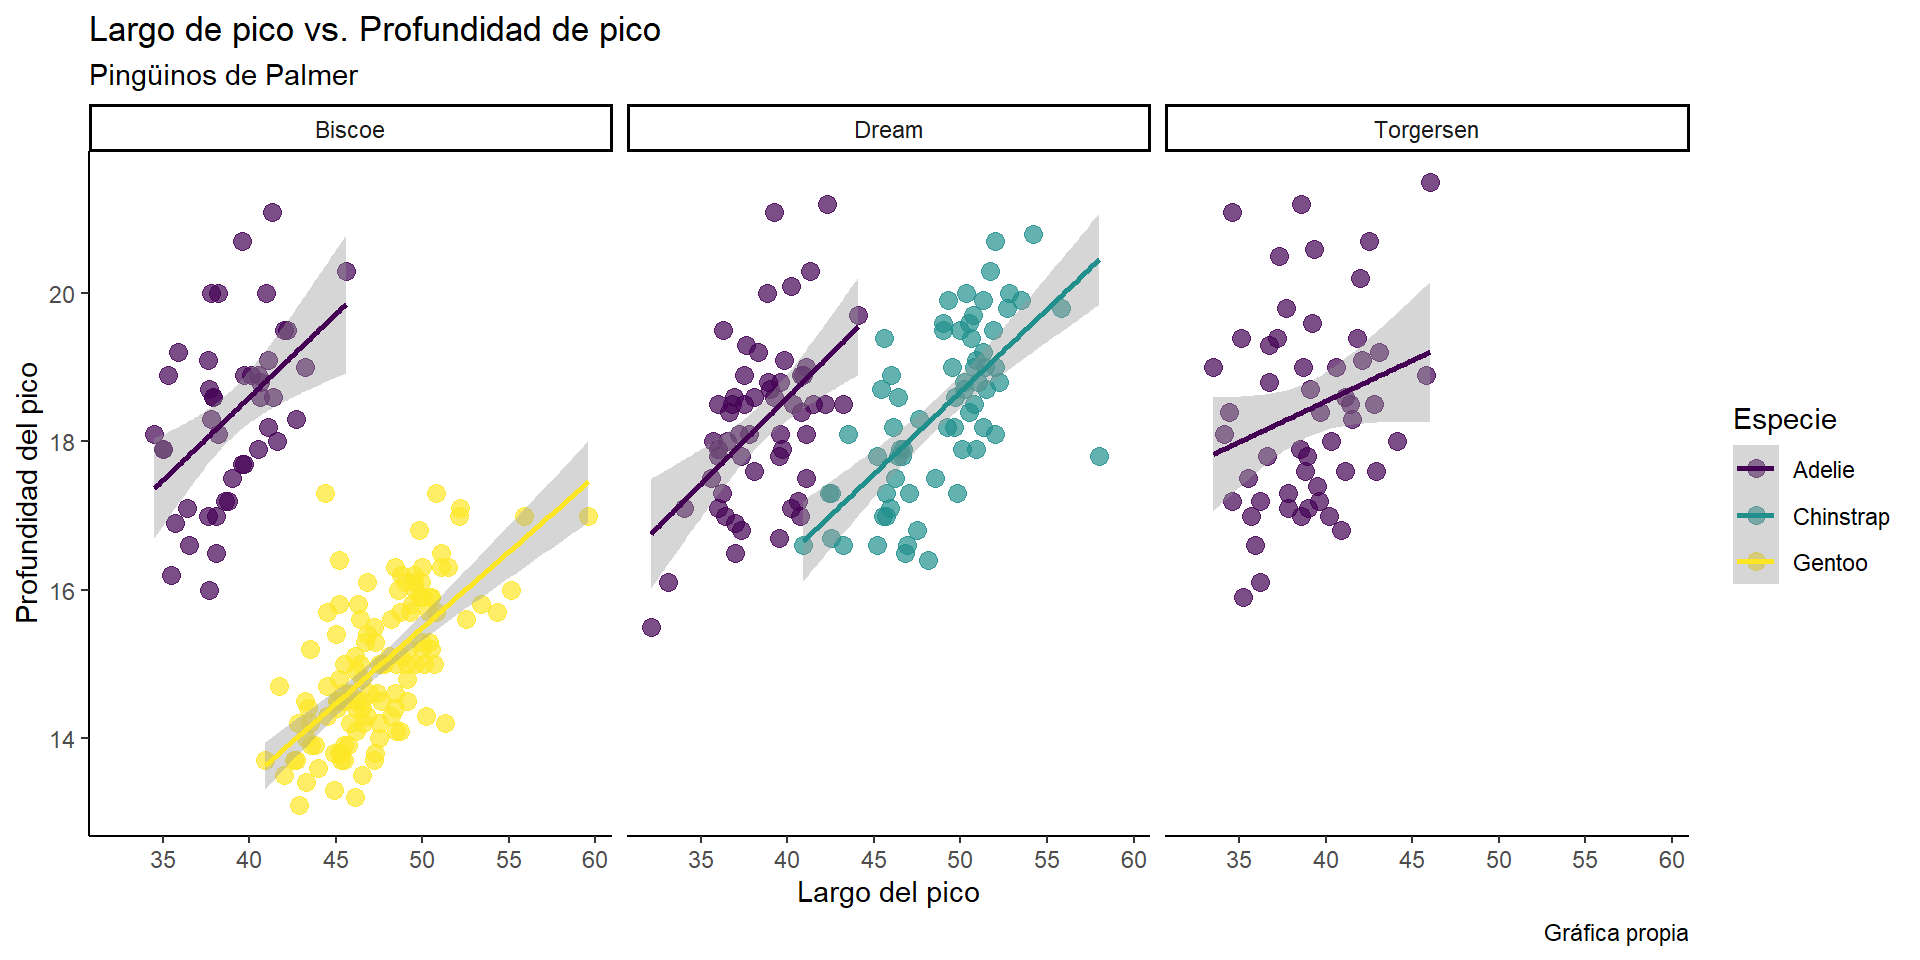
Con la ayuda del anterior código, realiza un gráfico de dispersión entre las variables flipper_length_mm y body_mass_g en facetas determinadas por la variable sex. Para explorar más opciones de las paletas de color y los estilos, puedes usar las siguientes expresiones:
viridis:
scale_color_viridis(discrete = T, option = "A") donde el argumento option te permite escoger varias paletas (A: magma, B: inferno, C: plasma, D: viridis, E: cividis, F: rocket, G: mako y H: turbo)ggsci:
scale_color_ con cualquiera de las siguientes opciones: npg, aaas, nejm, simpsons, rickandmorty.Estilos:
theme_bw() por cualquiera de las siguientes opciones theme_gray(), theme_dark(), theme_minimal(), theme_classic()¿Notas algo raro en las facetas?
Para mayor información, puedes revisar la documentación de viridis en este enlace, de ggsci en este enlace y la de los estilos de ggplot2 en este otro enlace.
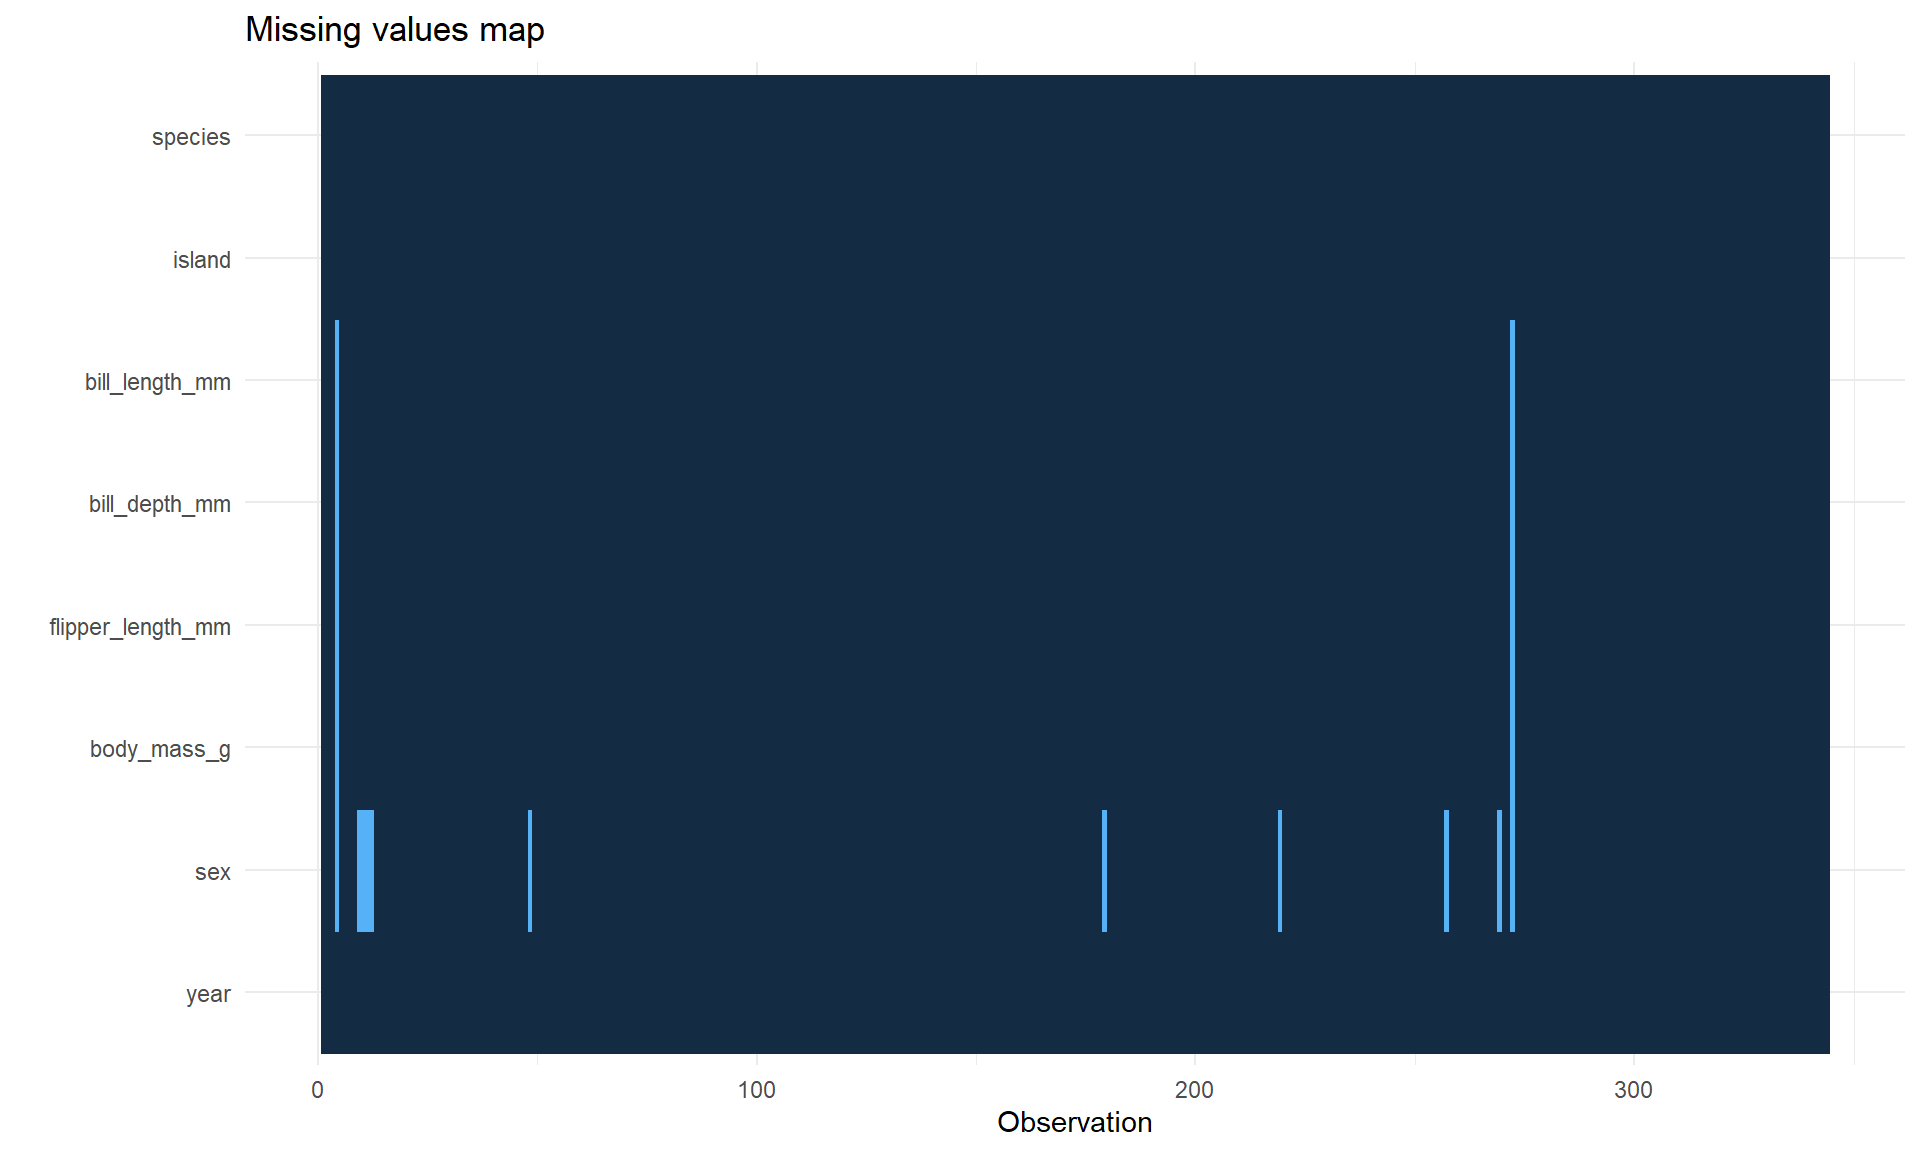
La perdida de datos es común en casi todo experimento, sobre todo en aquellos de naturaleza observacional.
El primer paso que recomiendo en un análisis exploratorio, es checar si existen o no datos perdidos.
Esto por cuanto así se prevee si los métodos de inferencia a usarse necesitan o no ser corregidos.
Únicamente cuando la severidad de la pérdida de datos es muy grande aconsejo a recurrir a estas dos opciones (en orden de complejidad estadística de menor a mayor)
Repetir el experimento
Llevar a cabo imputación de datos
En este curso vamos a limitarnos a usar métodos de análisis corregidos cuando estemos ante la presencia de datos perdidos ya que la imputación de datos requiere de conocimientos teóricos extensos acerca de los tipos de mecanismos de pérdida de datos.
EVITAR el reemplazar los valores perdidos por ceros. Esta suele ser una práctica más o menos común pero que introduce mayores problemas que los que “soluciona”.
En resumen, no hay que temer el contar con datos perdidos, siempre y cuando estos no sean masivos.
$Continuous
label var_type n missing_n missing_percent
bill_length_mm bill_length_mm <dbl> 342 2 0.6
bill_depth_mm bill_depth_mm <dbl> 342 2 0.6
flipper_length_mm flipper_length_mm <int> 342 2 0.6
body_mass_g body_mass_g <int> 342 2 0.6
year year <int> 344 0 0.0
mean sd min quartile_25 median quartile_75 max
bill_length_mm 43.9 5.5 32.1 39.2 44.5 48.5 59.6
bill_depth_mm 17.2 2.0 13.1 15.6 17.3 18.7 21.5
flipper_length_mm 200.9 14.1 172.0 190.0 197.0 213.0 231.0
body_mass_g 4201.8 802.0 2700.0 3550.0 4050.0 4750.0 6300.0
year 2008.0 0.8 2007.0 2007.0 2008.0 2009.0 2009.0
$Categorical
label var_type n missing_n missing_percent levels_n
species species <fct> 344 0 0.0 3
island island <fct> 344 0 0.0 3
sex sex <fct> 333 11 3.2 2
levels levels_count levels_percent
species "Adelie", "Chinstrap", "Gentoo" 152, 68, 124 44, 20, 36
island "Biscoe", "Dream", "Torgersen" 168, 124, 52 49, 36, 15
sex "female", "male", "(Missing)" 165, 168, 11 48.0, 48.8, 3.2
sub_penguins <- na.omit(penguins)
ggplot(sub_penguins,
aes(x = flipper_length_mm, y = body_mass_g, colour = species)) +
geom_point(alpha = 0.7,
size = 3) +
geom_smooth(method = "lm") +
scale_x_continuous(breaks = seq(150, 250, 10)) +
scale_y_continuous(breaks = seq(2500, 7000, 500)) +
scale_color_viridis(discrete = T) +
facet_wrap(~sex) +
labs(title = "Largo de aleta vs. peso",
subtitle = "Pingüinos de Palmer",
caption = "Gráfica propia",
x = "Largo de aleta",
y = "Peso",
color = "Especie") +
theme_bw()
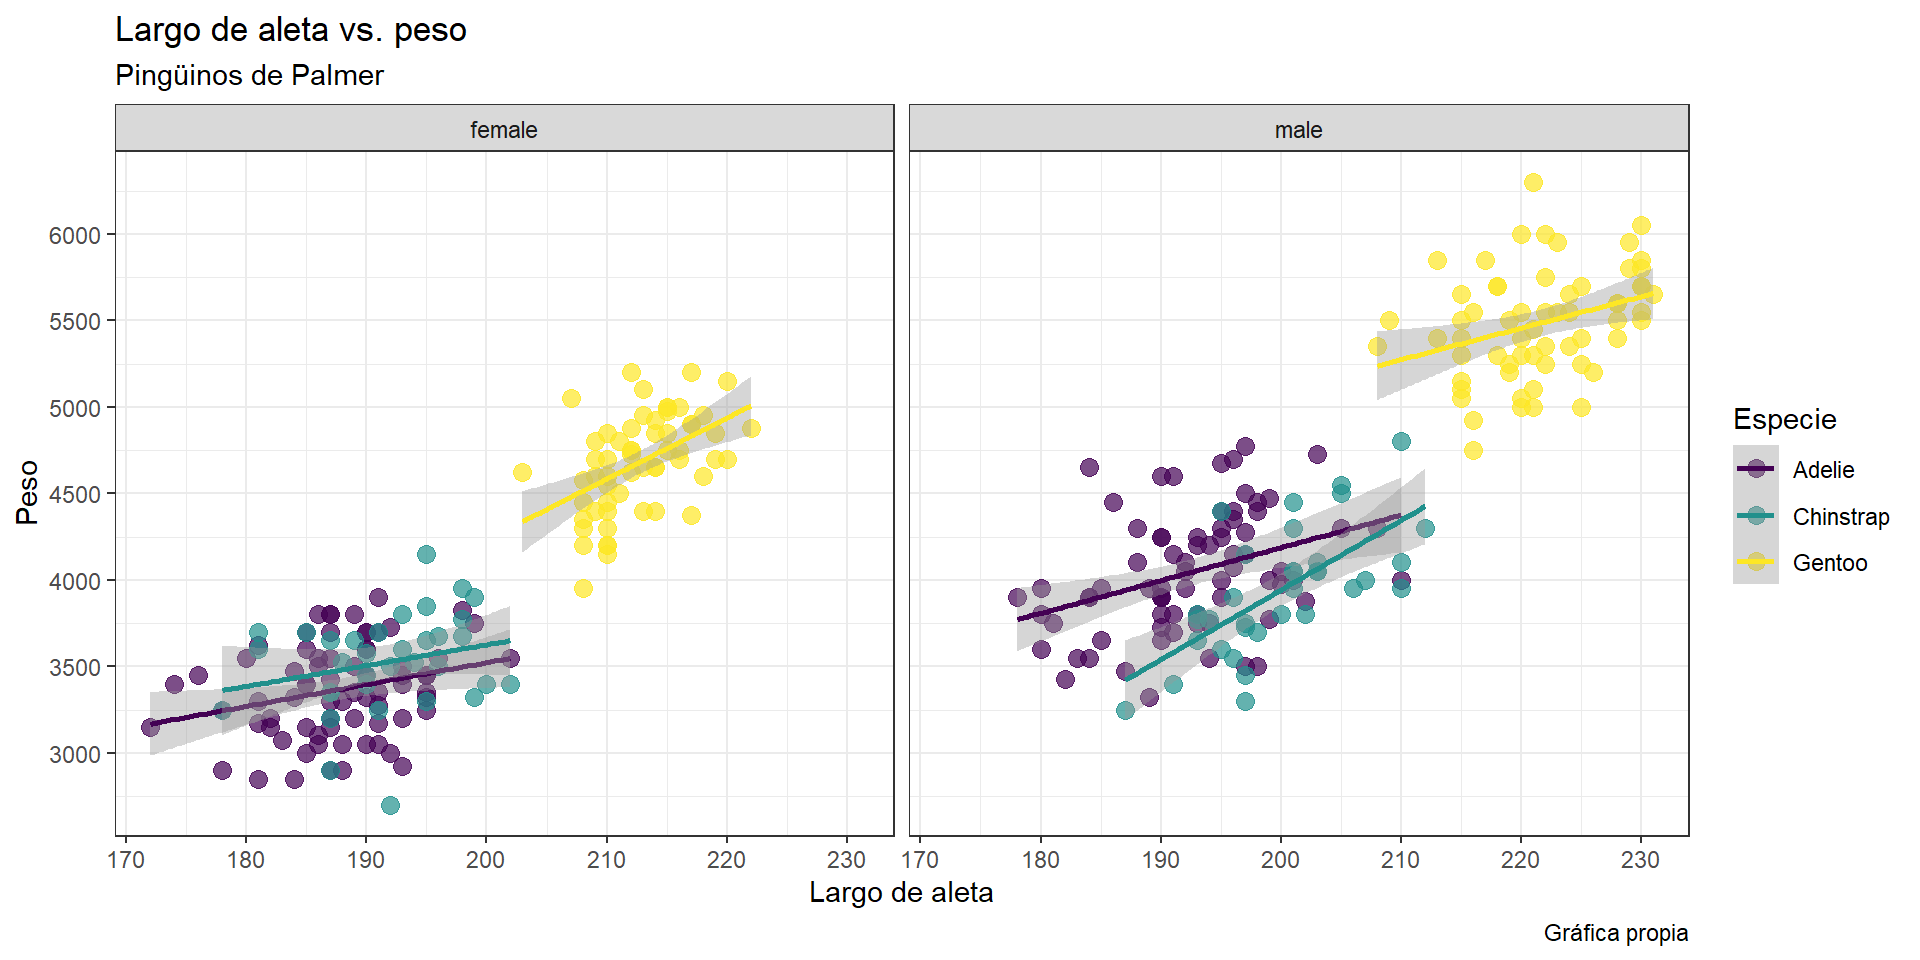
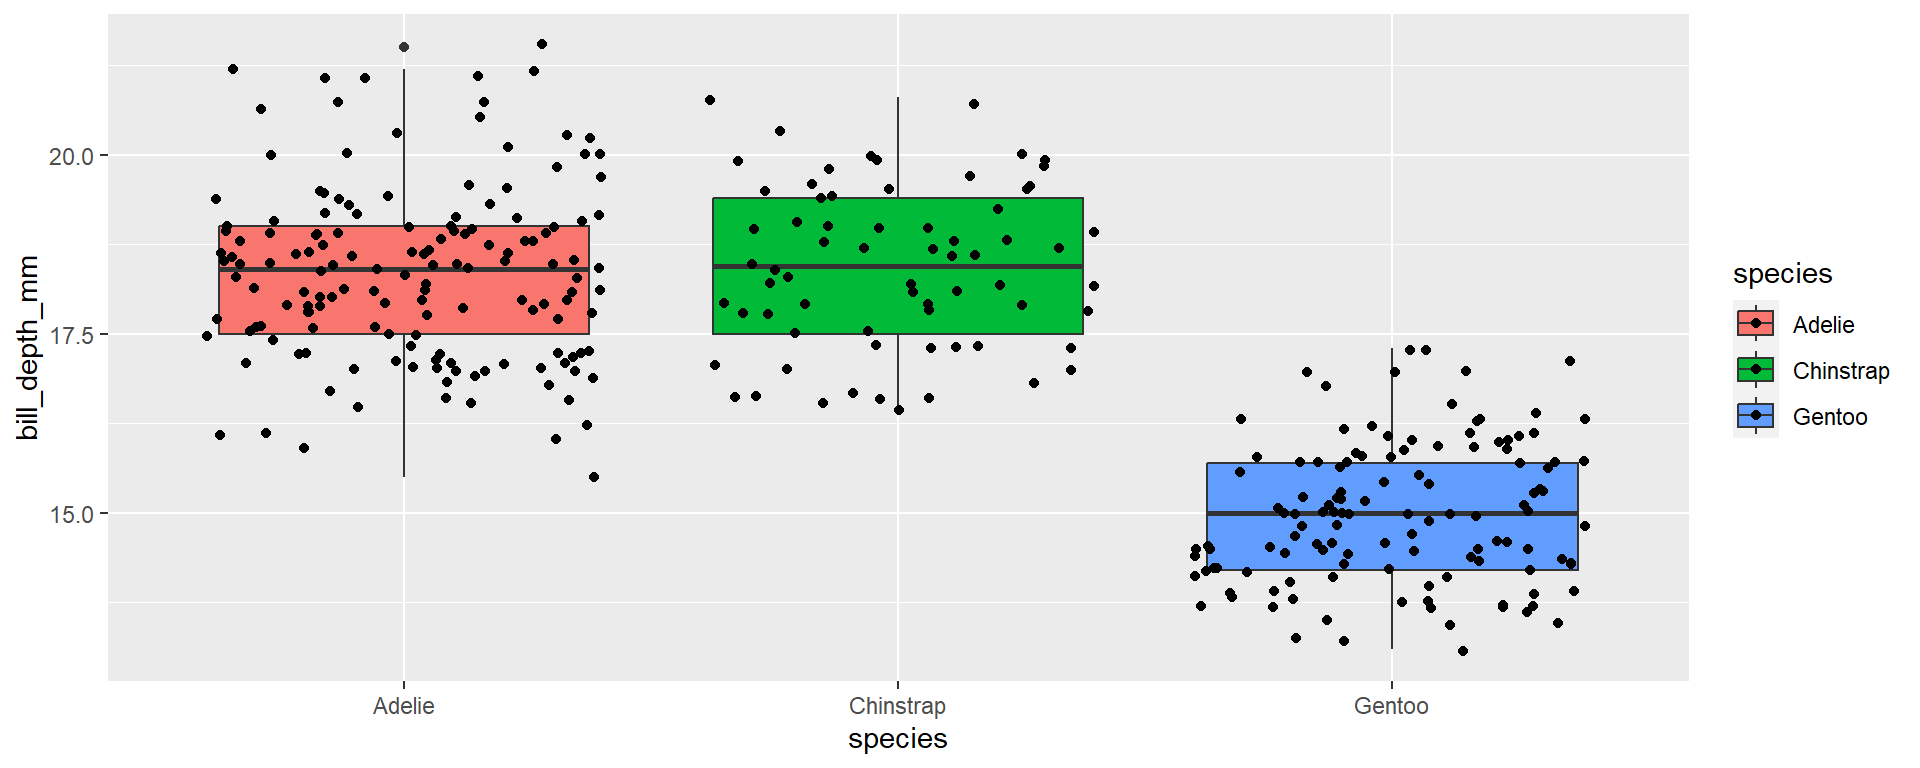
Un outlier puede definirse como aquella observación que dista considerablemente de la mediana de una población.
Pueden deberse a errores en la toma de mediciones o valores que realmente existen.
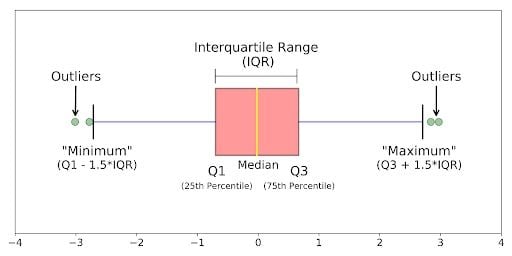
En estadística, un outlier es definido de acuerdo al criterio del Rango Intercuartílico (RIC o IQR en inglés).
Este criterio establece que toda observación por encima del tercer cuartil + 1.5 veces el RIC o por debajo del primer cuartil - 1.5 veces el RIC es considerada como outlier.
\[ I=\left[C_{0.25}-1.5 \times RIC ,\,C_{0.75}+1.5 \times RIC \right] \]
Donde el RIC es sencillamente la diferencia entre el primer y el tercer cuartil de una muestra.
Este método es precisamente la base para los gráficos de caja y bigote.
Imagen de autoría de Michael Galarnyk
Los gráficos base de R son de rápida implementación.
Generalmente los uso para dar vistazos rápidos a los datos.
Pueden por supuesto ser usados para productos finales de publicación, pero la sintaxis para dar formato y exportarlos es un tanto confusa (a mi parecer).
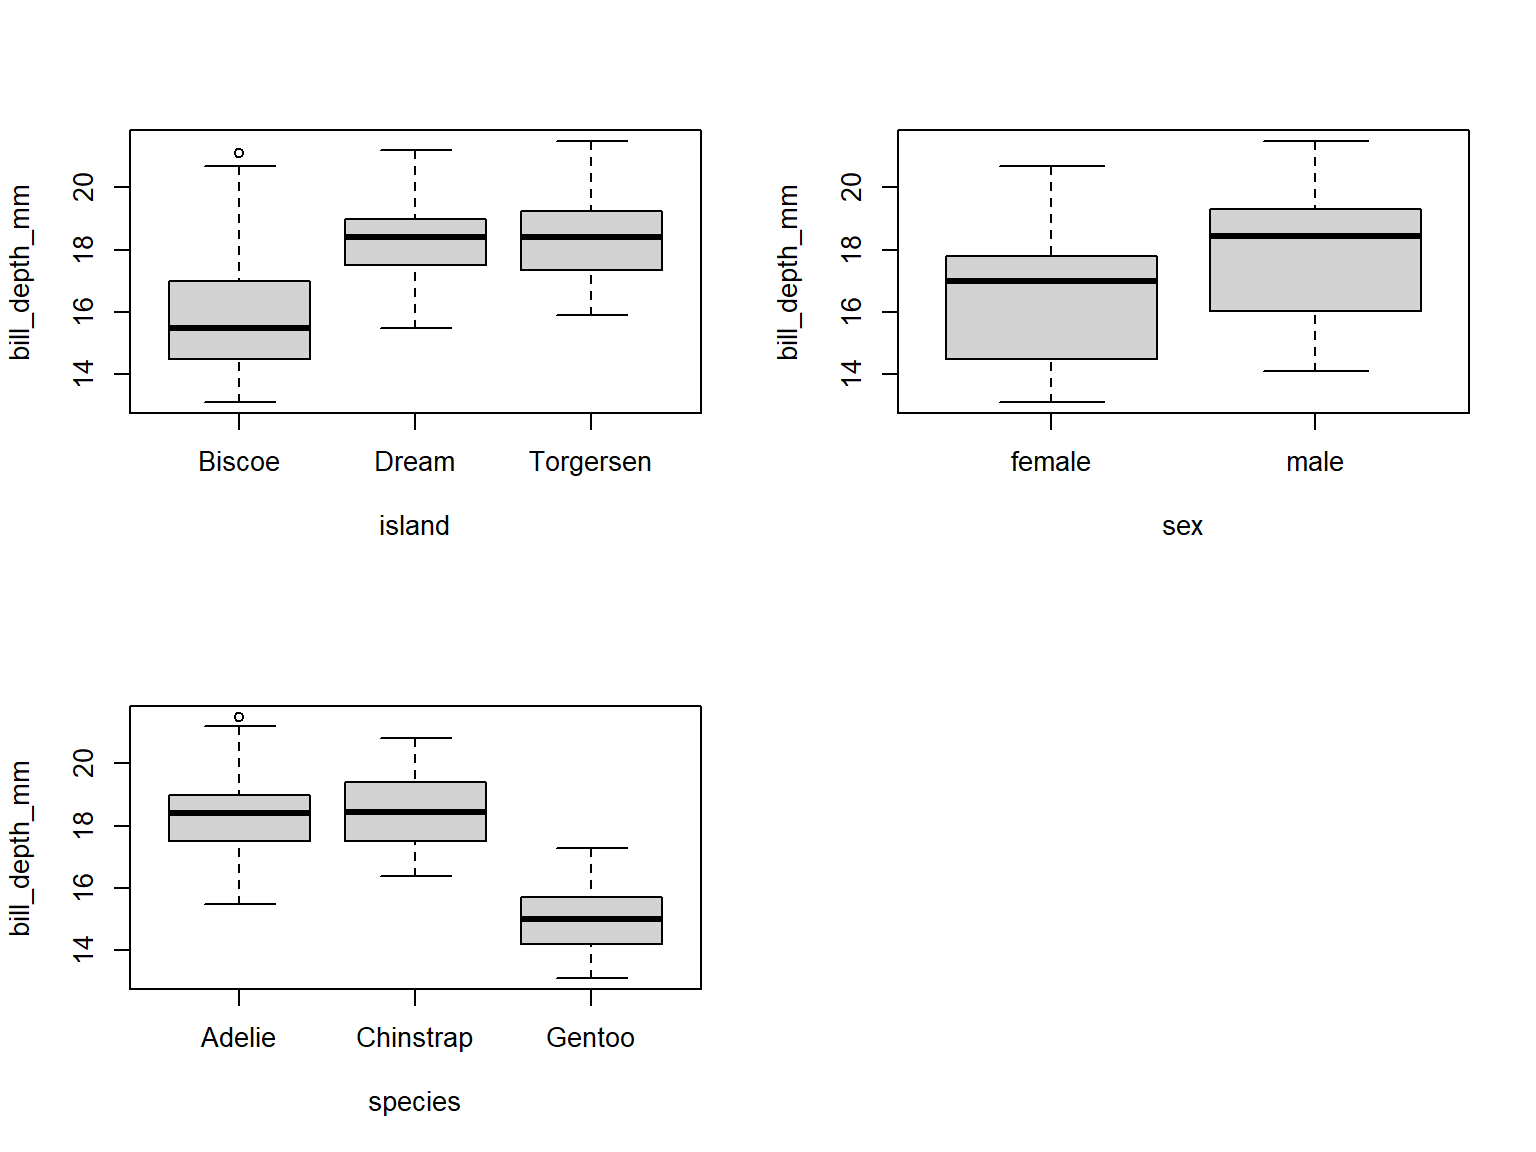
Tienen sus limitaciones, ¿qué tal si en este caso me hubiese gustado realizar un gráfico por facetas para ver más variables categóricas al mismo tiempo?
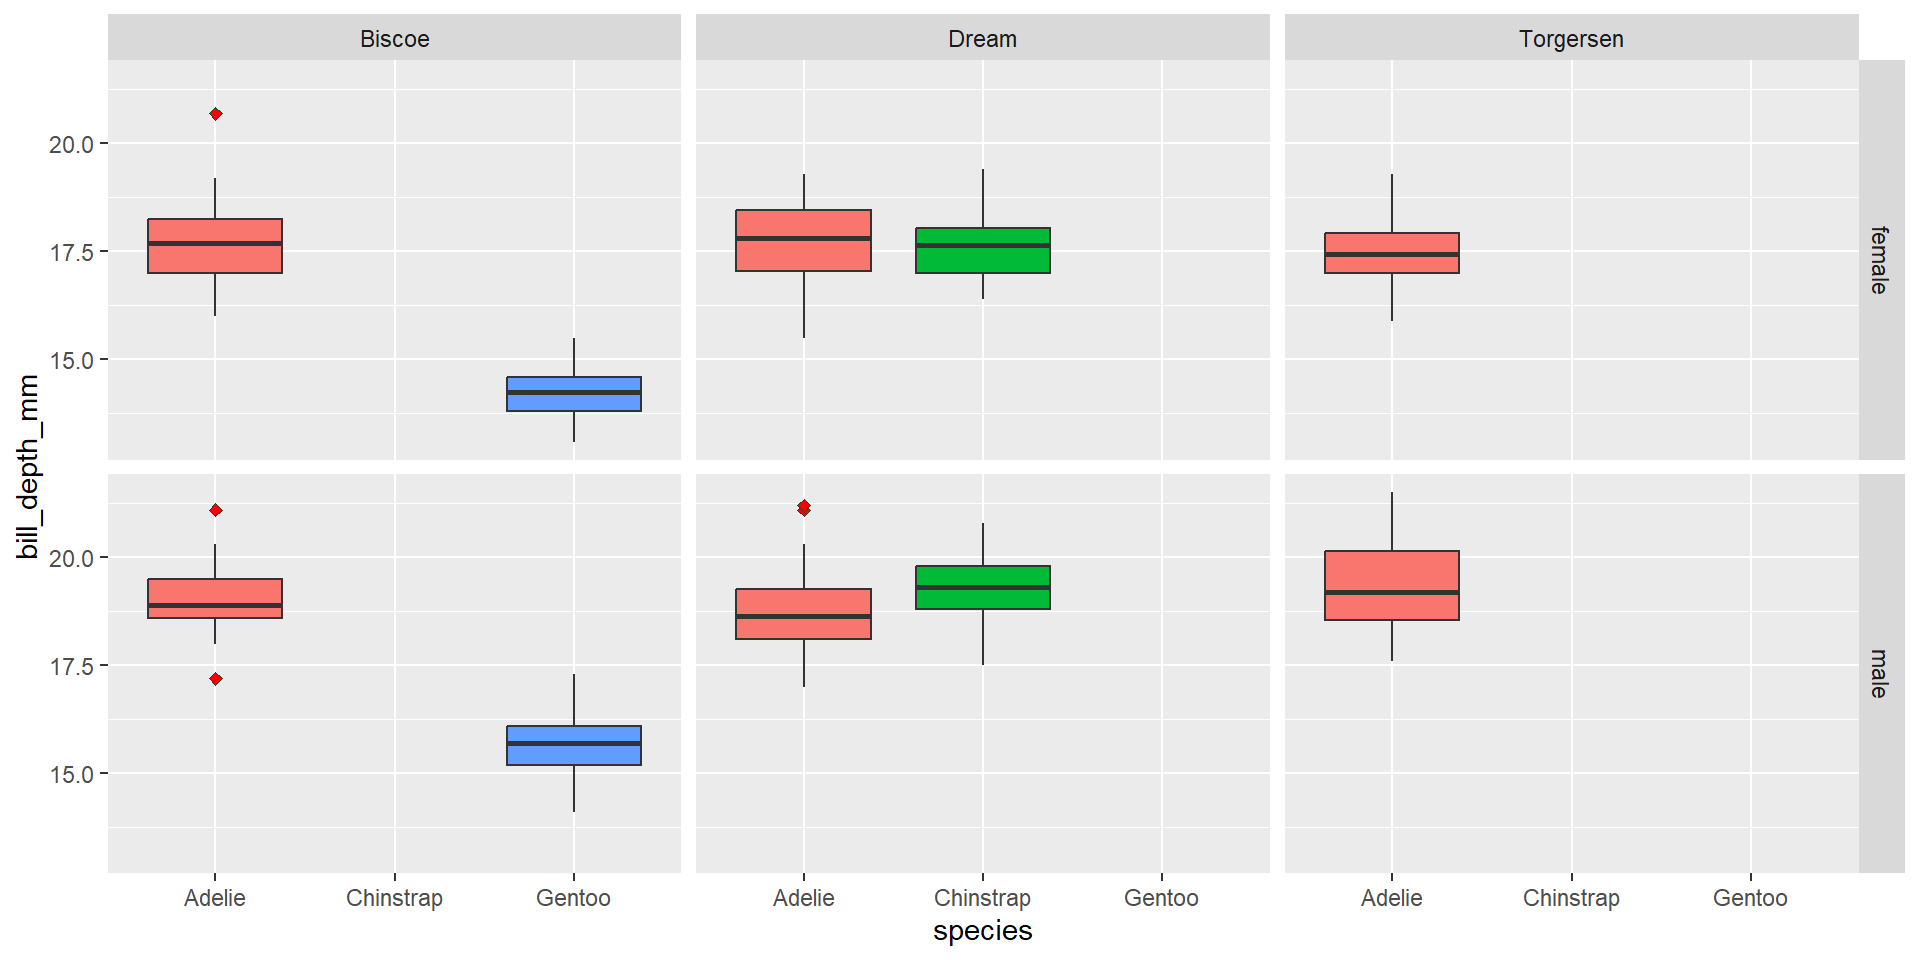
ggplot2Usando como base el código del ejemplo anterior, realiza un gráfico de facetas con la variable body_mass_g. Mira si existen o no outliers. ¿Crees conveniente removerlos?
El remover outliers no se aconseja antes de llevar a cabo análisis de inferencia estadística.
Para remover outliers antes de analizar propiamente los datos, se necesita tener certeza de las razones por las cuales estos fueron registrados:
Fallas comprobadas en el equipo de medición
Errores al escribir las mediciones en el medio de registro (libro de laboratorio, base de datos)
Falencias en las técnicas, metodologías o materiales que ayudaron en la toma de las observaciones (reactivos expirados, protocolos mal interpretados o descontinuados)
Si las anteriores no se cumplen, tener respaldo bibliográfico o experiencia de que el valor del outlier es improbable en la población sujeto de estudio.
Muchas veces, los aparentes outliers no tienen mayor efecto en las inferencias que se realicen. Y en los casos extremos de considerar su remoción, se puede recurrir a transformaciones de los datos. En otras palabras, el último recurso es removerlos.
Cuando llegado el caso, no existe otra opción, debería ser una obligación el reportar las razones para no considerarlos en el análisis (integridad científica).
La respuesta más simple: borrarlos de la base de datos antes de cargarla en R.
Sin embargo, a veces trabajamos con tablas de datos extensas, y la remoción manual puede ser larga, tediosa y sujeta a errores que podrían empeorar la situación.
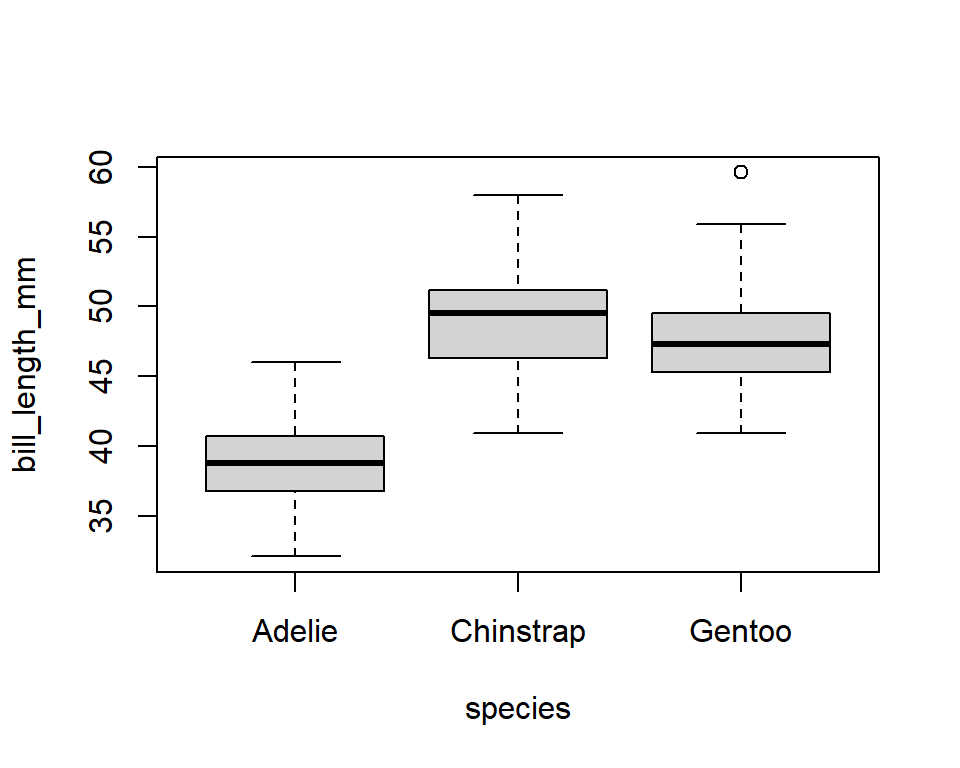
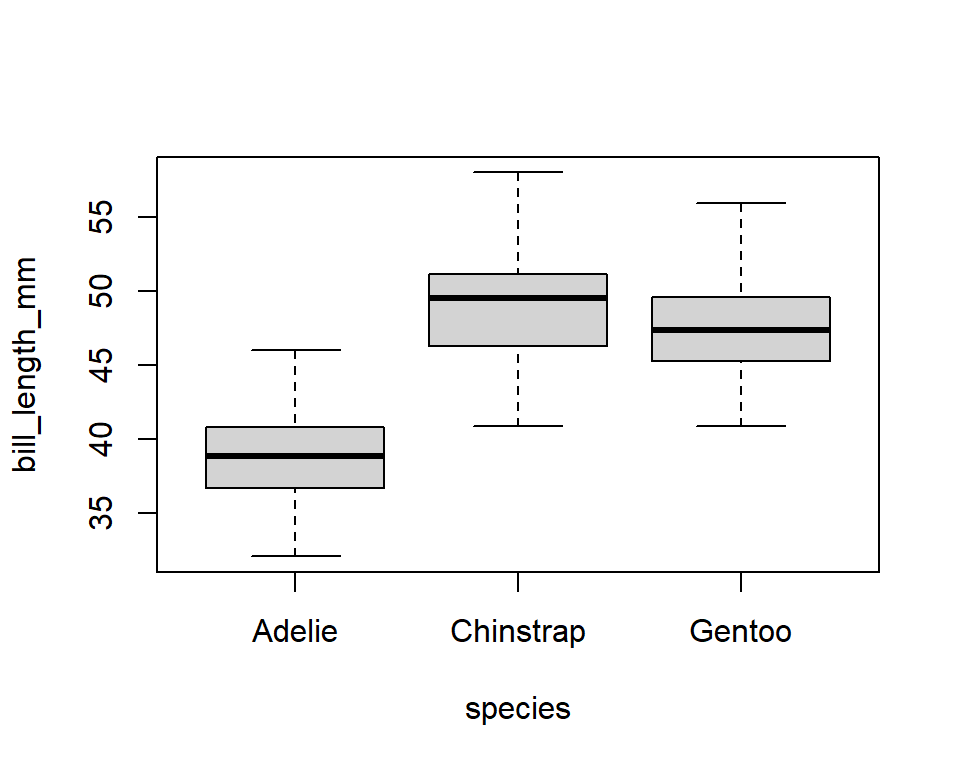
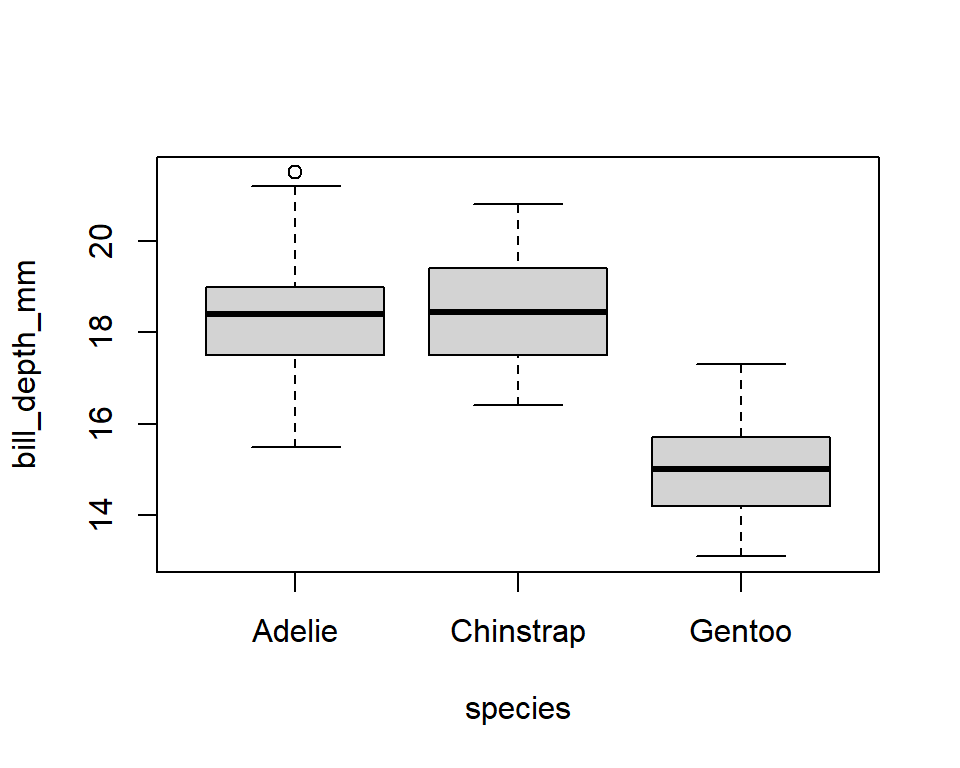
Para ilustrar cómo hacerlo en R, vamos a recurrir a un ejemplo más sencillo donde solo lidiemos con una variable categórica a la vez. Así, veamos únicamente al caso de las variables bill_length_mm y species
Remueve el outlier en el boxplot que se visualiza en la siguiente línea de código de R
Los datos del archivo de excel “rotXLS.xlsx” que mencionamos brevemente en el primer módulo contiene información sobre el conteo de casos de rotavirus en Berlín desde el año 2001 hasta el 2020. Las variables de esta tabla de datos son:
date: fecha de cierre de la toma de datos
cases: número de casos de rotavirus en la semana
week: semana epidemiológica
incidence: número de casos/100000 habitantes
FM: media diaria de velocidad del viento (m/s)
RSK: media diaria de lluvia (mm)
SHK_TAG: media diaria de nieve (cm)
PM: media diaria de presión atmosférica (hPa)
TMK: media diaria de temperatura (°C)
TXK: media diaria de temperatura máxima (°C)
TNK: media diaria de temperatura mínima (°C)
UPM: media diaria de humedad relativa (%)
Crea un boxplot del número de casos con respecto a las semanas epidemiológicas con ggplot2 y gráficos base de R
Remueve los outliers
(Tip: convierte las semanas a factor: rot_berlin$cases <- as.factor(rot_berlin$cases)
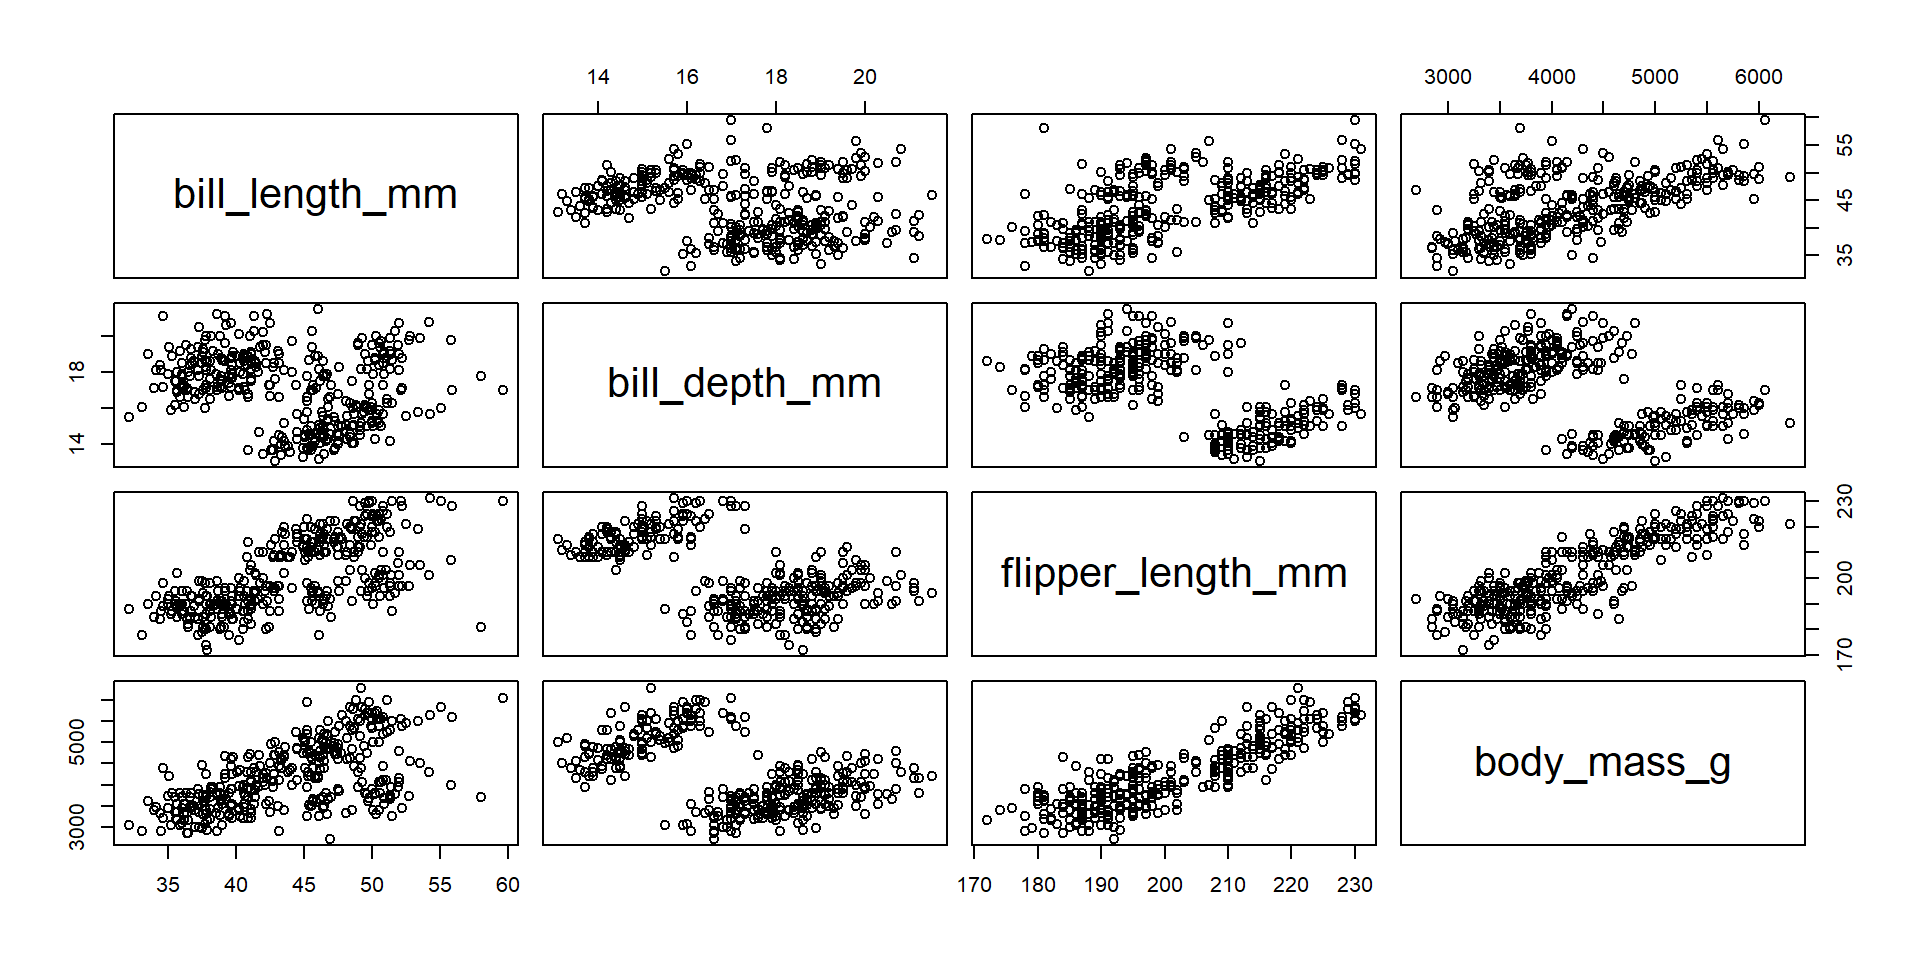
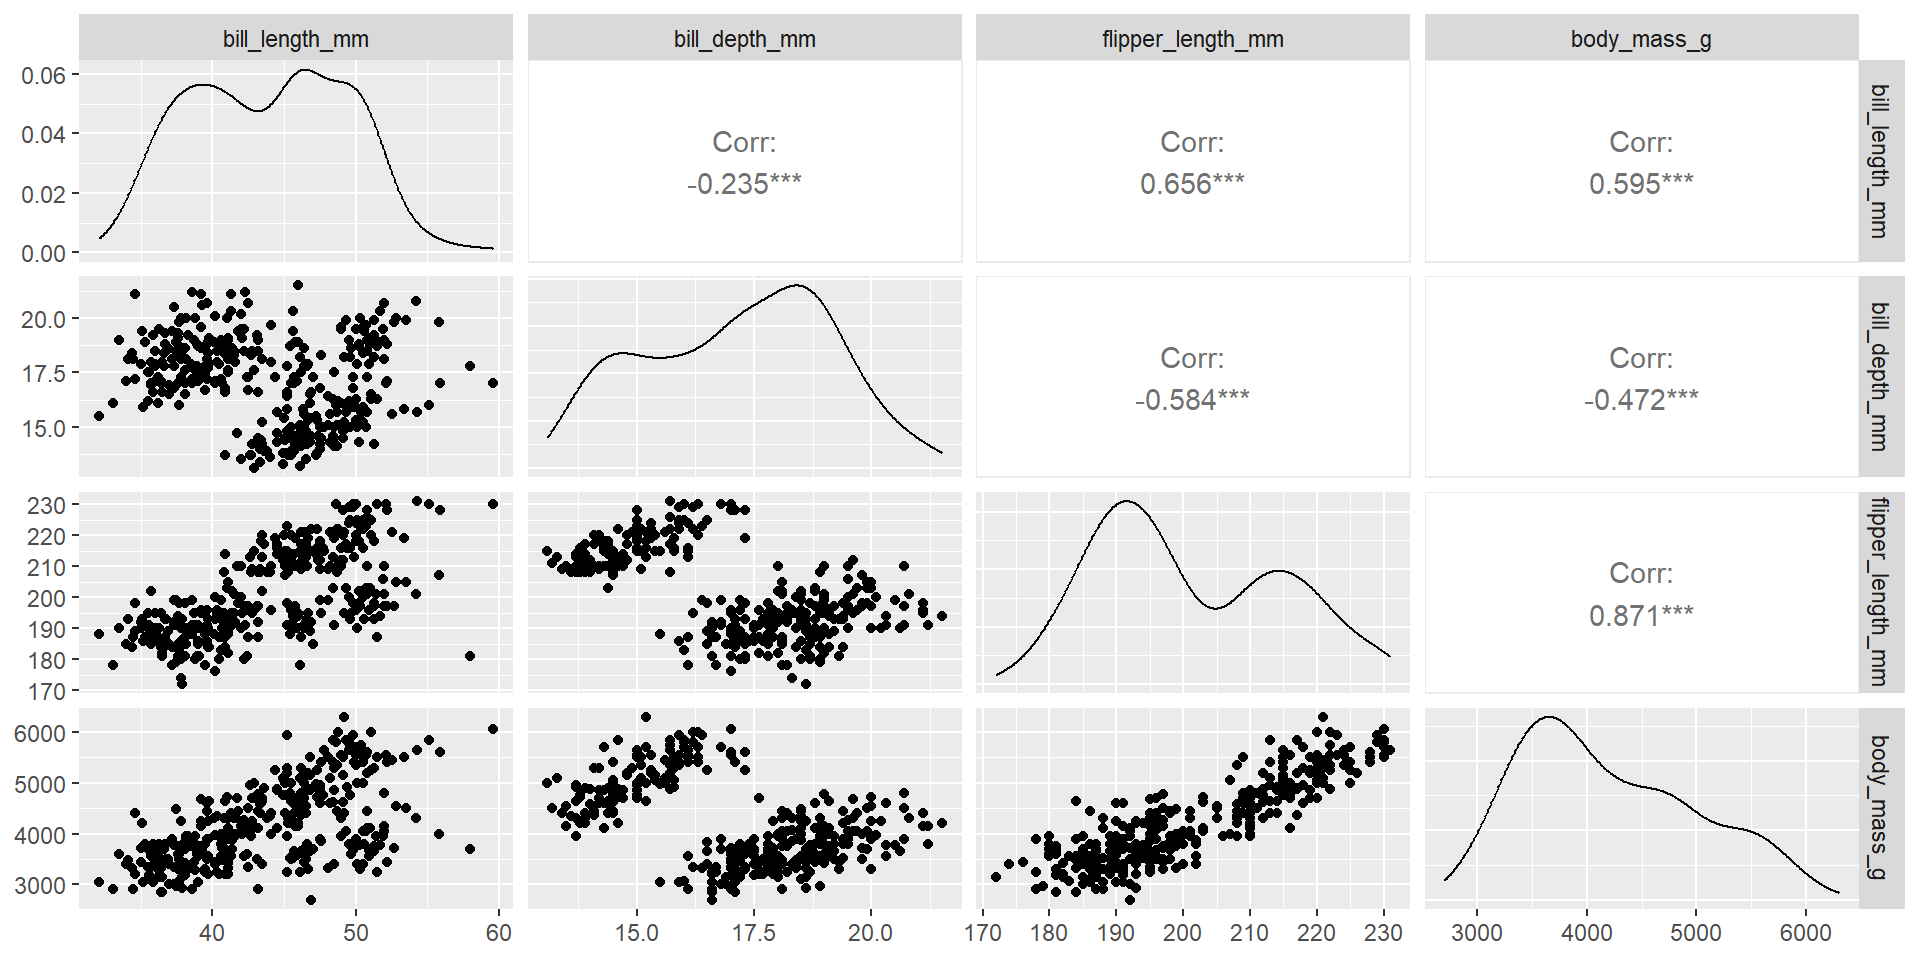
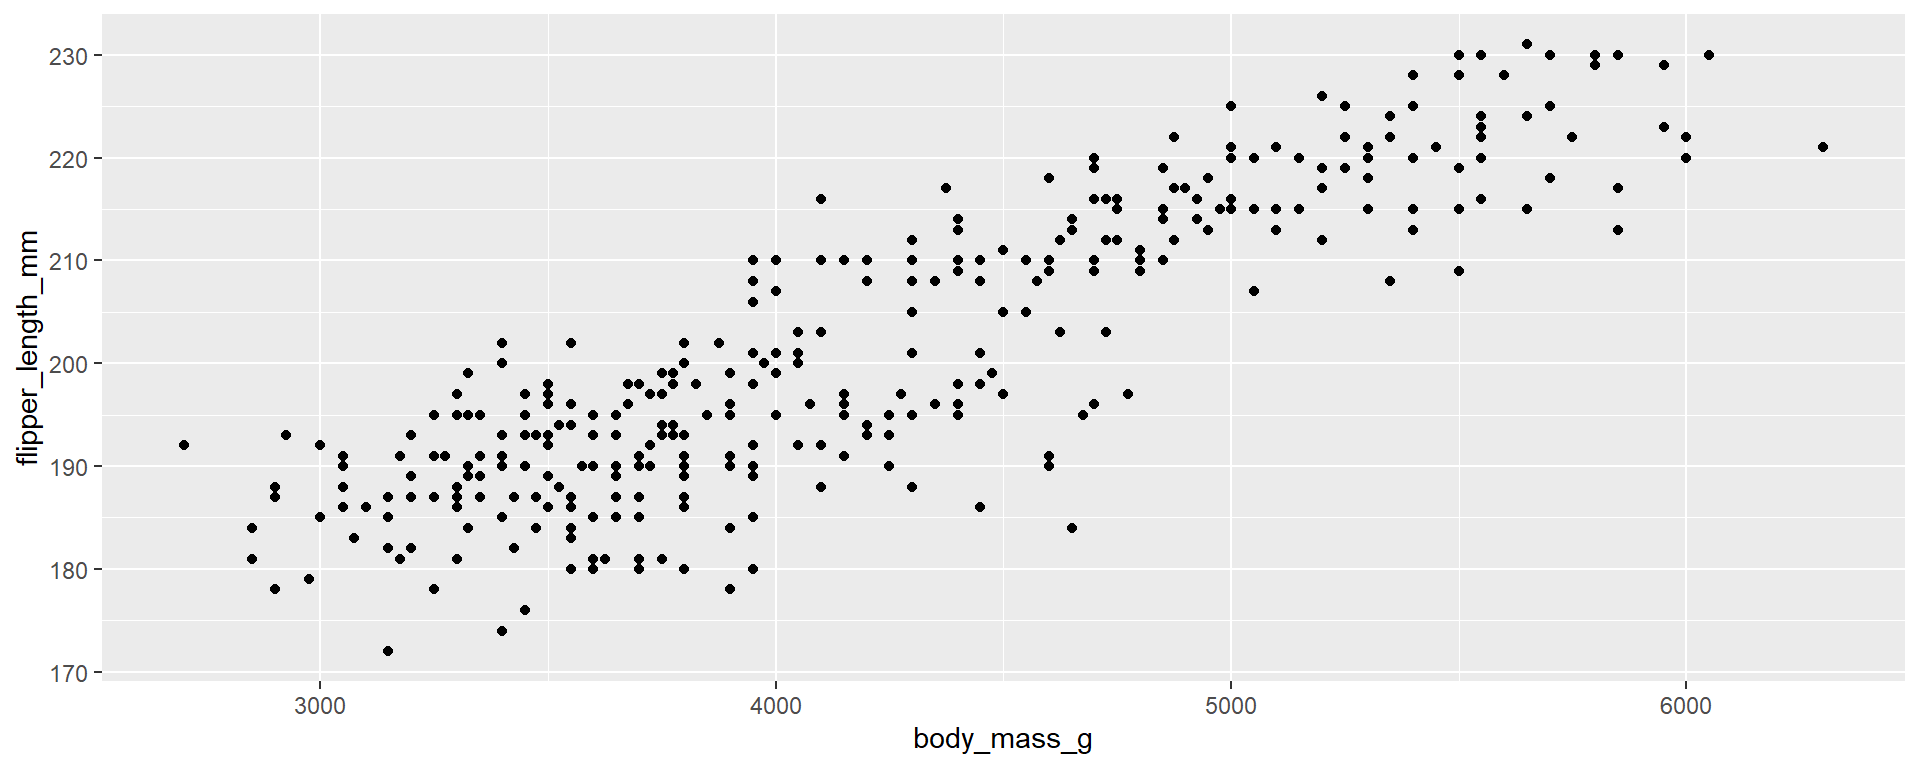
El dar un vistazo a relaciones lineales entre variables continuas también nos puede dar una idea de la presencia de outliers.
Adicionalmente, nos permite visualizar arreglos/patrones en los datos que responden a la influencia de variables de agrupación (en el ejemplo de los pingüinos ya vimos que las especies y las islas determinan algún tipo de arreglo).
También nos dan una idea de las correlaciones entre las variables. Esto es de mayor importancia en los casos que tenemos en mente llevar a cabo análisis multivariables.
Por ejemplo, en análisis de covarianza (cuando una o más variables explanatorias son continuas), no tiene sentido el incluir variables altamente correlacionadas entre sí.
Para esto, la forma más sencilla es llevar a cabo gráficos de dispersión para tantos pares posibles de combinaciones de variables continuas tengamos.
Esto obviamente sería tedioso y propenso a errores si lo llevamos a cabo de manera manual.
Afortunadamente R nos ofrece varias formas de llevar a cabo matrices de gráficos de dispersión
ggplot2Realiza una matriz de dispersión usando los datos de casos de rotavirus en Berlín. Deja fuera de la matriz las variables date, incidence y week. ¿Cuáles variables crees que serían mejores para una inferencia estadística acerca de la relación clima-casos de rotavirus?
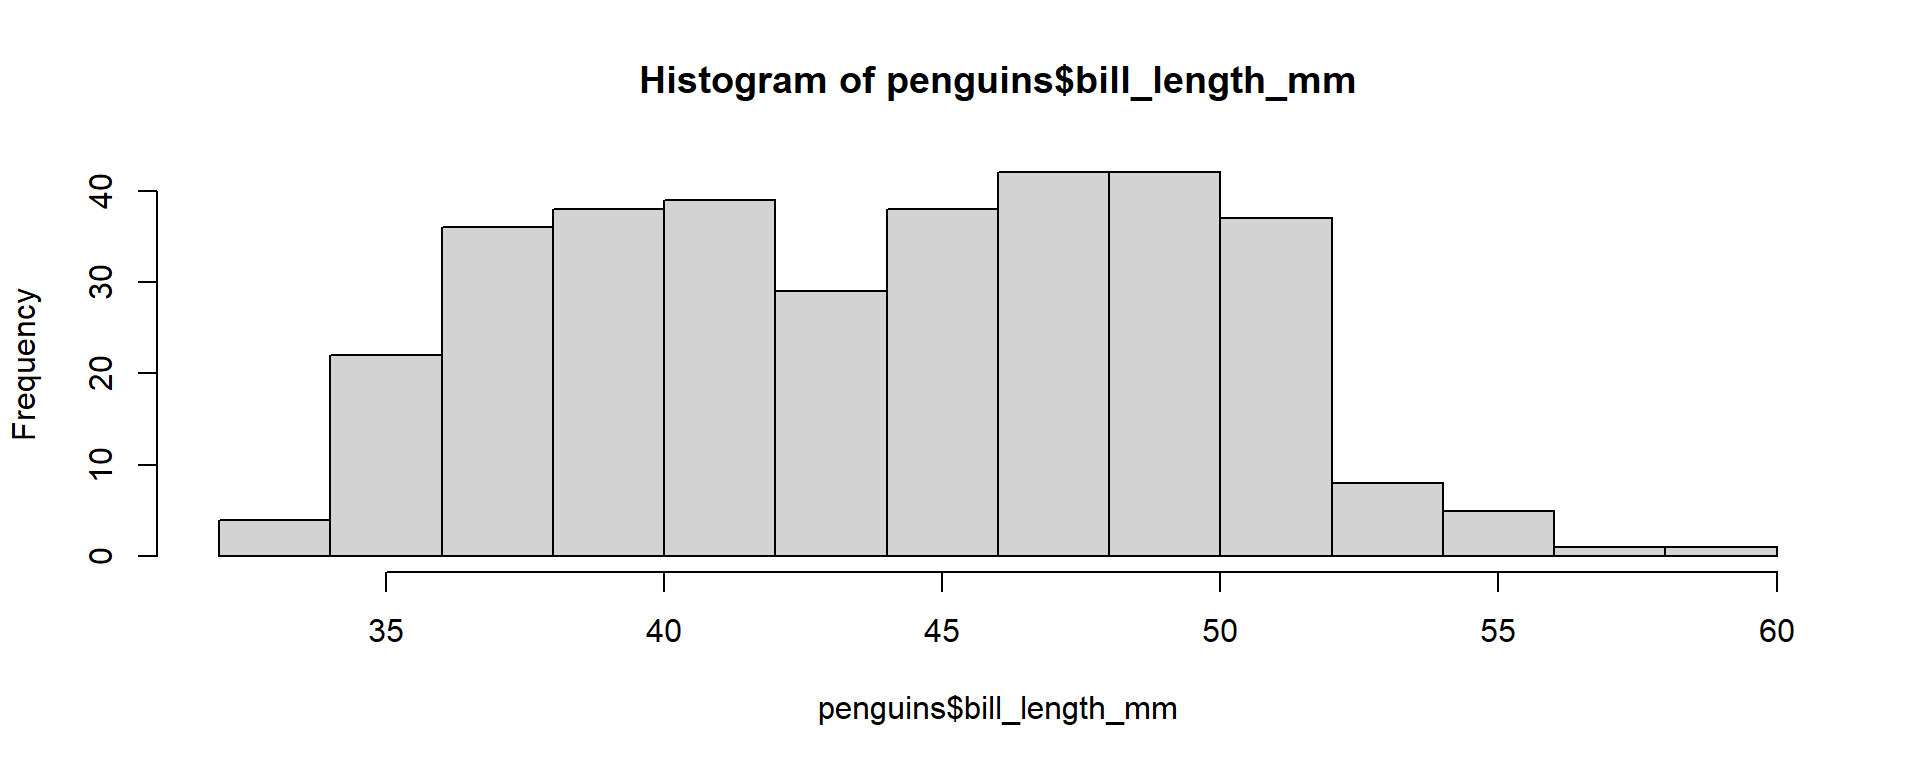
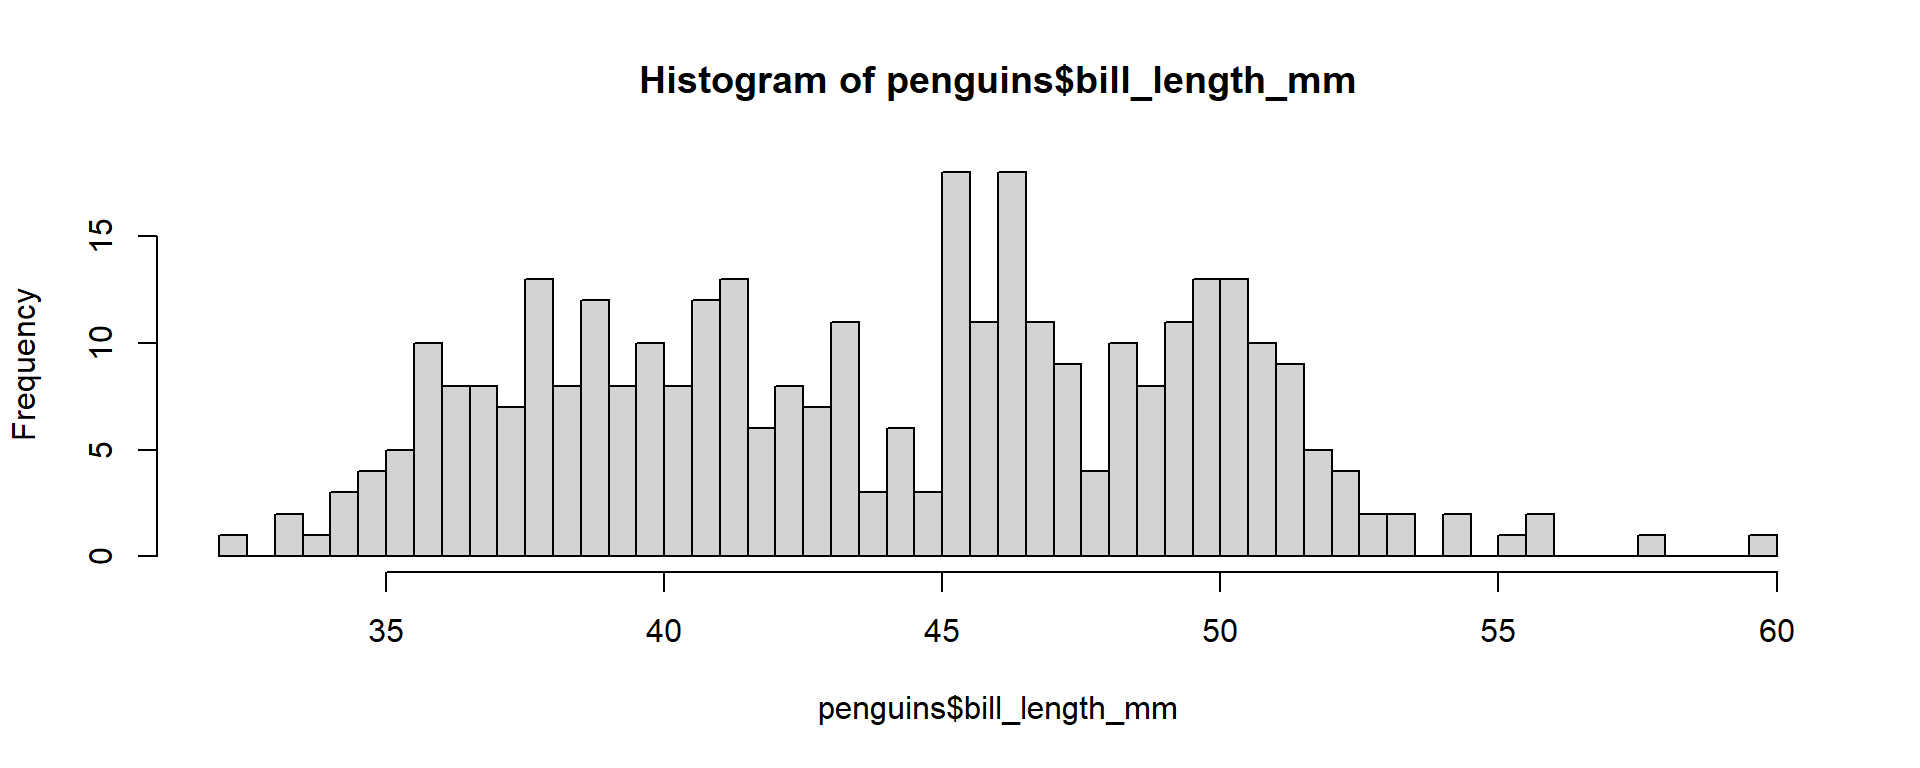
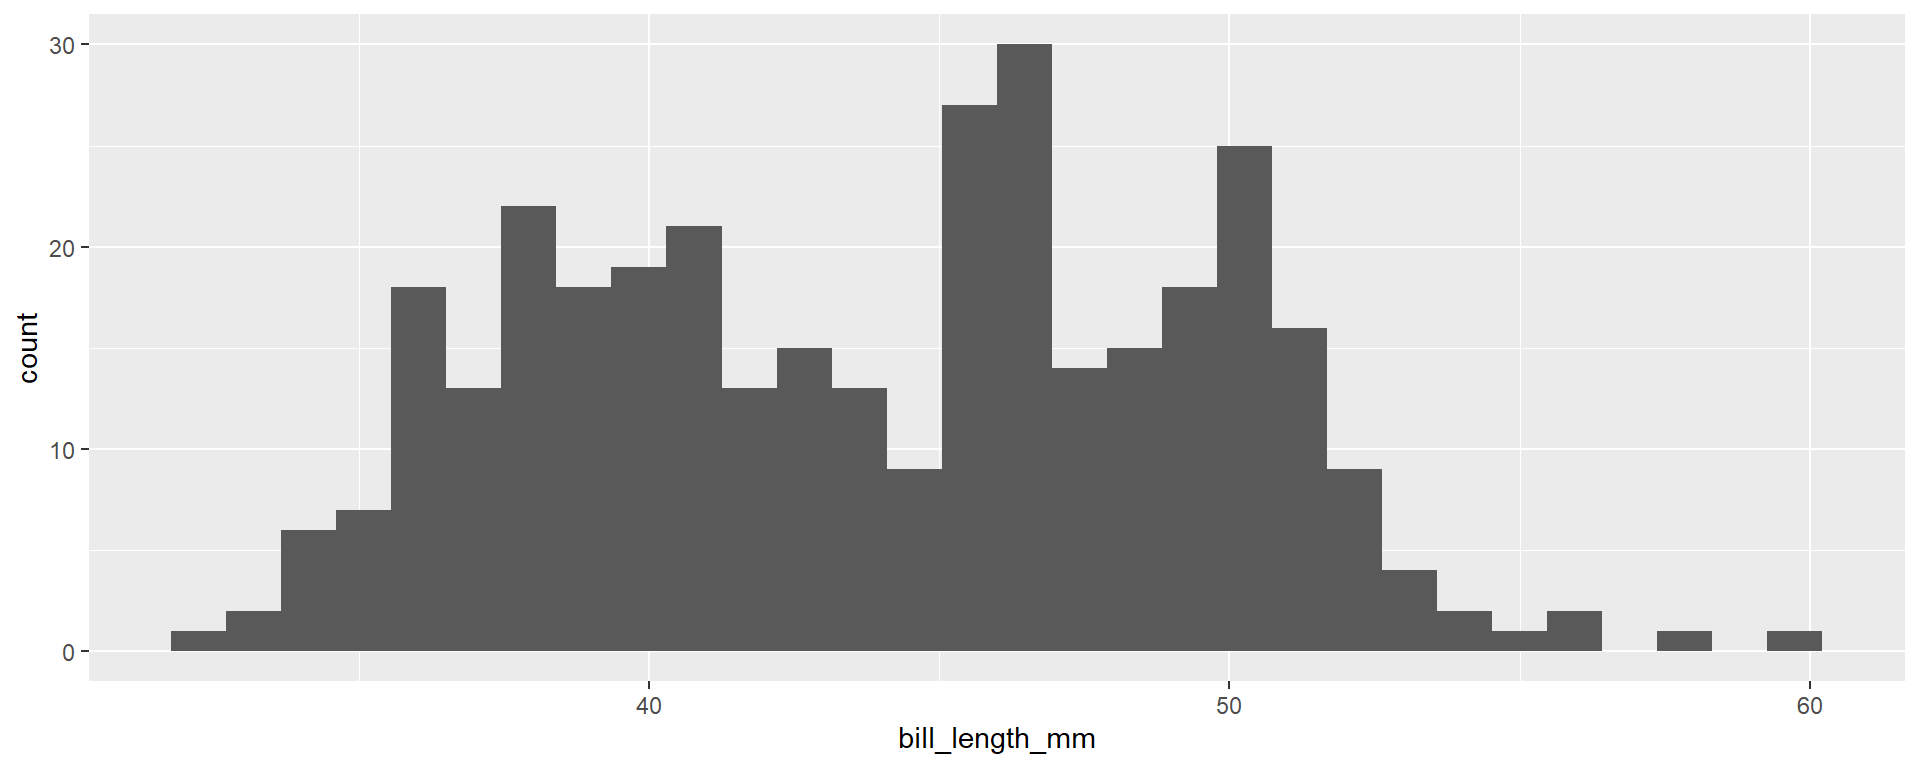
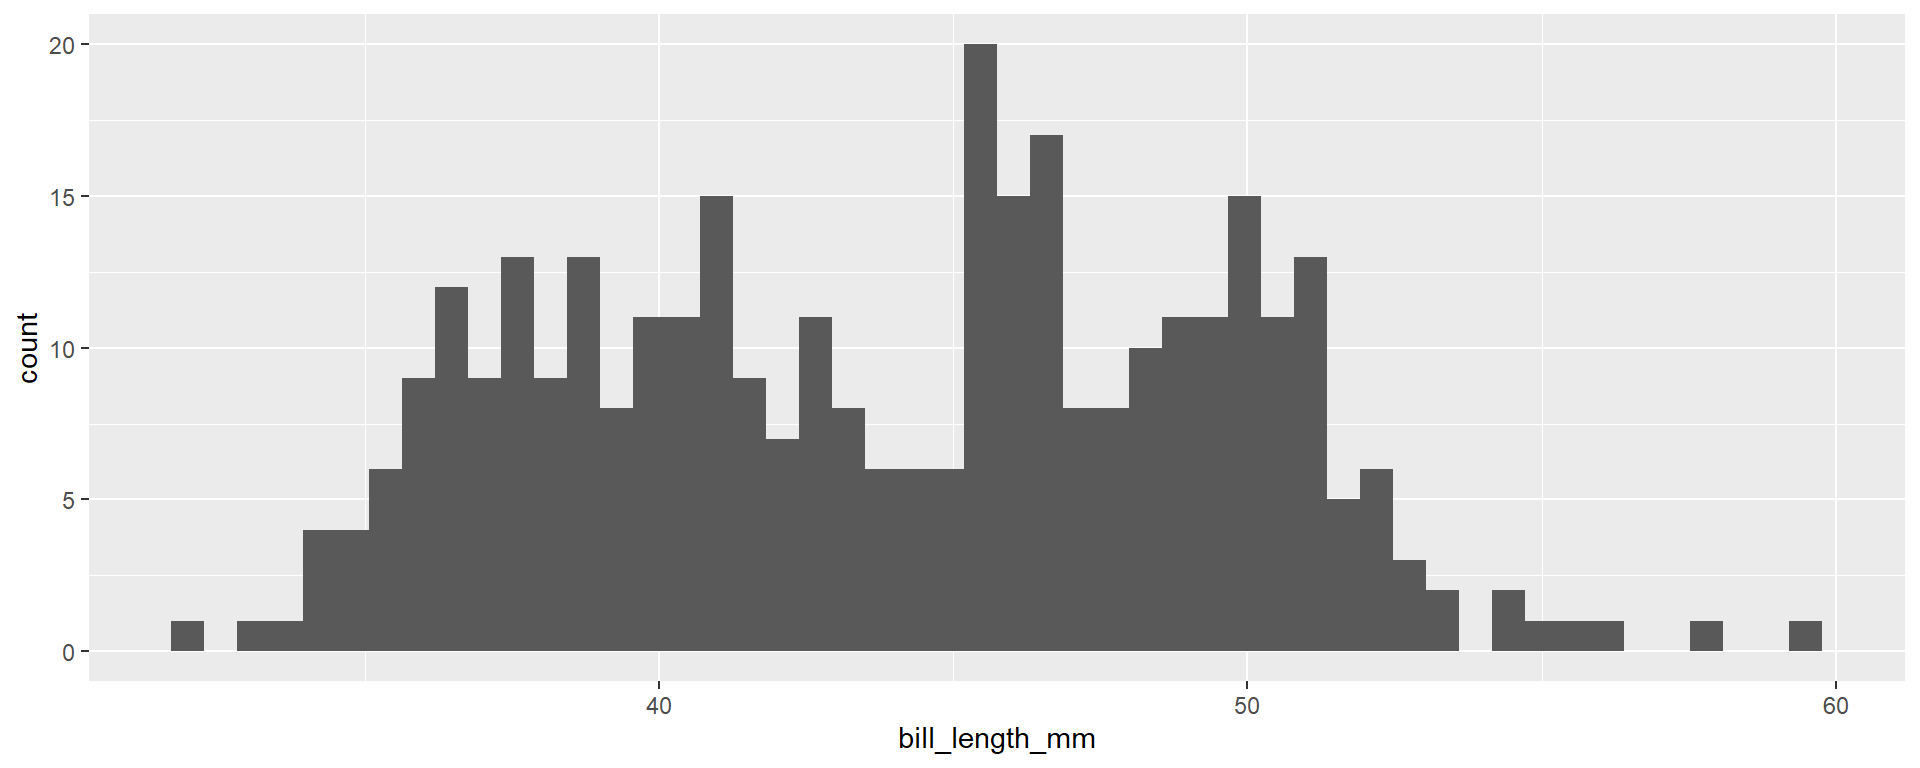
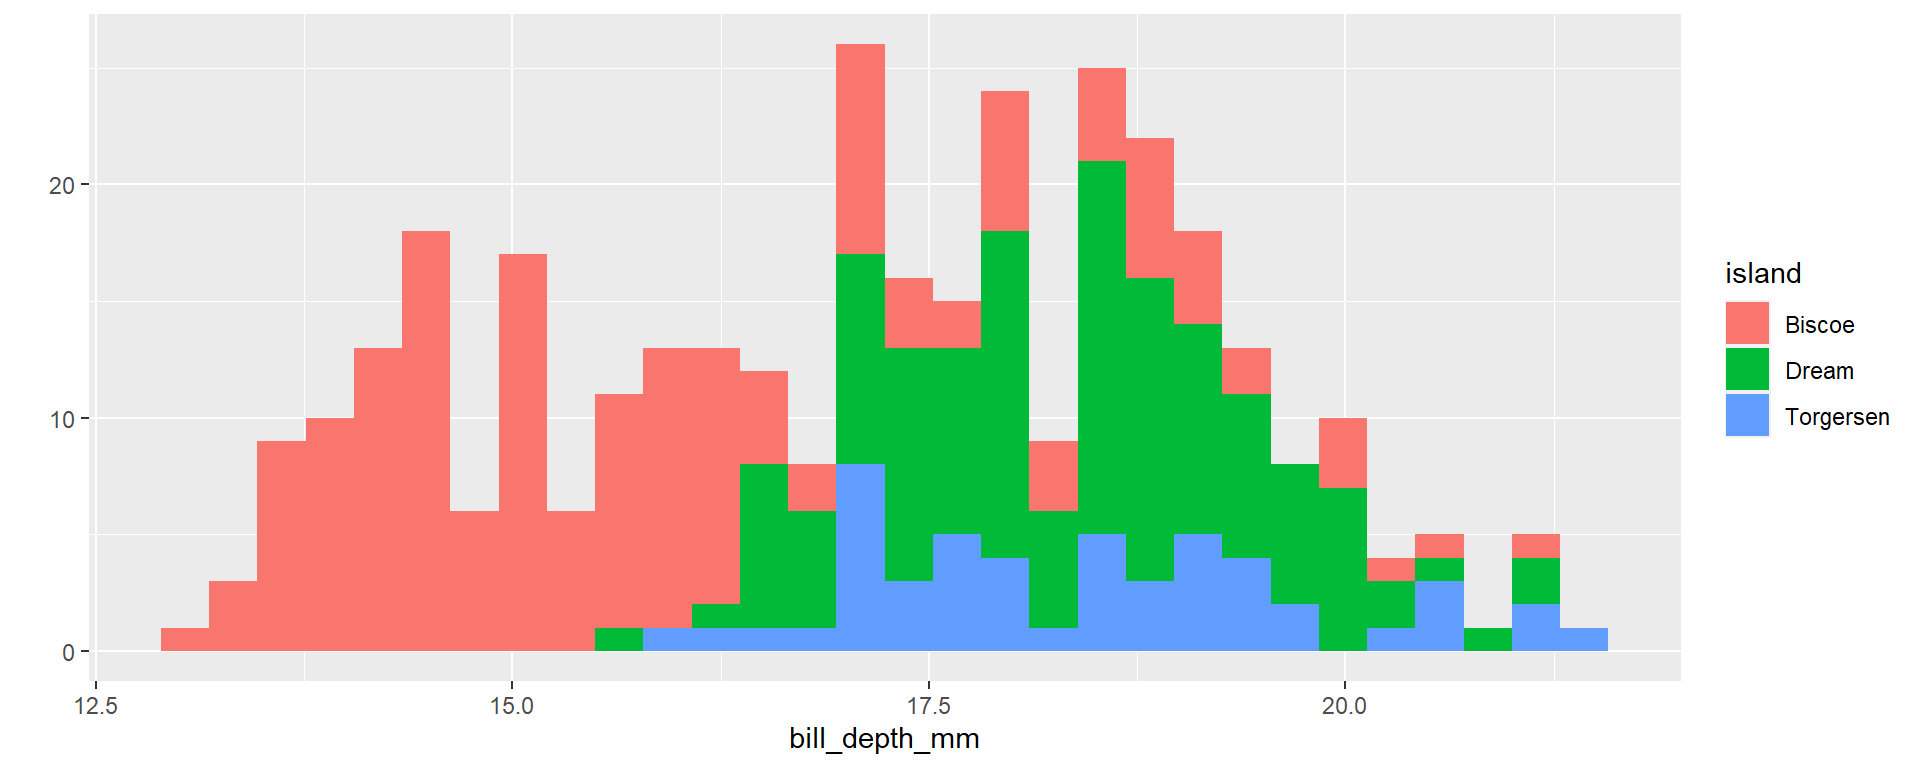
Un histograma es un gráfico estadístico que divide una variable continua en un determinado número de rangos y luego cuenta el número de veces que los datos caen en cada uno de ellos para producir una barra por rango.
Sirve como un diagnóstico de la distribución de una muestra.
Desde la perspectiva del AED, nos da una idea visual de si las variables se alejan de la normalidad.
Esto último podría dar indicaciones de si es necesaria una transformación.
¡Pero!… no es recomendable empezar transformando variables directamente hasta no conducir un análisis formal.
ggplot2Realiza histogramas para todas las variables de la tabla de datos del rotavirus con la excepción de date y week.
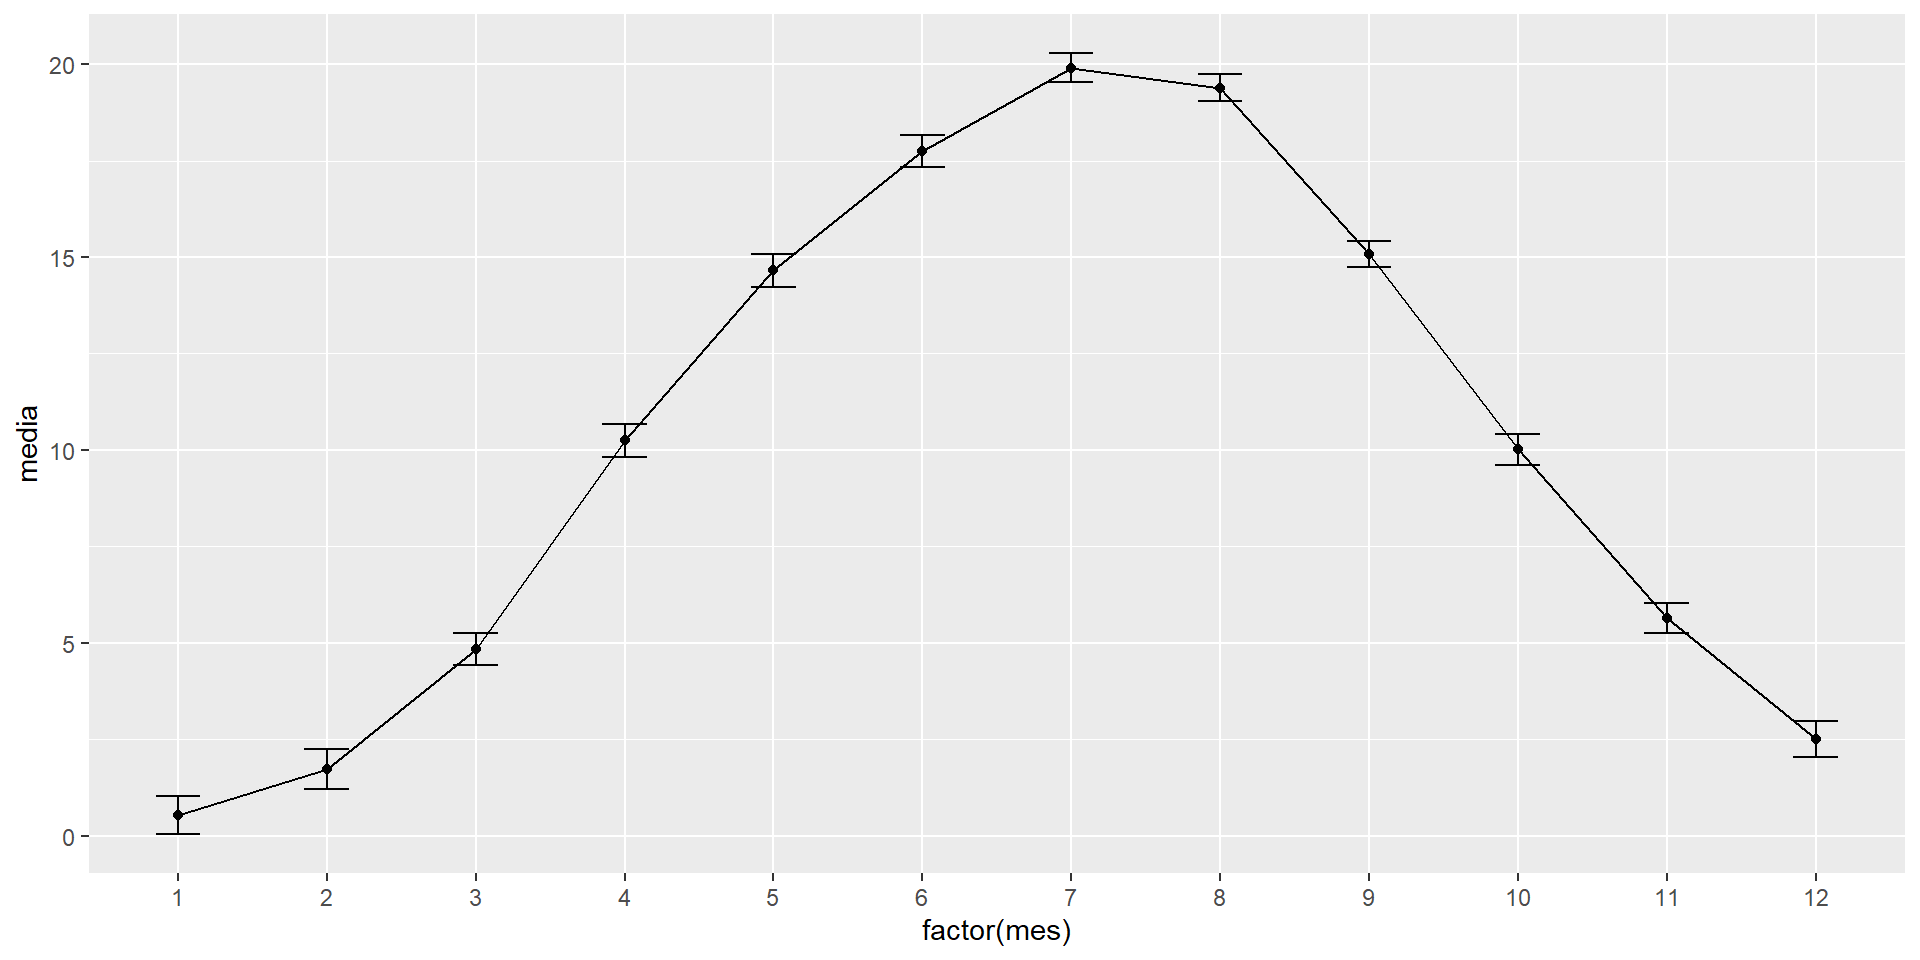
library(lubridate)
library(dplyr)
rot_berlin$mes <- month(rot_berlin$date)
rot_berlin$year <- year(rot_berlin$date)
temp_berlin <- rot_berlin %>%
group_by(mes) %>%
summarise(n = n(),
media = mean(TMK),
desv = sd(TMK),
s.err = desv/sqrt(n))
grafico3 <- ggplot(temp_berlin,
aes(x = factor(mes),
y = media,
group = 1)) +
geom_point() +
geom_line() +
geom_errorbar(aes(ymin = media - s.err,
ymax = media + s.err),
width = .3)
grafico3
ggplot2Un reto que hemos todos encontrado alguna vez es el de combinar varios gráficos en uno solo.
Esto requiere paciencia y el uso de software externo (llámese CorelDraw, Adobe Illustrator, PowerPoint o incluso Paint).
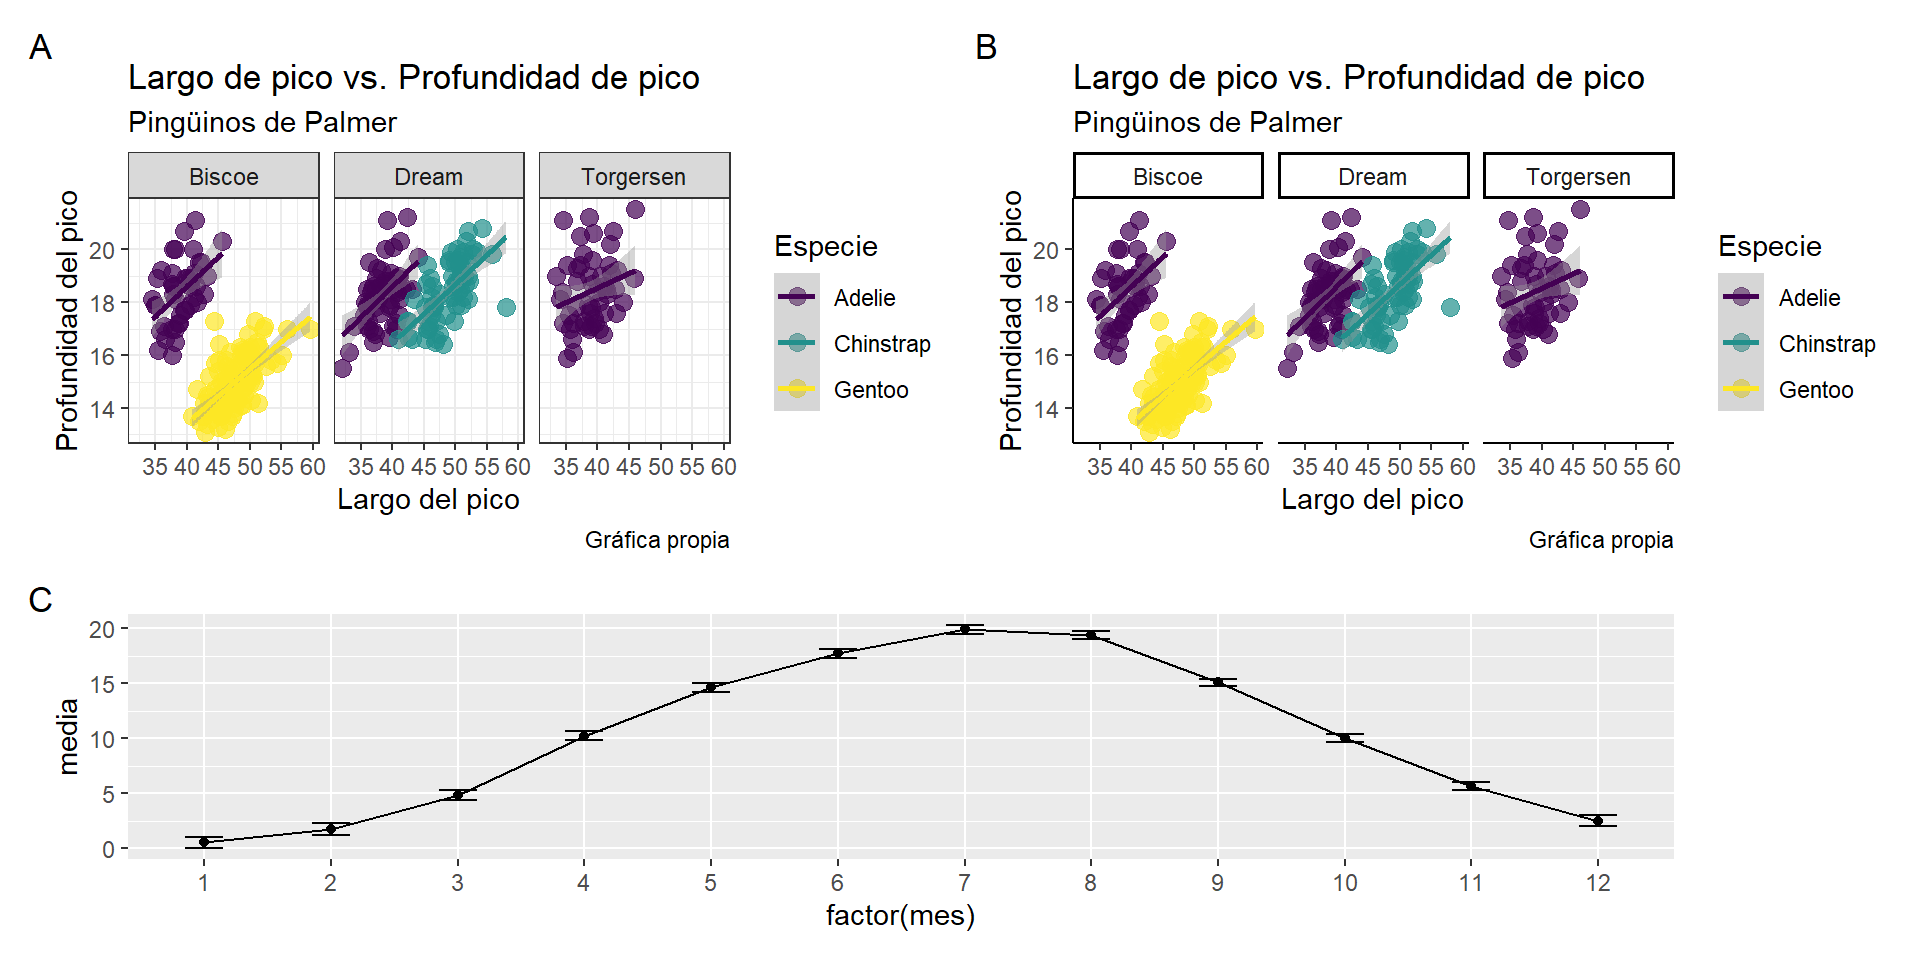
La librería complementaria patchwork nos permite combinar gráficos de ggplot2 de una manera sencilla y rápida.
Además, gracias a la función ggsave de ggplot2 podemos exportar fácilmente nuestros gráficos sin requerir (ojalá) a la ayuda de software externo para dar retoques finales a estos gráficos.
patchworkPara más información de las funciones y utilidades de patchwork puedes visitar la página oficial con su documentación y ejemplos.
ggplotExporta un objeto de ggplot2 con gráficos de tu elección (6 en total) combinados con la ayuda de patchwork en el layout que desees a formatos .png y .pdf.
Lo que hemos revisado hasta el momento, son las técnicas más frecuentemente usadas para AED.
Sin embargo, existen librerías de R que permiten también hacer AED de una manera automática y más accesible.
Como ejemplos, haremos un enfoque en dos librerías que hacen uso de Shiny para brindar esta experiencia al usuario. Estas son explore y dataxray
ggplot2: qplotggplot2: qplotggplot2: qplot